

Python操作XML文件的使用指南

本文详细介绍Python中操作XML文件的两种主要方式:xml.etree.ElementTree和xml.dom.minidom。通过具体代码示例,演示如何解析XML文件、提取元素与属性、修改节点内容以及增删节点,帮助开发者掌握Python处理XML数据的核心技能。
什么是 XML
XML(可扩展标记语言)在外观上与HTML相似,但用途不同:XML用于数据表示,而HTML用于定义数据的展示。XML专为在客户端与服务器之间传输数据而设计。以下示例展示了名为“Sample.xml”的文件内容,后续代码均基于此XML结构进行演示。
<?xml version="1.0" encoding="UTF-8"?>
<metadata>
<food>
    <item name="breakfast">Idly</item>
    <price>$2.5</price>
    <description>
   Two idly's with chutney
   </description>
    <calories>553</calories>
</food>
<food>
    <item name="breakfast">Paper Dosa</item>
    <price>$2.7</price>
    <description>
    Plain paper dosa with chutney
    </description>
    <calories>700</calories>
</food>
<food>
    <item name="breakfast">Upma</item>
    <price>$3.65</price>
    <description>
    Rava upma with bajji
    </description>
    <calories>600</calories>
</food>
<food>
    <item name="breakfast">Bisi Bele Bath</item>
    <price>$4.50</price>
    <description>
   Bisi Bele Bath with sev
    </description>
    <calories>400</calories>
</food>
<food>
    <item name="breakfast">Kesari Bath</item>
    <price>$1.95</price>
    <description>
    Sweet rava with saffron
    </description>
    <calories>950</calories>
</food>
</metadata>
上述示例展示了“Sample.xml”文件的内容,后续所有代码示例将基于此XML结构进行演示。
Python XML 解析模块
Python提供了两个用于解析XML文档的模块:xml.etree.ElementTree和Minidom(最小DOM实现)。解析是指从文件中读取信息,并通过识别XML文件的各个部分将其拆分为多个片段。接下来将详细介绍如何使用这些模块解析XML数据。
xml.etree.ElementTree 模块
该模块将XML数据格式化为树结构,这是分层数据最自然的表示形式。Element类型允许在内存中存储分层数据结构,并具备以下属性:
| Property | Description |
|---|---|
| Tag | 一个字符串,表示正在存储的数据类型 |
| Attributes | 由存储为字典的许多属性组成 |
| Text String | 包含需要显示的信息的文本字符串 |
| Tail String | 如有必要,也可以有尾弦 |
| Child Elements | 由许多存储为序列的子元素组成 |
ElementTree是一个封装元素结构并允许与XML相互转换的类。现在尝试使用Python模块解析上述XML文件。
有两种方法可以使用ElementTree模块解析文件。
第一种方法是使用parse()函数,第二种是fromstring()函数。parse()函数解析作为文件提供的XML文档,而fromstring在作为字符串提供时解析XML,即在三引号内。
使用 parse() 函数
如前所述,该函数采用文件格式的XML进行解析,请看以下示例:
import xml.etree.ElementTree as ET
mytree = ET.parse('sample.xml')
myroot = mytree.getroot()
首先需要导入xml.etree.ElementTree模块,然后使用parse()方法解析“Sample.xml”文件,getroot()方法返回“Sample.xml”的根元素。
执行上述代码时,不会看到返回的输出,但只要没有报错,表明代码已成功执行。要检查根元素,可以简单地使用print语句,如下所示:
import xml.etree.ElementTree as ET
mytree = ET.parse('sample.xml')
myroot = mytree.getroot()
print(myroot)
Output:
<Element ‘metadata’ at 0x033589F0>
上述输出表明XML文档中的根元素是“metadata”。
使用 fromstring() 函数
还可以使用fromstring()函数来解析字符串数据,需要将XML作为三引号内的字符串传递,如下所示:
import xml.etree.ElementTree as ET
data='''<?xml version="1.0" encoding="UTF-8"?>
<metadata>
<food>
    <item name="breakfast">Idly</item>
    <price>$2.5</price>
    <description>
   Two idly's with chutney
   </description>
    <calories>553</calories>
</food>
</metadata>
'''
myroot = ET.fromstring(data)
#print(myroot)
print(myroot.tag)
上述代码将返回与前一个相同的输出,用作字符串的XML文档只是“Sample.xml”的一部分,已将其用于提高可见性,也可以使用完整的XML文档。
还可以使用“tag”对象检索根标签,如下所示:
print(myroot.tag)
Output:
metadata
还可以通过仅指定要在输出中看到的字符串部分来对标记字符串输出进行切片。
print(myroot.tag[0:4])
Output:
meta
如前所述,tag也可以具有字典属性。要检查根标签是否有任何属性,可以使用“attrib”对象,如下所示:
print(myroot.attrib)
Output:
{}
可以看到,输出是一个空字典,因为根标签没有属性。
寻找感兴趣的元素
根也由子标签组成,要检索根标签的子标签,可以使用以下命令:
print(myroot[0].tag)
Output:
food
现在,如果要检索根的所有第一个子标签,可以使用for循环对其进行迭代,如下所示:
for x in myroot[0]:
     print(x.tag, x.attrib)
Output:
item {‘name’: ‘breakfast’} price {} description {} calories {}
返回的所有项目都是food的子属性和标签。
要使用ElementTree从XML中分离出文本,可以使用text属性。例如,如果想检索关于第一个食物的所有信息,应该使用以下代码:
for x in myroot[0]:
        print(x.text)
Output:
Idly $2.5 Two idly’s with chutney 553
可以看出,第一项的文本信息已作为输出返回。现在如果想以特定价格显示所有商品,可以使用get()方法,此方法访问元素的属性。
for x in myroot.findall('food'):
    item =x.find('item').text
    price = x.find('price').text
    print(item, price)
Output:
Idly $2.5 Paper Dosa $2.7 Upma $3.65 Bisi Bele Bath $4.50 Kesari Bath $1.95
上述输出显示了所有必需的项目以及每个项目的价格,使用ElementTree,还可以修改XML文件。
修改 XML 文件
XML文件中的元素是可以被操纵的,为此,可以使用set()函数。让我们先来看看如何在XML中添加一些东西。
添加到 XML:
以下示例显示了如何在项目描述中添加内容。
for description in myroot.iter('description'):
     new_desc = str(description.text)+'wil be served'
     description.text = str(new_desc)
     description.set('updated', 'yes')

mytree.write('new.xml')
write()函数有助于创建一个新的XML文件并将更新的输出写入该文件,但是也可以使用相同的功能修改原始文件。执行上述代码后,将能够看到已创建一个包含更新结果的新文件。
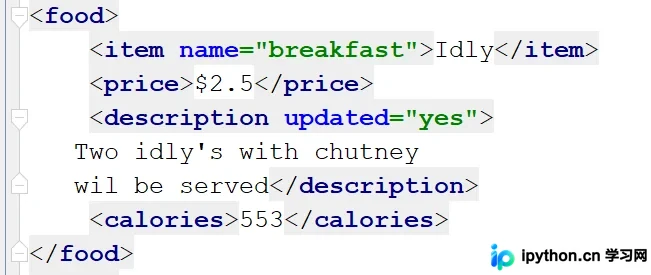
上图显示了我们食品项目的修改描述。要添加新的子标签,可以使用SubElement()方法。例如,如果想在第一项Idly中添加新的speciality标签,可以执行以下操作:
ET.SubElement(myroot[0], 'speciality')
for x in myroot.iter('speciality'):
     new_desc = 'South Indian Special'
     x.text = str(new_desc)

mytree.write('output5.xml')
Output:
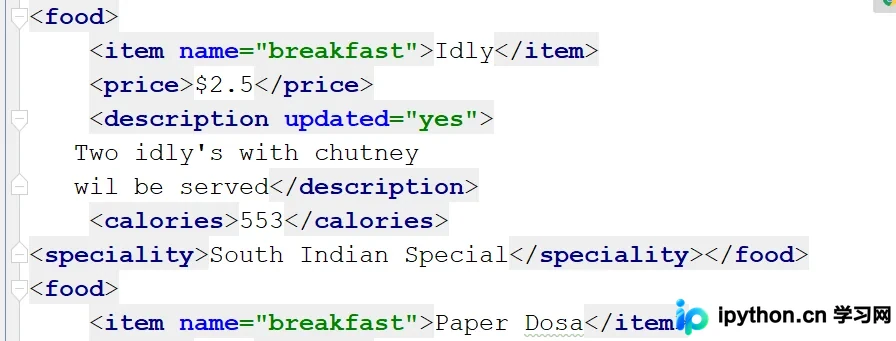
就像我们所见到的,在第一个food标签下添加了一个新标签。可以通过在[]括号内指定下标来在任意位置添加标签。
下面让我们看看如何使用这个模块删除项目。
从 XML 中删除:
要使用ElementTree删除属性或子元素,可以使用pop()方法,此方法将删除用户不需要的所需属性或元素。
myroot[0][0].attrib.pop('name', None)

# create a new XML file with the results
mytree.write('output5.xml')
Output:
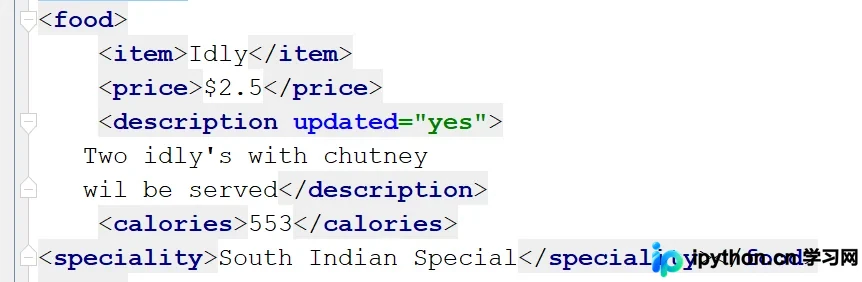
上图显示name属性已从item标签中删除。要删除完整的标签,可以使用相同的pop()方法,如下所示:
myroot[0].remove(myroot[0][0])
mytree.write('output6.xml')
Output:
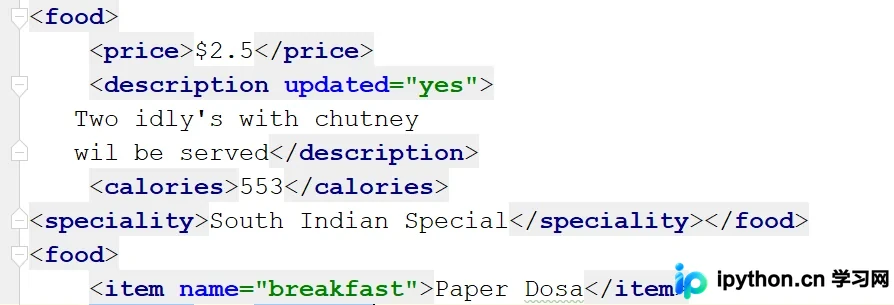
输出显示food标签的第一个子元素已被删除。如果要删除所有标签,可以使用clear()函数,如下所示:
myroot[0].clear()
mytree.write('output7.xml')
执行上述代码时,food标签的第一个子标签将被完全删除,包括所有子标签。
到目前为止,我们一直在使用Python XML解析器中的xml.etree.ElementTree模块。现在让我们看看如何使用Minidom解析XML。
xml.dom.minidom Module
该模块基本上是由精通DOM(文档对象模型)的人使用的,DOM应用程序通常首先将XML解析为DOM。在xml.dom.minidom中,可以通过以下方式实现
使用 parse() 函数:
第一种方法是通过提供要解析的XML文件作为参数来使用parse()函数。例如:
from xml.dom import minidom
p1 = minidom.parse("sample.xml")
执行此操作后,将能够拆分XML文件并获取所需的数据。还可以使用此函数解析打开的文件。
dat=open('sample.xml')
p2=minidom.parse(dat)
在这种情况下,存储打开文件的变量作为参数提供给parse函数。
使用 parseString() 方法:
当我们想要提供要作为字符串解析的XML时使用此方法。
p3 = minidom.parseString('<myxml>Using<empty/> parseString</myxml>')
可以使用上述任何方法解析XML,现在让我们尝试使用这个模块获取数据
寻找感兴趣的元素
在文件被解析后,如果我们尝试打印它,返回的输出会显示一条消息,即存储解析数据的变量是DOM的对象。
dat=minidom.parse('sample.xml')
print(dat)
Output:
<xml.dom.minidom.Document object at 0x03B5A308>
使用 GetElementsByTagName 访问元素
tagname= dat.getElementsByTagName('item')[0]
print(tagname)
如果我们尝试使用GetElementByTagName方法获取第一个元素,将看到以下输出:
<DOM Element: item at 0xc6bd00>
请注意,只返回了一个输出,因为为方便起见,这里使用了[0]下标,这将在进一步的示例中被删除。
要访问属性的值,我们将不得不使用value属性,如下所示:
dat = minidom.parse('sample.xml')
tagname= dat.getElementsByTagName('item')
print(tagname[0].attributes['name'].value)
Output:
breakfast
要检索这些标签中存在的数据,可以使用data属性,如下所示:
print(tagname[1].firstChild.data)
Output:
Paper Dosa
还可以使用value属性拆分和检索属性的值。
print(items[1].attributes['name'].value)
Output:
breakfast
要打印出菜单中的所有可用项目,可以遍历这些项目并返回所有项目。
for x in items:
    print(x.firstChild.data)
Output:
Idly Paper Dosa Upma Bisi Bele Bath Kesari Bath
要计算菜单上的项目数,可以使用len()函数,如下所示:
print(len(items))
Output:
5
输出指定我们的菜单包含 5 个项目。
到此这篇关于Python操作XML文件的使用指南的文章就介绍到这了,更多相关Python操作XML内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









