

Python提取PDF表格数据实战:pdfplumber库使用指南
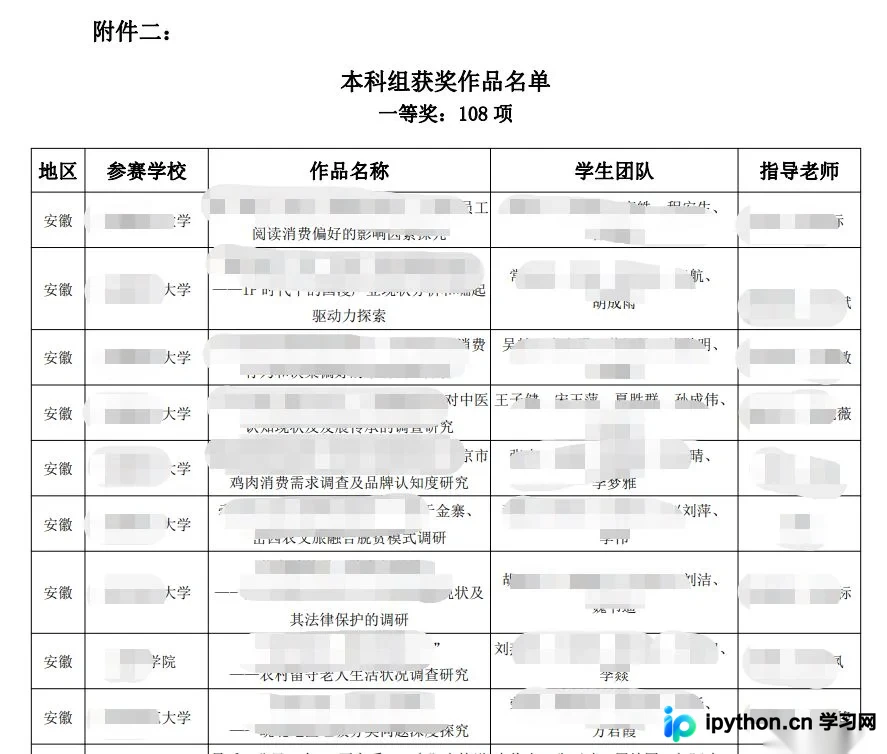
本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
2026-10-16
9

本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
本文深入解析 Keras 中 metrics 模块的源码实现,重点对比有状态(stateful)与无状态(stateless)度量的区别。以 tf.keras.metrics.Mean 为例,详解 total、count 及 update_state 等核心方法的运作机制,并展示如何继承 Metric 类创建自定义有状态指标,以及利用 Layer 的 add_metric 方法记录层统计信息。
本文详细介绍Python第三方库easydict的安装与核心用法。通过示例展示如何将字典转换为EasyDict对象,实现类似类成员属性的便捷访问方式。内容涵盖新增元素、更新字典、转换为普通字典以及处理JSON和YAML配置文件等实际场景,帮助开发者简化字典操作。
本文深入解析Python中字典和集合的核心概念与使用方法。详细讲解字典的定义、键值对特性及clear、get、pop等常用方法,涵盖元素的添加、修改与删除操作。同时介绍集合的无序可变特性,演示add、update、discard等元素管理方法,并对比union、intersection等集合运算符号与函数的区别,帮助开发者掌握高效的数据处理技巧。
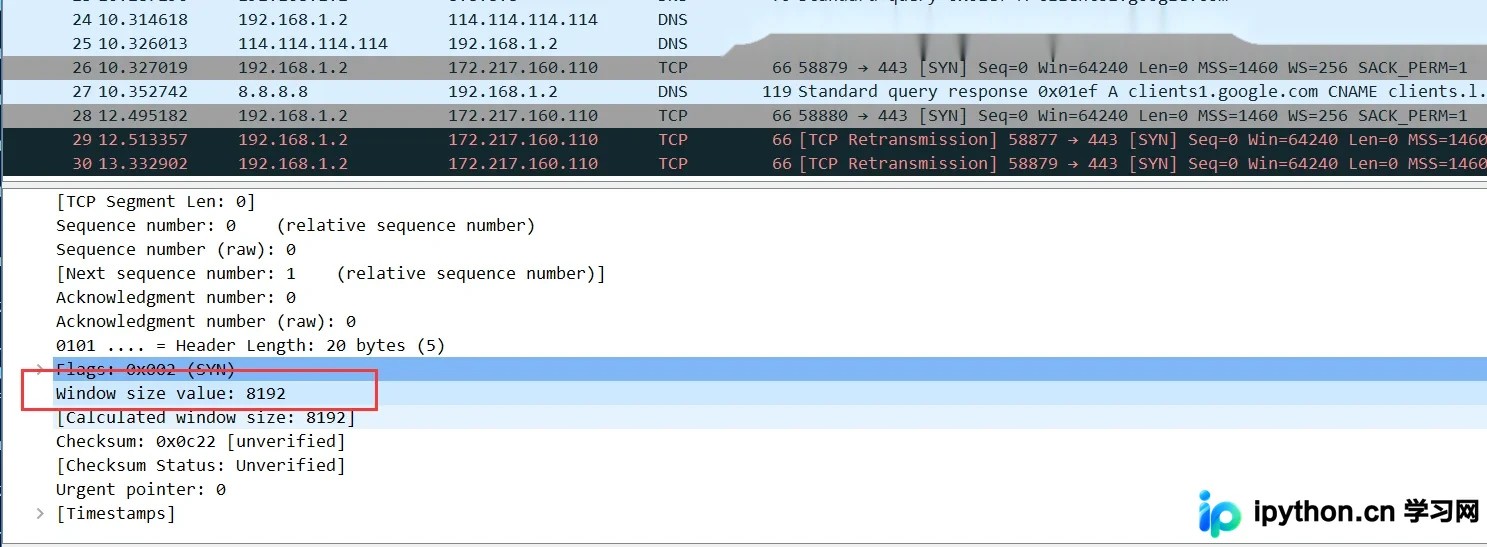
本文详解Python实现的SockStress全连接攻击原理,通过建立完整TCP连接并设置窗口为0耗尽目标资源。提供基于Scapy的源码分析、编译运行步骤及多线程封装用法,并给出使用iptables限制连接数的有效防御方案,适用于Linux环境下的安全测试与防护实践。
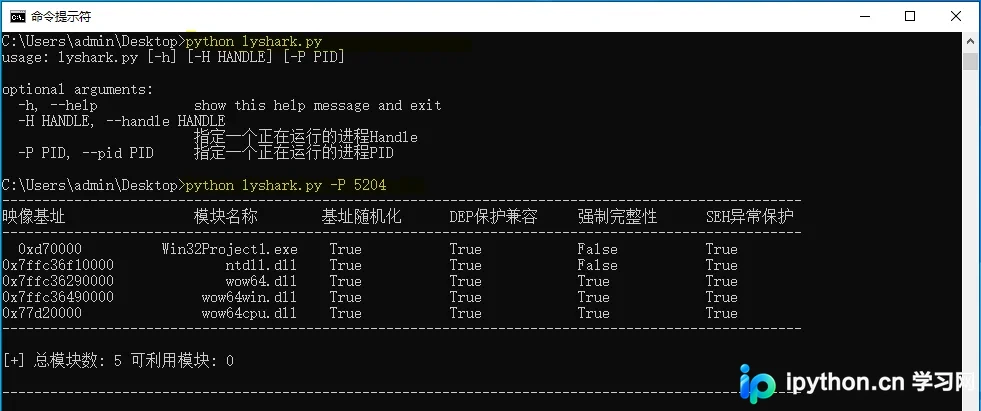
本文介绍如何使用Python结合pywin32与pefile库,通过Windows API枚举指定进程加载的DLL模块,并深入分析各模块启用的安全保护机制。文章提供了完整的依赖安装、命令行参数配置及核心检测代码示例,帮助开发者掌握PE文件保护状态的自动化检测方法。
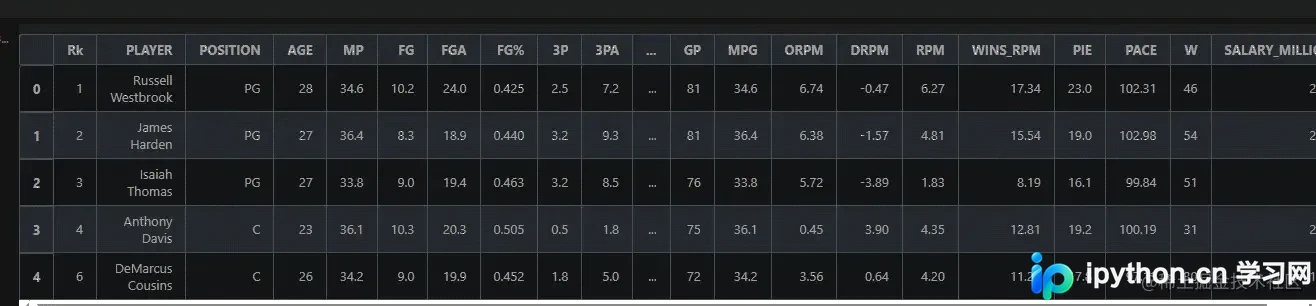
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
本文详细介绍如何使用Python通过pymongo库操作MongoDB数据库。内容涵盖从环境配置到实际代码实现,包括插入单个或批量文档、指定ID插入、查询单条或所有数据、按条件及修饰符筛选、限制返回数量、修改记录、排序结果以及删除文档和集合的完整操作流程。
本文详细解析OpenCV中图像轮廓的提取、绘制及特征计算方法。涵盖findContours函数的检索模式与逼近方法,演示如何绘制指定索引轮廓,并深入讲解面积、周长、边界矩形及外接圆等几何特征的获取与计算,提供完整的Python代码示例。
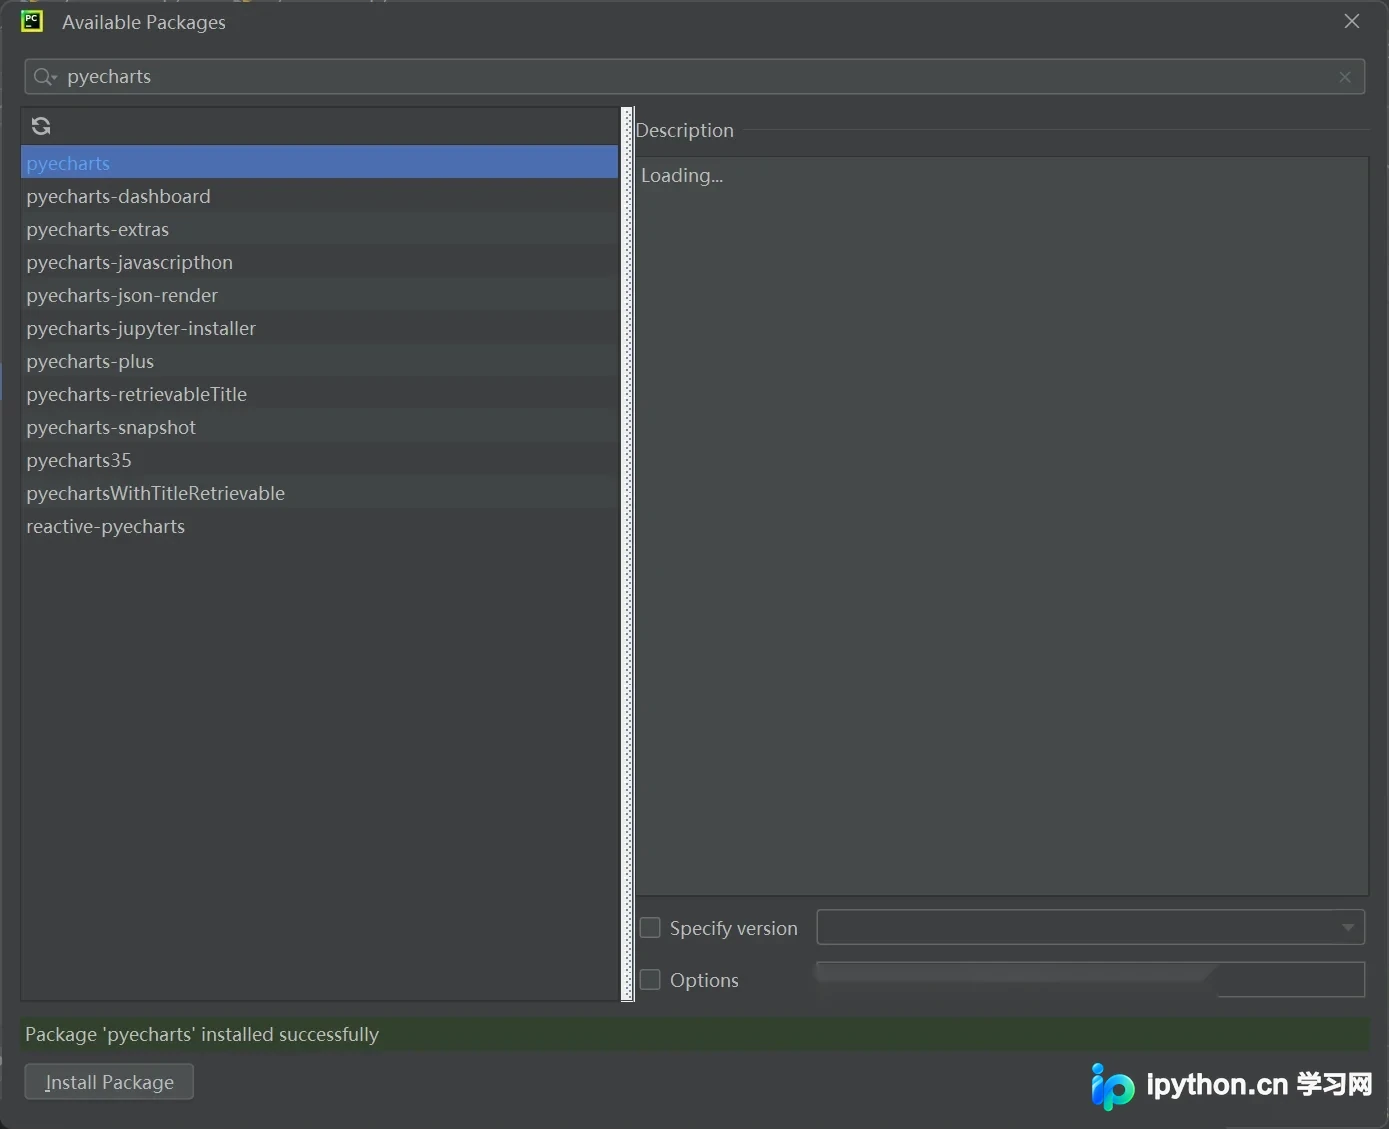
本文介绍 Python 中 pyecharts 模块的安装方法及基础使用。pyecharts 是基于百度 Echarts 的可视化库,适合数据处理场景。文章涵盖 pip 安装步骤、基础折线图代码示例(含导包、数据添加、渲染)以及全局配置选项 set_global_opts 的使用,帮助开发者快速上手。
本文详细介绍Python标准库中queue模块的四种队列类型:先进先出(FIFO)、后进先出(LIFO)、优先级队列及SimpleQueue。重点解析Queue、LifoQueue和PriorityQueue对象的常用方法,包括put/get操作、block与timeout参数控制、qsize/empty/full状态判断,以及task_done和join的任务追踪机制,帮助开发者掌握并发编程中的队列应用。
本文深入解析Python中os.path.pardir的使用陷阱,特别是os.path.abspath(".")与工作目录的关系。同时系统介绍os.path模块常用方法,包括dirname、listdir、filter、sep、join及splitext等函数的具体用法与注意事项,帮助开发者避免路径错误。