

详解从Django Rest Framework响应中删除空字段
本文介绍如何在Django Rest Framework中通过重写序列化器的to_native或to_representation方法,自动过滤API响应中的null和空字符串字段。针对DRF不同版本提供了具体代码示例,帮助开发者生成更简洁的JSON数据。
2026-10-13
9

本文介绍如何在Django Rest Framework中通过重写序列化器的to_native或to_representation方法,自动过滤API响应中的null和空字符串字段。针对DRF不同版本提供了具体代码示例,帮助开发者生成更简洁的JSON数据。
本文介绍如何使用Python批量读取包含绝对路径的图像列表,依次进行图像处理,并将结果保存至指定目录。通过读取txt文件获取图像路径,利用Caffe加载图像,处理后使用matplotlib保存至预设文件夹,并统计处理耗时与平均时间,适用于需要批量处理图像的场景。
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
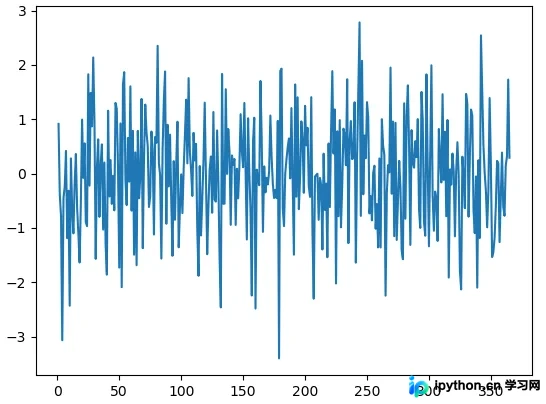
本文介绍Python中使用Pywavelet库进行小波去噪的方法。重点解析pywt.threshold函数的四个参数:数据、阈值、模式(soft/hard/greater/less)及替代值。通过具体代码示例,展示不同模式下数值替换与处理的逻辑差异,帮助开发者快速掌握小波阈值处理的核心机制。
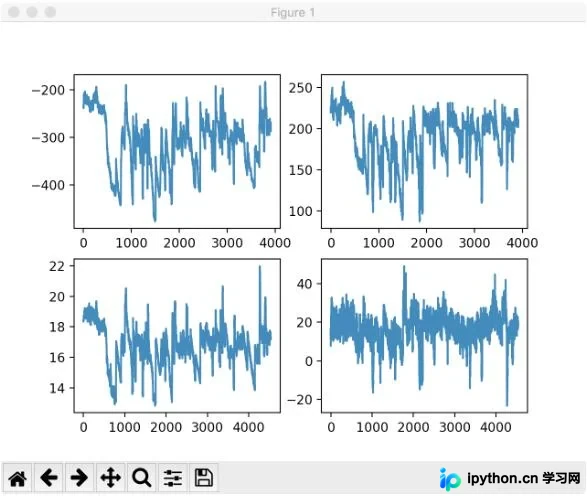
本文详细对比了Python中两种提取MFCC特征的常用库:Librosa与python_speech_features。重点解析了两者返回数组的形状差异,即Librosa返回(13, None),而python_speech_features返回(None, 13)需转置。通过代码示例与可视化结果,展示了两者在mfcc[0]和mfcc[1]上的具体区别,帮助开发者根据需求选择合适的工具。
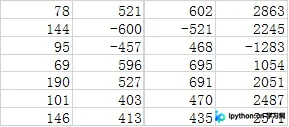
本文详解Python中数据预处理的规范化技术,旨在消除量纲差异。通过Pandas库实现最小-最大规范化与零-均值规范化两种核心方法,提供完整代码示例及Excel数据源下载,帮助开发者掌握数据缩放技巧,提升模型分析效果。
本文介绍Python中查找最小K个数的两种解法。解法1利用Partition函数,平均时间复杂度为O(N),但会改变原数组顺序。解法2采用最大堆维护K个元素,时间复杂度为N*O(logK),适合处理海量数据且保持原数组不变。通过代码示例对比了两种方法的运行时间与内存占用,解法2在性能上更优。
本文介绍在Python中调用外部命令时捕获输出流的两种常见方式。通过对比os.system与commands.getstatusoutput,分析它们在返回执行状态码及获取详细提示信息方面的差异,帮助开发者选择合适的方法来处理编译或脚本执行过程中的错误日志。
在Shell脚本中调用Python程序时,常遇到print输出被缓冲导致无法实时获取的问题。本文解析了Python print与sys.stdout.write的关系,通过调用sys.stdout.flush()强制刷新缓冲区,实现了Shell对Python长耗时任务输出流的实时捕获,确保日志追踪的即时性。
本文介绍在 Python 中执行 Shell 命令并获取输出结果的三种方式。首先分析内置模块 os.system 的局限性,仅能返回退出状态码;接着演示使用 subprocess 模块通过 Popen 和管道捕获标准输出的方法;最后探讨第三方库 sh 的高级用法,包括命令映射、参数处理及超时控制,并提供解决复杂命令调用的替代方案。
本文详细介绍如何在 Django xadmin 中实现自定义侧边栏菜单及折叠功能。通过编写 GlobalSetting 类定义菜单结构,利用 xsite.py 配置折叠样式,并在 settings.py 中引入配置,即可完成后台界面的个性化定制。
本文介绍如何使用Python将Shapefile(.shp)文件转换为GeoJSON格式。通过shapefile库读取数据,处理字段编码(如gb2312),并将几何对象与属性映射为FeatureCollection。提供完整代码示例,适用于GIS数据格式转换场景。