

Python中提取MFCC特征的两种主流库对比:Librosa与python_speech_features

本文详细对比了Python中两种提取MFCC特征的常用库:Librosa与python_speech_features。重点解析了两者返回数组的形状差异,即Librosa返回(13, None),而python_speech_features返回(None, 13)需转置。通过代码示例与可视化结果,展示了两者在mfcc[0]和mfcc[1]上的具体区别,帮助开发者根据需求选择合适的工具。
在Python中进行音频处理时,提取梅尔频率倒谱系数(MFCC)是常见需求。目前主要有两种常用的库可以实现这一功能:Librosa和python_speech_features。
import librosa
filepath = "/Users/birenjianmo/Desktop/learn/librosa/mp3/in.wav"
y,sr = librosa.load(filepath)
mfcc = librosa.feature.mfcc( y,sr,n_mfcc=13 )
使用Librosa库时,其返回的MFCC数据结构为一个NumPy数组,形状为(13, None)。这里的13代表提取了13个MFCC系数,而None表示该维度可以是任意数量的时间帧,具体取决于输入音频的长度。
另一种选择是使用python_speech_features库。该库提供的mfcc函数在默认情况下返回的形状为(None, 13)。这意味着第一维是时间帧数,第二维是系数数量。
from python_speech_features import mfcc as pmfcc
filepath = "/Users/birenjianmo/Desktop/learn/librosa/mp3/in.wav"
(rate,sig) = wav.read(filepath)
amfcc = pmfcc( sig, rate ).T
为了与Librosa的输出格式保持一致,或者为了后续处理方便,可以使用转置操作(.T)将python_speech_features返回的(None, 13)数组转换为(13, None)的形状。
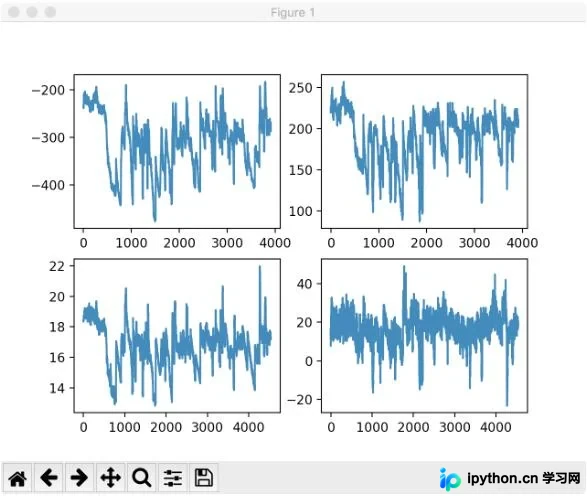
尽管两种方法都能提取MFCC,但它们在具体实现和结果上存在明显差异。通过对比可视化结果可以看出:上方子图展示的是从Librosa提取的mfcc[0]和mfcc[1],而下方子图展示的是从python_speech_features提取并转置后的amfcc[0]和amfcc[1]。两者在数值分布和细节上有所不同,开发者需根据实际应用场景进行选择。
以上关于Python中两种MFCC提取方式的详细对比就是全部内容。希望这些信息能帮助开发者更好地理解和应用这两种工具,如有更多疑问欢迎继续支持相关技术社区。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









