

Python 编码规范整理
本文系统整理了 Python 编码规范,涵盖代码编排、文档、空格使用、注释及命名规则。重点讲解缩进标准、行长度限制、模块导入顺序、变量与函数命名约定,以及异常处理和序列操作的性能优化建议,旨在提升代码可读性与维护性。
2026-10-13
19

本文系统整理了 Python 编码规范,涵盖代码编排、文档、空格使用、注释及命名规则。重点讲解缩进标准、行长度限制、模块导入顺序、变量与函数命名约定,以及异常处理和序列操作的性能优化建议,旨在提升代码可读性与维护性。
本文探讨Python3中使用numpy的loadtxt函数读取数据时,结果字符串前出现'B'字符的编码问题。通过指定dtype=bytes并转换为str,可有效解决Python2与Python3在字符串处理上的差异,确保数据正确加载。
本文介绍使用Python Requests库模拟登录图书馆预约系统,通过获取Cookie和隐藏表单字段构造POST请求实现自动预约。结合Crontab定时任务与邮件模块,实现每日自动抢座并发送结果提醒,适用于高校图书馆座位管理系统。
本文深入解析TensorFlow中的核心损失函数,涵盖分类问题的交叉熵与回归问题的均方误差。详细讲解tf.nn.softmax_cross_entropy_with_logits等API的使用细节,并通过销量预测案例演示如何根据成本与利润差异自定义损失函数,帮助开发者优化模型训练效果。
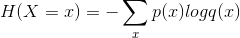
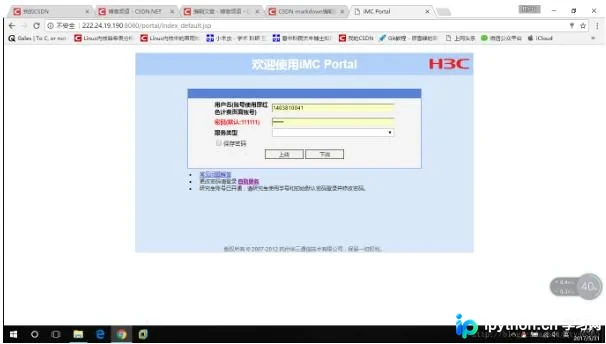
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文详细解析Python中正则表达式的贪婪与非贪婪匹配机制,通过re.findall示例对比\d+与\d+?的差异。同时深入讲解多行匹配场景,说明如何运用re.S使点号匹配换行符,以及利用re.M让^和$符号作用于每一行,帮助开发者精准控制正则匹配行为。
本文介绍使用Python标准库xlrd和xlwt处理Excel文件的去重与求和方法。通过读取指定列数据,利用字典结构对小区名称进行分组,分别累加总端口数与已使用端口数,最终生成新的Excel文件。该方法适用于需要合并重复项并统计数值的基础数据处理场景。
本文深入解析NumPy数组切片中冒号(:)与负号(-1)的核心作用。冒号用于选取当前维度的所有子模块,而负号表示从后往前计数,-1特指最后一个元素。通过具体代码示例,展示如何结合两者进行多维数组的精准索引与数据提取,帮助开发者避免维度混淆,提升数据处理效率。
本文深入解析Python 2.5引入的上下文管理器机制,阐述其在文件与数据库等资源管理中的必要性。通过对比传统try...except与with语句,展示代码简洁性优势。详细讲解__enter__和__exit__方法的执行流程,并介绍利用contextlib装饰器简化上下文管理器实现的技巧,帮助开发者掌握自动资源清理的最佳实践。
本文提供了一段使用Python编写的TCP监听端完整代码。通过socket模块建立连接,利用struct处理数据头,实现了持续接收数据并解析线程ID与错误码的功能。代码包含异常处理机制,支持通过命令行参数指定监听端口,适用于需要稳定监听服务端口的Python开发场景。
本文介绍在Python中利用NumPy库快速合并多个矩阵或数组的方法。内容涵盖纵向合并(vstack、r_)与横向合并(hstack、c_)两种核心操作,通过具体代码示例展示如何高效实现数组的行与列拼接,适用于数据处理与科学计算场景。
本文介绍在pandas中如何对指定列进行数据填充。通过选取特定列并使用ffill()方法,可实现向下填充缺失值。示例展示了仅对X和Y列执行前向填充,而Z列保持不变的操作过程及结果。