

pandas中apply函数的核心用法与操作对象解析
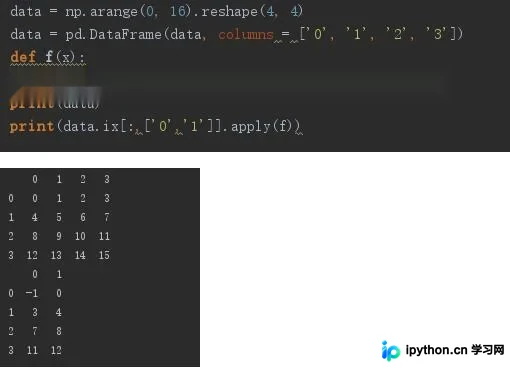
本文详细解析pandas库中apply函数的核心用法。该函数支持对DataFrame对象进行灵活操作,既可按行或按列处理元素,也能针对单个元素执行自定义逻辑。通过具体示例展示列元素、行元素及整体列/行的应用方式,帮助开发者掌握高效的数据处理技巧。
2026-10-13
19

本文详细解析pandas库中apply函数的核心用法。该函数支持对DataFrame对象进行灵活操作,既可按行或按列处理元素,也能针对单个元素执行自定义逻辑。通过具体示例展示列元素、行元素及整体列/行的应用方式,帮助开发者掌握高效的数据处理技巧。
本文介绍在Python中利用NumPy库将二维数组转换为列表,并通过remove方法移除特定索引元素后重新转换回数组的完整流程。代码展示了u.tolist()的使用及np.array()的重构,适用于需要灵活处理数组结构并剔除特定数据的场景。
本文介绍在 Python 2.7 环境中无法直接使用 pip 时的解决方案。通过执行 ez_setup.py 脚本安装 easy_install,进而利用 easy_install 命令安装 pip,最后配置环境变量使 pip 全局可用,从而恢复插件安装功能。
本文介绍如何使用Python的Pillow库对图片进行自动切片处理。通过pip安装Pillow模块后,利用Image类的crop方法结合循环逻辑,可将源图像均匀分割为指定行列数量的子图像。文中提供了完整的Python代码示例,涵盖目录创建、坐标计算及文件保存步骤,适用于需要批量处理图像区域的场景。
本文介绍如何利用Python的xlsxwriter库将数据写入Excel文件。内容涵盖库的安装、工作簿与工作表的创建、单元格格式(如粗体)设置、数据写入方法,以及动态图表的生成与插入。通过完整代码示例,展示从基础数据录入到复杂图表绘制的完整流程,适用于需要自动化处理Excel文件的开发场景。
本文介绍利用Python的wxpy和wechat_sender库,实现微信每日定时向指定好友发送金山词霸每日一句及晚安祝福。通过服务器后台常驻运行,避免频繁扫码登录,展示自动化脚本的核心逻辑与配置方法。
本文介绍Python中如何使用命名元组(namedtuple)将名称映射到序列元素,从而减少对位置索引的依赖。通过对比普通元组,展示namedtuple在提高代码可读性方面的优势,并详解其不可变性、_replace方法的使用及处理可选字段的技巧。
本文介绍如何在 Python 中定义带参数的装饰器,用于在函数调用时自动检查传入参数的类型。通过 inspect 模块获取函数签名,将装饰器指定的类型参数与函数实参进行绑定比对,若类型不匹配则抛出 TypeError 异常,从而提升代码的健壮性。
本文深入解析冒泡排序的核心思想,通过逐步演示五个数字的排序过程,阐明n个数需比较n-1轮的逻辑。随后提供两种Python实现方案:一是基于双重循环的常规冒泡排序,分析其O(N^2)的时间复杂度;二是利用Python内置sorted()函数快速完成排序,展示简洁代码的优势与适用场景。
本文系统讲解Django中Model的核心用法,涵盖CharField、ForeignKey等常用字段类型及参数配置,详解auto_now与default的时间处理差异。通过重写delete与save方法实现软删除与数据预处理,并深入解析create、get_or_create、update_or_create及filter链式查询等高频API,结合Q对象实现复杂搜索逻辑,助力开发者高效构建数据模型。
本文介绍Python中三种基础的距离测量方式:欧式距离、街区距离和棋盘距离。详细解析了各自的数学公式及其在路径规划(如A*算法)中的应用场景,并通过Python代码示例直观展示不同距离度量生成的几何区域形状,帮助开发者理解距离概念在算法中的实际作用。
本文深入解析Python logging模块的核心组件,包括Logger、Formatter、Handler及Filter的作用与配置方法。详细阐述日志等级数值与名称映射机制,演示如何通过配置文件实现个性化日志输出,并提供封装好的Logger工具类代码。同时指出logging模块在多线程环境下的安全性及多进程写日志的潜在风险,帮助开发者构建稳定可靠的日志系统。