

TensorFlow损失函数详解:交叉熵、MSE与自定义实现

本文深入解析TensorFlow中的核心损失函数,涵盖分类问题的交叉熵与回归问题的均方误差。详细讲解tf.nn.softmax_cross_entropy_with_logits等API的使用细节,并通过销量预测案例演示如何根据成本与利润差异自定义损失函数,帮助开发者优化模型训练效果。
一、分类问题损失函数——交叉熵(crossentropy)
交叉熵用于衡量两个概率分布之间的差异,是分类任务中最常用的损失函数。假设有两个概率分布p和q,交叉熵描述了基于分布q来编码分布p所需的平均信息量,即两者之间的距离。
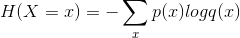
在神经网络中,通常通过Softmax回归将前向传播输出的原始得分转化为符合交叉熵计算要求的概率分布。在TensorFlow框架中,Softmax回归不再作为独立的参数层存在,而是作为一个后处理步骤,将神经网络的输出 logits 转换为概率分布。
代码实现:
import tensorflow as tf

y_ = tf.constant([[1.0, 0, 0]]) # 正确标签
y1 = tf.constant([[0.9, 0.06, 0.04]]) # 预测结果1
y2 = tf.constant([[0.5, 0.3, 0.2]]) # 预测结果2
# 以下为未经过Softmax处理的类别得分
y3 = tf.constant([[10.0, 3.0, 2.0]])
y4 = tf.constant([[5.0, 3.0, 1.0]])

# 自定义交叉熵
cross_entropy1 = -tf.reduce_mean(y_ * tf.log(tf.clip_by_value(y1, 1e-10, 1.0)))
cross_entropy2 = -tf.reduce_mean(y_ * tf.log(tf.clip_by_value(y2, 1e-10, 1.0)))
# TensorFlow提供的集成交叉熵
# 注:该操作应该施加在未经过Softmax处理的logits上,否则会产生错误结果
# labels为期望输出,且必须采用labels=y_, logits=y的形式将参数传入
cross_entropy_v2_1 = tf.nn.softmax_cross_entropy_with_logits(labels=y_, logits=y3)
cross_entropy_v2_2 = tf.nn.softmax_cross_entropy_with_logits(labels=y_, logits=y4)

sess = tf.InteractiveSession()
print('[[0.9, 0.06, 0.04]]:', cross_entropy1.eval())
print('[[0.5, 0.3, 0.2]]:', cross_entropy2.eval())
print('v2_1', cross_entropy_v2_1.eval())
print('v2_2',cross_entropy_v2_2.eval())
sess.close()

'''''
[[0.9, 0.06, 0.04]]: 0.0351202
[[0.5, 0.3, 0.2]]: 0.231049
v2_1 [ 0.00124651]
v2_2 [ 0.1429317]
'''
tf.clip_by_value()函数用于将Tensor中的元素值限制在指定的上下界范围内。这一操作主要用于数值稳定性检查,防止因数值过大或过小导致的计算错误(如对零取对数)。
注意区分乘法操作符与矩阵乘法。元素级乘法(如*)是指两个Tensor中对应位置的元素直接相乘,这与tf.matmul()执行的矩阵乘法有本质区别。
tf.nn.softmax_cross_entropy_with_logits(labels=y_,logits=y)是TensorFlow提供的集成交叉熵计算函数。该函数必须作用于未经过Softmax处理的logits上,若输入已处理过的概率值会导致结果错误。参数labels代表期望输出,调用时必须严格遵循labels=y_, logits=y3的形式传入参数。
二、回归问题损失函数——均方误差(MSE,mean squared error)
均方误差同样可用于分类任务,其数学定义为预测值与真实值之差的平方的均值。
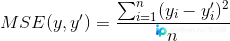
三、自定义损失函数
对于标准的分类和回归问题,交叉熵或MSE通常足够。但在实际业务场景中,理想的损失函数可能无法准确反映业务代价。以产品销量预测为例,虽然形式上是回归问题,可使用MSE,但实际损失分布并不对称:当预测值高于实际值时,损失应与商品成本成正比(库存积压);当预测值低于实际值时,损失应与商品利润成正比(销售机会损失)。由于成本与利润往往不对等,需采用自定义损失函数来平衡优化方向。
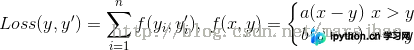
在TensorFlow中,可通过以下代码实现上述逻辑:loss= tf.reduce_sum(tf.where(tf.greater(y, y_), (y-y_)*loss_more,(y_-y)*loss_less))。
tf.greater(x,y)返回一个布尔型Tensor,表示x是否大于y。当x和y维度不一致时,TensorFlow会自动应用广播(broadcasting)机制进行扩展匹配。
tf.where(condition,x=None, y=None, name=None)根据condition的真假,从x(真)或y(假)中选择元素组成结果Tensor。
代码实现:
import tensorflow as tf
from numpy.random import RandomState

batch_size = 8
x = tf.placeholder(tf.float32, shape=(None, 2), name='x-input')
y_ = tf.placeholder(tf.float32, shape=(None, 1), name='y-input')

w1 = tf.Variable(tf.random_normal([2,1], stddev=1, seed=1))
y = tf.matmul(x, w1)

# 根据实际情况自定义损失函数
loss_less = 10
loss_more = 1
# tf.select()在1.0以后版本中已删除,tf.where()替代
loss = tf.reduce_sum(tf.where(tf.greater(y, y_),
        (y-y_)*loss_more, (y_-y)*loss_less))
train_step = tf.train.AdamOptimizer(learning_rate=0.001).minimize(loss)

rdm = RandomState(seed=1) # 定义一个随机数生成器并设定随机种子
dataset_size = 128
X = rdm.rand(dataset_size, 2)
Y = [[x1 + x2 +rdm.rand()/10.0 - 0.05] for (x1, x2) in X] # 增加一个-0.05~0.05的噪声

sess = tf.InteractiveSession()
tf.global_variables_initializer().run()
for i in range(5000):
 start = (i * batch_size) % dataset_size
 end = min(start+batch_size, dataset_size)
 train_step.run({x: X[start: end], y_: Y[start: end]})
 if i % 500 == 0:
  print('step%d:\n' % i, w1.eval())
print('final w1:\n', w1.eval())
sess.close()

'''''
loss_less = 10
loss_more = 1
final w1:
 [[ 1.01934695]
 [ 1.04280889]]

loss_less = 1
loss_more = 10
final w1:
 [[ 0.95525807]
 [ 0.9813394 ]]

loss_less = 1
loss_more = 1
final w1:
 [[ 0.9846065 ]
 [ 1.01486754]]
'''
从程序输出结果可见:当设置loss_less=10时,表明模型对预测值偏小(低估销量)的惩罚更重,优化后的参数w1均值略大于1;当设置loss_more=10时,表明对预测值偏大(高估销量)的惩罚更重,优化后的参数w1均值略小于1;当两者均设为1时,参数w1均值约等于1。
四、TensorFlow的Cross_Entropy实现
1. tf.nn.softmax_cross_entropy_with_logits(_sentinel=None,labels=None, logits=None, dim=-1, name=None)
该函数的主要功能是自动计算未经过Softmax处理的logits与真实标签labels之间的交叉熵。
调用此函数时,必须确保输入的是未经过Softmax处理的logits,否则计算结果将不正确。参数labels表示期望的输出分布,调用时必须采用labels=y_,logits=y3的形式明确传入参数。
第一个参数logits代表神经网络最后一层的原始输出。若存在batch,其形状为[batchsize,num_classes];若为单样本,形状为[num_classes]。
第二个参数labels表示实际的标签数据,其形状需与logits保持一致。
注意:如果labels的每一行采用one-hot编码(即仅有一个类别为1,其余为0),建议使用tf.sparse_softmax_cross_entropy_with_logits()以提高效率。
警告:(1)该操作内部的logits输入必须是未经缩放的原始得分,函数内部会自动执行Softmax操作;(2)参数labels和logits必须具有相同的形状[batch_size, num_classes],且数据类型必须一致(float16、float32或float64中的一种)。
该函数的具体执行过程分为两步:首先对输入的logits执行Softmax归一化。
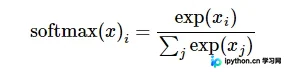
第二步是将Softmax输出的概率分布与样本的真实标签labels计算交叉熵。
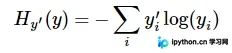
注意!!!该函数的返回值不是一个标量,而是一个向量。若需计算总的交叉熵,需进一步执行tf.reduce_sum操作对所有元素求和;若需计算损失值loss,则应执行tf.reduce_mean操作求取向量均值。
2. tf.nn.sparse_softmax_cross_entropy_with_logits(_sentinel=None,labels=None, logits=None, name=None)
该函数与tf.nn.softmax_cross_entropy_with_logits(_sentinel=None,labels=None, logits=None, dim=-1, name=None)高度相似,主要区别在于labels的格式。此函数要求labels是稀疏编码,即每个样本仅有一个正确类别,labels形状为[batch_size],值必须是int32或int64类型的整数,范围在[0, num_class)之间,这与前者要求的[batchsize,num_classes]格式的one-hot编码不同。
其他使用注意事项可参考tf.nn.softmax_cross_entropy_with_logits的相关说明。
3. tf.nn.sigmoid_cross_entropy_with_logits(_sentinel=None,labels=None, logits=None, name=None)
sigmoid_cross_entropy_with_logits是TensorFlow早期实现的交叉熵算法。其输入为logits和labels,其中logits对应神经网络中的W * X矩阵输出,无需经过sigmoid激活。labels的形状需与logits相同,表示正确的标签值。例如,若模型需判断100张图是否包含10种动物,输入shape均为[100, 10]。该函数适用于多目标(多标签)分类场景,即各个分类之间相互独立且不互斥,标签值可以是多个1或多个0的组合。
4. tf.nn.weighted_cross_entropy_with_logits(targets, logits, pos_weight, name=None)
weighted_sigmoid_cross_entropy_with_logits是sigmoid_cross_entropy_with_logits的扩展版本,额外支持pos_weight参数。在传统基于sigmoid的交叉熵计算基础上,该函数允许对正样本的计算结果乘以特定的权重系数,以处理类别不平衡问题。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









