

Python实现文件分割与合并的完整代码示例
本文介绍如何使用Python实现大文件的分割与合并功能。通过定义FileOperationBase类,利用splitFile方法按指定chunksize将文件拆分为多个块,并使用mergeFile方法将这些块重新合并为原始文件。代码包含详细的注释和异常处理,适用于需要处理大文件传输或存储的场景。
2026-10-13
21

本文介绍如何使用Python实现大文件的分割与合并功能。通过定义FileOperationBase类,利用splitFile方法按指定chunksize将文件拆分为多个块,并使用mergeFile方法将这些块重新合并为原始文件。代码包含详细的注释和异常处理,适用于需要处理大文件传输或存储的场景。
本文深入解析Python列表推导式的核心用法,涵盖基础创建、条件过滤及多层嵌套循环场景。通过对比传统for循环与推导式代码,展示如何简化逻辑并提升代码可读性,同时提供生成特定范围列表的实战案例,帮助开发者掌握高效的数据处理技巧。
本文详细介绍如何使用Python的pandas库合并Excel文件中的多个工作表。通过读取指定文件夹下的Excel文件,分别提取不同工作表的数据,并对特殊工作表进行索引截取处理,最终将结果保存为新的Excel文件。
本文介绍了使用Python和OpenCV库同时读取多个USB摄像头的实现方法。通过为不同摄像头分配不同的索引号(如0、1),可以并行获取视频流。然而,文章指出仅靠索引无法区分具体硬件设备,建议通过源码分析理解设备接入顺序与索引的对应关系,以解决多设备连接时的识别问题。
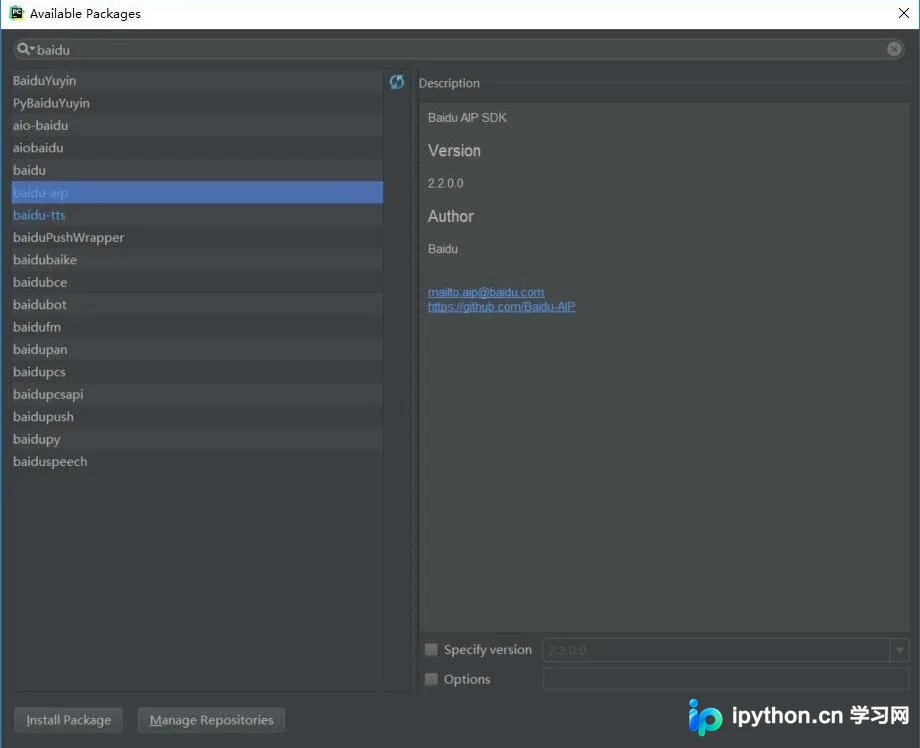
本文介绍如何在Python环境中使用百度AI开放平台的人脸识别API进行人脸比对。通过安装baidu-aip SDK,配置App ID、API Key和Secret Key,读取本地图片并调用match接口获取相似度分数。文中提供了完整的代码示例及相似度判断逻辑,帮助开发者快速实现人脸验证功能。
本文详解 Python 中处理复杂文本过滤与清理的多种方案。涵盖使用 str.translate() 进行字符映射、利用 unicodedata 处理 Unicode 组合字符与重音符号,以及通过 encode/decode 剥离非 ASCII 字符。重点对比 str.replace() 与 translate() 的性能差异,提供针对空格、控制字符及数字转换的高效代码示例,帮助开发者在保持数据纯净的同时优化运行效率。
本文详细解析Python中获取屏幕截图的四种常用方法:PIL的ImageGrab模块、Windows API、PyQt以及pyautogui。通过对比各方法的代码复杂度、执行速度及功能特性(如指定窗口、处理遮挡等),帮助开发者根据实际需求选择最高效的截屏方案。
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
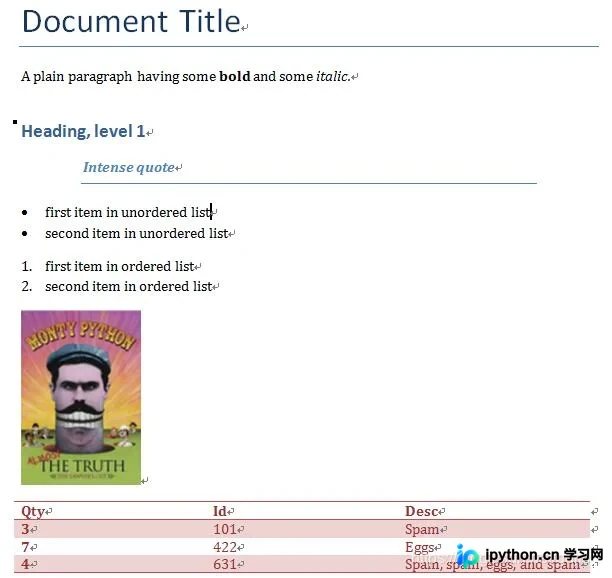
本文介绍如何使用python-docx库在Python中创建和编辑Microsoft Word文档。内容涵盖库的安装方法、.docx文件格式原理、文档创建(包括标题、段落、列表、图片及表格)以及文档读取操作。通过具体代码示例,展示如何生成包含格式文本的demo.docx文件并提取其内容,适用于需要自动化处理Word文档的开发者。
本文详解YOLOv3模型在Python环境下的调用方法,重点解决libdarknet.so动态库加载失败问题。通过调整文件路径、使用绝对路径及修改darknet.py文件,实现批量图片的目标检测与结果可视化,包含代码逻辑解析与路径配置建议。
本文介绍Python中二维列表(grid)的两种常见操作:转置与前后反转。通过列表推导式实现行列互换,利用reverse()方法逐行反转元素顺序,提供清晰代码示例供参考。
本文通过具体代码示例,详细解析NumPy中求平均值时axis参数的作用。通过展示二维数组在不同axis取值下的计算结果,对比手动实现与内置函数的差异,帮助读者准确掌握按行或按列求平均值的设定方法。