

Python使用python-docx读写Word文档完整指南

发布时间:2026-10-13| 6人浏览过
本文介绍如何使用python-docx库在Python中创建和编辑Microsoft Word文档。内容涵盖库的安装方法、.docx文件格式原理、文档创建(包括标题、段落、列表、图片及表格)以及文档读取操作。通过具体代码示例,展示如何生成包含格式文本的demo.docx文件并提取其内容,适用于需要自动化处理Word文档的开发者。
python-docx库简介与格式说明
python-docx库提供了创建和编辑Microsoft Word(.docx)文件的功能。
官方文档:链接地址
备注:
.doc是微软专有的文件格式,而.docx格式自Microsoft Office 2007版本起使用,基于Office Open XML标准的压缩文件格式,相比.doc文件占用空间更小。.docx文件本质上是一个ZIP压缩包,因此可以直接将.docx后缀改为.zip进行解压。解压后,word/document.xml文件包含了Word文档的主要内容,而图片文件则存储在word/media目录中。
python-docx不支持直接处理.doc文件,间接解决方法是在代码中先将.doc文件转换为.docx格式。
环境安装与文档创建
一、安装包
pip3 install python-docx二、创建word文档
以下代码在官方示例基础上进行了部分修改,并补充了函数的使用说明。
from docx import Document
from docx.shared import Inches

document = Document()

#添加标题,并设置级别,范围:0 至 9,默认为1
document.add_heading('Document Title', 0)

#添加段落,文本可以包含制表符(\t)、换行符(\n)或回车符(\r)等
p = document.add_paragraph('A plain paragraph having some ')
#在段落后面追加文本,并可设置样式
p.add_run('bold').bold = True
p.add_run(' and some ')
p.add_run('italic.').italic = True

document.add_heading('Heading, level 1', level=1)
document.add_paragraph('Intense quote', style='Intense Quote')

#添加项目列表(前面一个小圆点)
document.add_paragraph(
 'first item in unordered list', style='List Bullet'
)
document.add_paragraph('second item in unordered list', style='List Bullet')

#添加项目列表(前面数字)
document.add_paragraph('first item in ordered list', style='List Number')
document.add_paragraph('second item in ordered list', style='List Number')

#添加图片
document.add_picture('monty-truth.png', width=Inches(1.25))

records = (
 (3, '101', 'Spam'),
 (7, '422', 'Eggs'),
 (4, '631', 'Spam, spam, eggs, and spam')
)

#添加表格:一行三列
# 表格样式参数可选:
# Normal Table
# Table Grid
# Light Shading、 Light Shading Accent 1 至 Light Shading Accent 6
# Light List、Light List Accent 1 至 Light List Accent 6
# Light Grid、Light Grid Accent 1 至 Light Grid Accent 6
# 太多了其它省略...
table = document.add_table(rows=1, cols=3, style='Light Shading Accent 2')
#获取第一行的单元格列表
hdr_cells = table.rows[0].cells
#下面三行设置上面第一行的三个单元格的文本值
hdr_cells[0].text = 'Qty'
hdr_cells[1].text = 'Id'
hdr_cells[2].text = 'Desc'
for qty, id, desc in records:
 #表格添加行,并返回行所在的单元格列表
 row_cells = table.add_row().cells
 row_cells[0].text = str(qty)
 row_cells[1].text = id
 row_cells[2].text = desc

document.add_page_break()

#保存.docx文档
document.save('demo.docx')
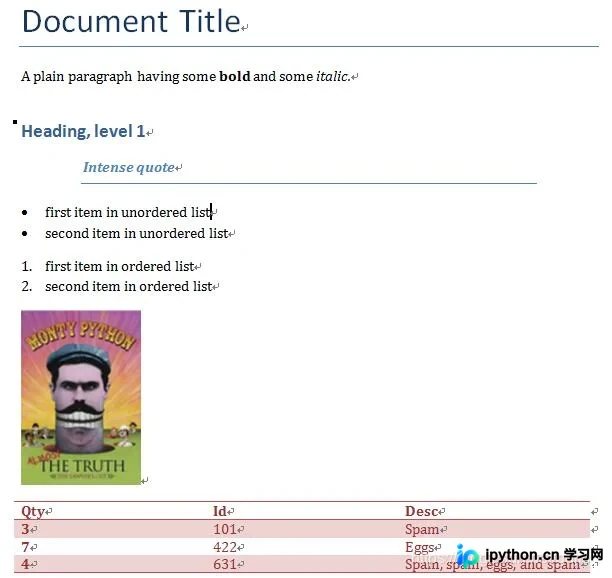
创建的demo.docx内容如下:
读取Word文档内容
三、读取word文档
from docx import Document

doc = Document('demo.docx')

#每一段的内容
for para in doc.paragraphs:
 print(para.text)

#每一段的编号、内容
for i in range(len(doc.paragraphs)):
 print(str(i), doc.paragraphs[i].text)

#表格
tbs = doc.tables
for tb in tbs:
 #行
 for row in tb.rows:
 #列
 for cell in row.cells:
 print(cell.text)
 #也可以用下面方法
 '''text = ''
 for p in cell.paragraphs:
 text += p.text
 print(text)'''
运行结果:
Document Title
A plain paragraph having some bold and some italic.
Heading, level 1
Intense quote
first item in unordered list
second item in unordered list
first item in ordered list
second item in ordered list
Document Title
A plain paragraph having some bold and some italic.
Heading, level 1
Intense quote
first item in unordered list
second item in unordered list
first item in ordered list
second item in ordered list


Qty
Id
Desc
101
Spam
422
Eggs
631
Spam, spam, eggs, and spam
[Finished in 0.2s]
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









