Python爬虫开发中常用的HTTP请求方法详解
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
2026-10-14
21

本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
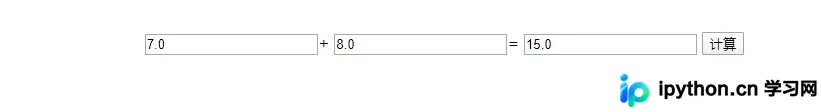
本文详解如何使用Python Flask框架开发一个简单的加法Web应用。通过封装sum_function子函数实现逻辑复用,利用try-except语句对输入进行浮点数校验,并在HTML模板中保留用户输入值以优化交互体验。最终通过localhost:8080端口验证正确与错误输入下的运行结果。
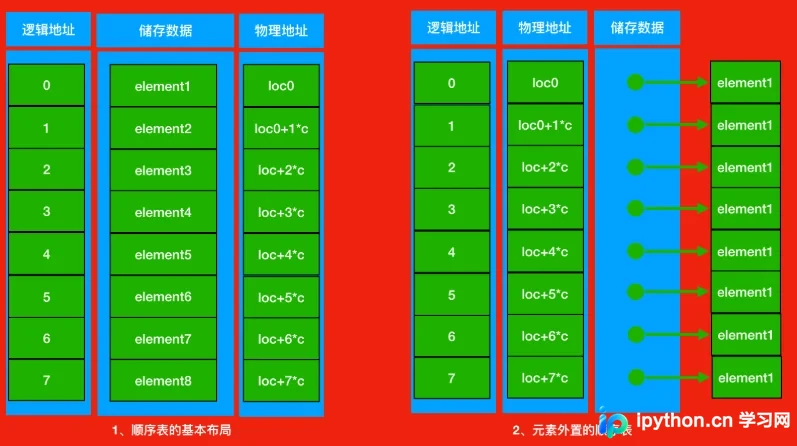
本文深入解析顺序表的逻辑结构与物理存储,对比一体式与分离式两种实现方式。重点阐述Python中list采用的分离式动态顺序表技术,包括其基于容量阈值的倍增或加倍扩容策略,并通过C语言与Python代码示例展示增删改查操作及时间复杂度特性。
本文详解在Pandas中使用read_csv读取CSV文件时如何灵活处理列名。涵盖文件自带标题、自定义重命名、无标题文件处理等场景。重点讲解header和names参数的正确用法,特别是避免在读取无标题文件时误用header=0导致首行数据丢失的关键注意事项,帮助开发者高效管理数据列结构。
本文介绍如何使用Python脚本结合freeapi.ipip.net和ip-api.com两个免费接口,实现IP地址归属地的批量查询。通过命令行参数传入IP,程序自动解析并输出国家、省份、城市、运营商等详细信息,适合网络管理者和开发者快速部署本地IP查询工具。
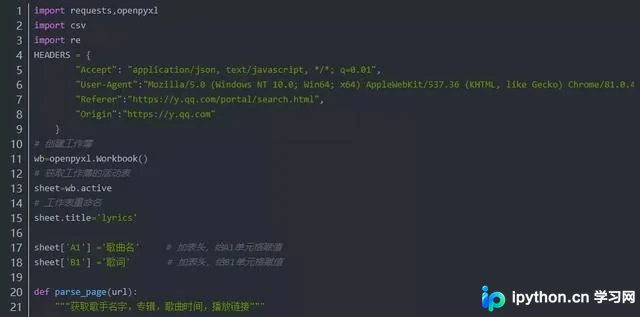
本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
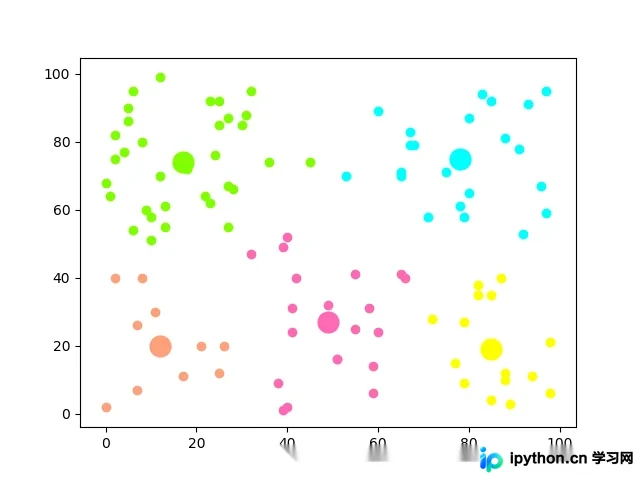
本文详细解析 k-means 聚类算法的核心思想,涵盖从随机初始化聚类中心到迭代更新均值的完整流程。通过 Python 代码展示如何利用 numpy 和 matplotlib 实现聚类过程及结果可视化,帮助开发者理解算法逻辑并快速上手应用。
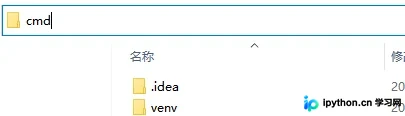
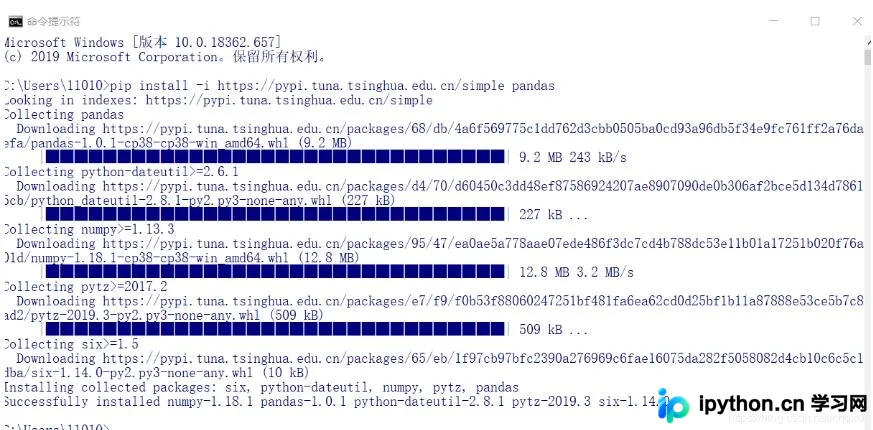
本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
本文解析在Python的for循环中直接调用list.remove()导致元素漏删的根本原因。由于列表长度动态变化与迭代器索引递增不同步,部分目标元素会被跳过。通过复制列表副本进行遍历和删除操作,可有效避免此问题,确保数据处理的完整性与安全性。
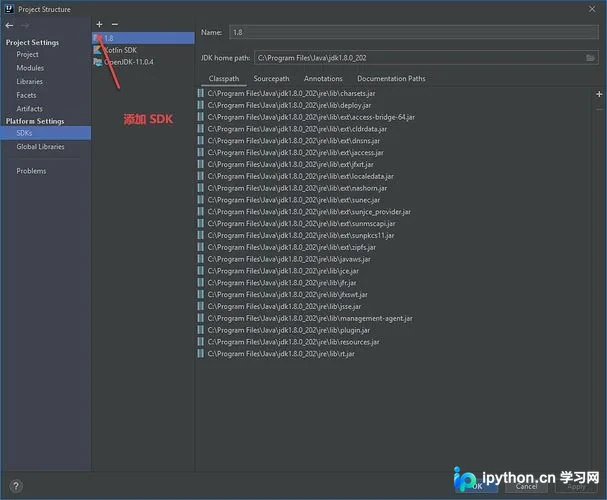
本文详解在 IntelliJ 中配置 Anaconda Python SDK 的操作流程。通过 Project Structure 添加 SDK,系统可自动识别已安装的 Anaconda,若未安装则需先完成环境部署。配置完成后保存并等待库刷新,即可在项目中正常使用 Python 环境进行开发。
本文深入解析Python中类变量与实例变量的区别,通过具体代码示例揭示修改子类属性影响父类类变量的底层原因。文章详细讲解了属性查找机制、方法解析顺序(MRO)以及self绑定的作用,帮助开发者避免在Python面向对象编程中因误用类变量而导致的意外共享状态问题。
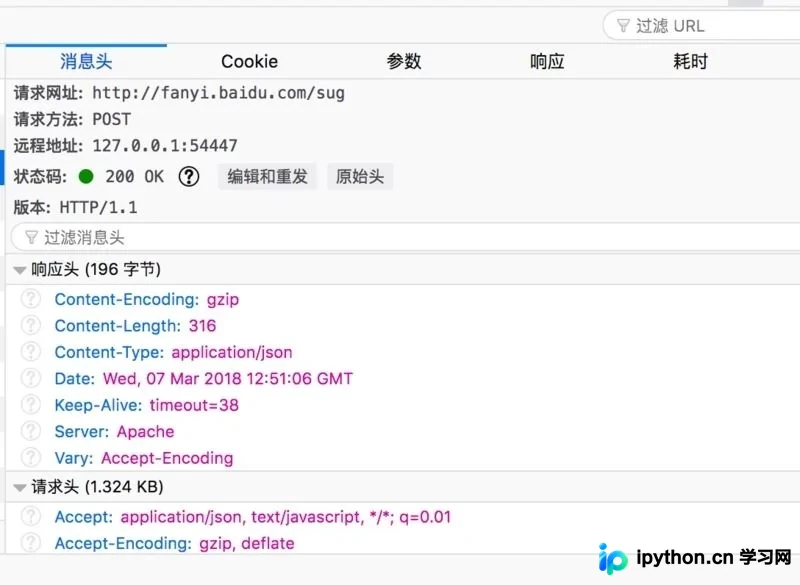
本文详解如何使用Python编写爬虫程序调用百度翻译接口。通过F12开发者工具分析网络请求,获取fanyi.baidu.com/sug接口及POST参数kw。结合urllib库构造请求头与数据,实现输入内容并输出翻译结果的核心功能,适合初学者快速上手网络爬虫开发。