Python使用OpenCV与Matplotlib将图片转换为矢量SVG图
本文介绍利用Python将位图转换为矢量图的方法。通过OpenCV读取图像,按像素颜色分类并提取坐标,使用Matplotlib绘制散点图并保存为SVG矢量格式。代码示例展示了如何处理颜色分类及保存过程,适用于简单图像向矢量图的转换场景。
2026-10-14
9

本文介绍利用Python将位图转换为矢量图的方法。通过OpenCV读取图像,按像素颜色分类并提取坐标,使用Matplotlib绘制散点图并保存为SVG矢量格式。代码示例展示了如何处理颜色分类及保存过程,适用于简单图像向矢量图的转换场景。
本文介绍使用Python的pandas、xlrd和openpyxl库合并Excel文件中指定Sheet的方法。重点解决合并后出现的列顺序错乱及自动生成Unnamed:0列的问题,通过设置header=None、index_col=0和index=False等参数实现数据正确合并与保存。
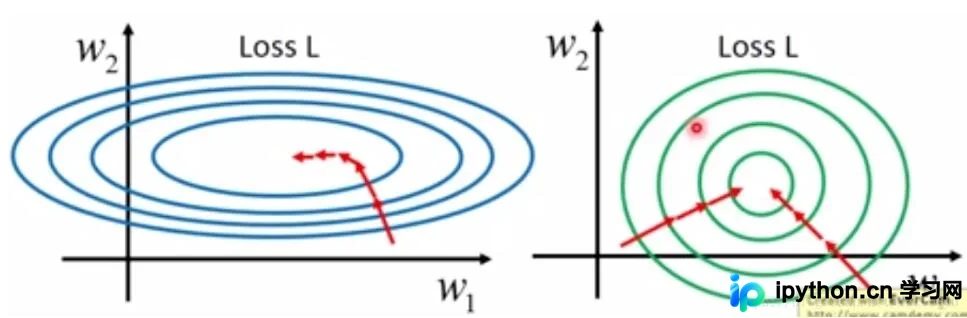
本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。
本文详细解析Numpy中shape函数的功能与用法。通过一维、二维及三维数组实例,展示如何获取数组各维度的元素个数。文章涵盖np.array创建不同维度数组时的括号包裹规则及输出格式,帮助开发者准确理解并应用shape属性进行数据维度分析。
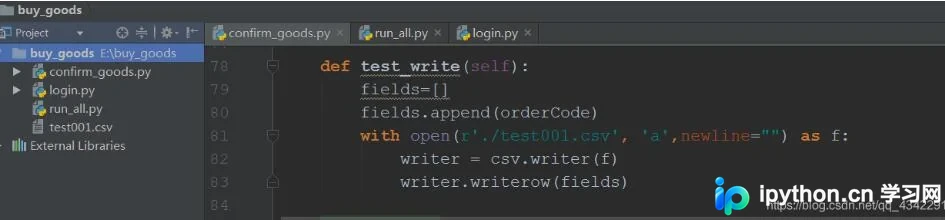
本文介绍如何使用 Python 的 csv 模块将列表数据写入 CSV 文件,重点说明通过设置 newline='' 参数消除多余空行的方法。同时提供将 JSON 数据转换为 CSV 格式的两种方案:直接转换与自定义字段顺序及提取坐标数据的进阶处理,适用于数据抓取后的格式化处理场景。
本文详细讲解Python中创建堆的两种基本方法:heappush()和heapify()。通过具体代码实例展示如何向堆中插入元素并保持堆性质,以及如何在已有数据列表上高效构建堆。同时扩展介绍了最小堆与最大堆的定义、节点下沉操作及完全二叉树的存储特性,帮助开发者深入理解Python堆数据结构的实现原理。
本文详细介绍 Python 标准库 os.path 模块中 exists() 函数的用法,用于判断指定文件或目录路径是否存在。通过具体代码示例演示如何检测文件存在性,并补充结合 os.makedirs() 自动创建缺失目录及保存数据的完整操作流程,帮助开发者高效处理文件路径检查与目录管理任务。
本文详解如何利用Python与Appium实现多台Android设备的并行测试。核心思路是为每台设备分配独立端口并启动独立Appium服务,通过Python多进程池(Process Pool)将设备列表与测试用例绑定,实现并发执行。文章提供了从设备获取、服务启动到用例执行的完整代码逻辑与关键实现步骤。
本文详解Python中os.mkdir()与os.makedirs()的区别。os.mkdir仅支持创建单级目录,若父目录不存在则报错,适合确保路径安全的场景;os.makedirs可递归创建多级目录,即使中间层级缺失也能自动创建。文章通过代码示例对比两者行为,并探讨在Hadoop文件同步等实际业务中如何根据需求选择合适方法,避免路径错误导致的异常。
本文详解NumPy中sum函数的axis与keepdim参数。axis指定求和维度,keepdim控制输出维度是否保留。通过三维数组示例说明axis对不同层级的影响,并结合代码展示keepdim=True如何保持结果维度与原始数组一致,帮助开发者精准控制数组计算结果。
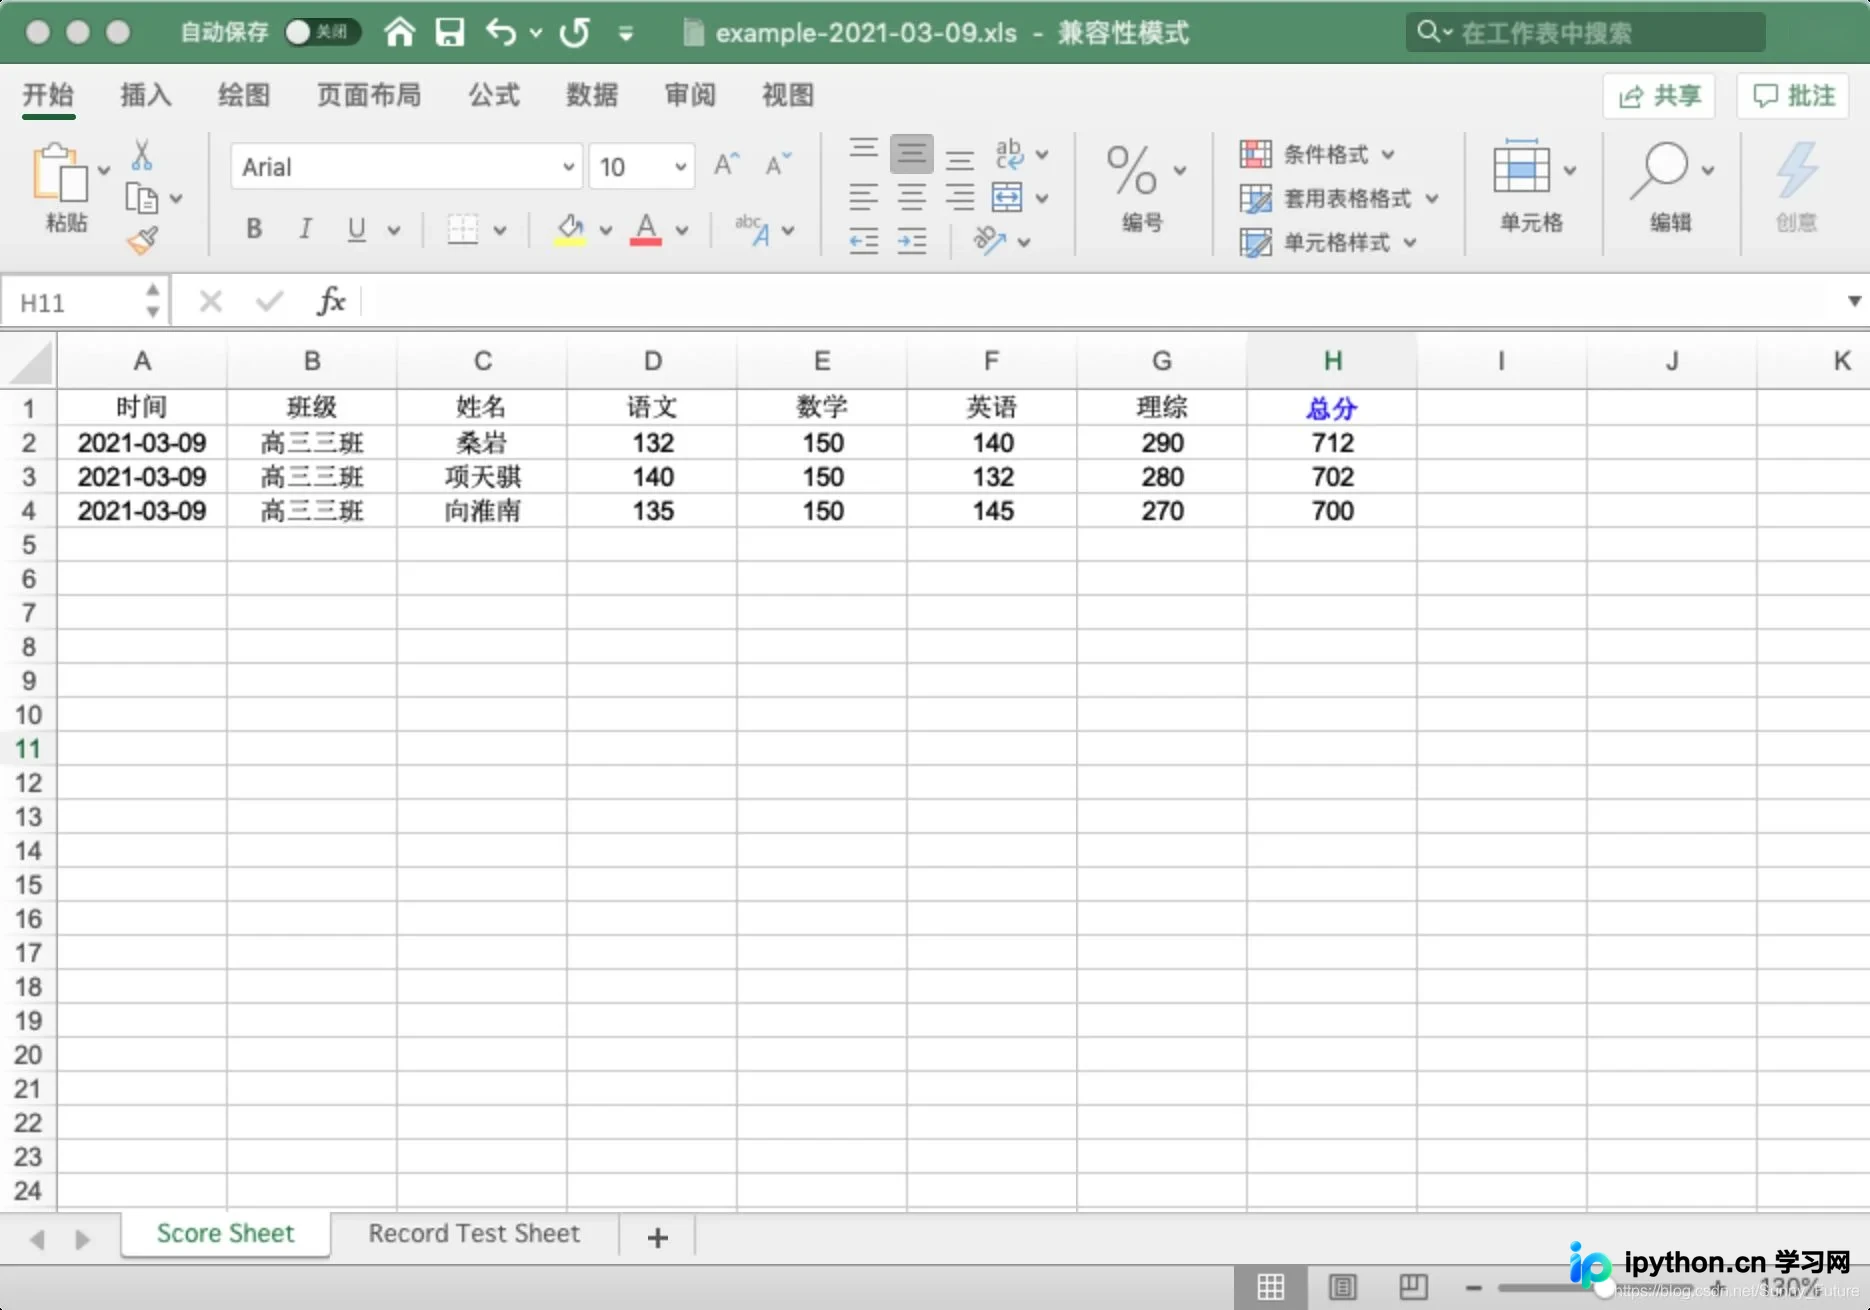
本文详细介绍Python中处理Excel文件的三个核心库:xlrd用于读取,xlwt用于写入,xlutils用于修改。通过安装模块、写入带格式数据、读取Sheet内容及使用copy方法修改现有文件等实例,演示如何高效操作Excel表格,并指出复制xls文件时格式保留的局限性。
本文介绍如何利用Python的jieba库对中文文本进行精确分词,并通过Counter模块统计高频词汇。同时结合matplotlib和wordcloud库,将统计结果可视化生成词云图。文章包含完整的代码示例、运行结果分析及注意事项,适用于需要处理中文文档并提取关键信息的场景。