解决Jupyter Notebook中TensorFlow设备信息打印问题
本文介绍在Jupyter Notebook环境中使用TensorFlow时,如何正确打印设备分配信息。通过设置log_device_placement=True及output_partition_graphs=True,可获取详细的设备日志。同时解决了因中文编码导致的控制台输出异常问题,提供完整的代码示例与配置方法。
2026-10-13
13

本文介绍在Jupyter Notebook环境中使用TensorFlow时,如何正确打印设备分配信息。通过设置log_device_placement=True及output_partition_graphs=True,可获取详细的设备日志。同时解决了因中文编码导致的控制台输出异常问题,提供完整的代码示例与配置方法。
本文详解如何在 Jupyter 及 Python 环境中解决中文乱码问题。重点介绍通过添加 # -*- coding: utf-8 -*- 声明源文件编码格式,以及利用 shebang 指定解释器路径的方法。同时提供修改 sys 模块默认编码的临时解决方案,帮助开发者避免 Non-ASCII character 报错,确保控制台输出正常。
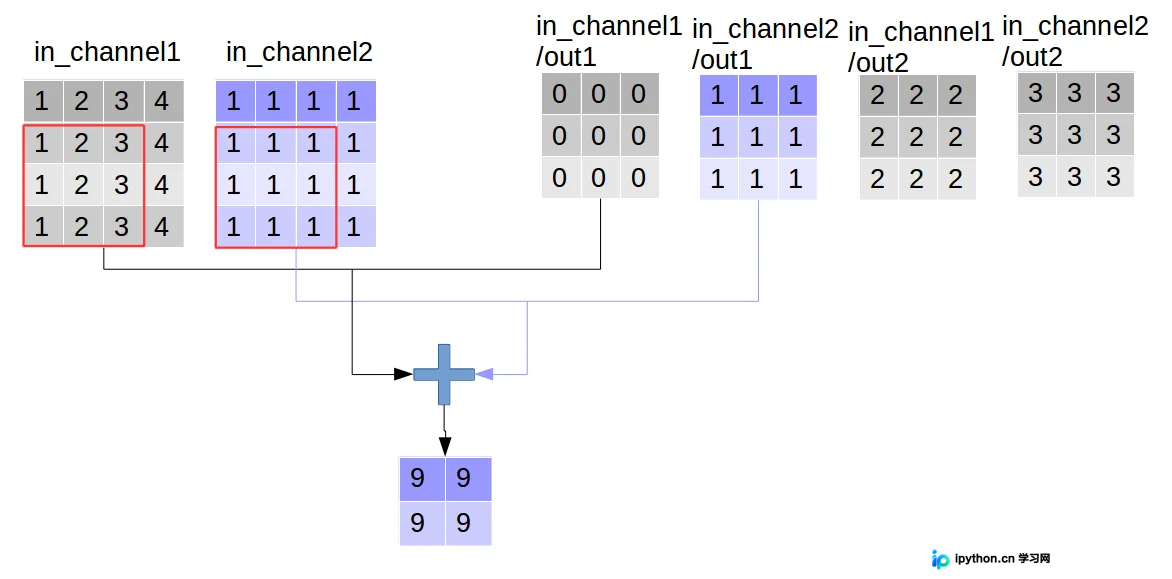
本文深入解析TensorFlow中tf.nn.depthwise_conv2d函数的实现原理。详细阐述其五个核心参数:input、filter、strides、padding和rate,并对比普通卷积与深度卷积在通道处理上的差异。通过构建自定义输入图像与卷积核的完整代码示例,直观展示深度卷积的计算过程与输出结果,帮助开发者理解并应用该技术在模型轻量化中的优势。
本文深入解析Python中的assert断言机制。介绍assert的基本语法、可选参数用法,通过代码示例展示断言失败时如何抛出AssertionError。同时说明如何通过-O参数关闭断言,帮助开发者掌握这一简单的异常处理工具。
在Python Spyder环境中使用Pandas查看DataFrame时,常因列数或行数过多导致数据显示省略号。本文介绍利用pd.set_option函数调整display.max_columns和display.max_rows参数,完整展示所有数据列与行,解决Spyder下的显示截断问题。
本文介绍在Jupyter Notebook环境中使用argparse库时,parser.parse_args()因识别到Jupyter内部参数而报错的解决方案。通过将参数列表设为空数组args=[],可成功解析自定义命令行参数。
本文介绍在Jupyter Notebook环境中使用Python的argparse模块时遇到的SystemExit报错问题。通过分析sys.argv默认行为,提出通过手动传入参数列表解决该问题的方法,帮助开发者在交互式环境中顺利运行基于命令行参数的脚本。
Django ORM 封装了数据库操作,但有时需要排查底层 SQL 以优化性能。本文介绍通过配置 settings.py 中的 LOGGING 模块,将日志级别设为 DEBUG,即可在控制台实时查看 Django 执行的具体 SQL 语句及耗时,帮助开发者识别重复查询并优化数据库访问。
本文深入解析 TensorFlow 中 tf.nn.softmax_cross_entropy_with_logits 函数的内部机制。该函数将 softmax 归一化与交叉熵计算合并,直接接收 logits 和真实标签。文章详细说明了参数含义、数学公式推导,并通过 Python 代码对比手动计算与函数调用的结果,帮助开发者理解其返回值特性及 reduce_sum/mean 的必要性。
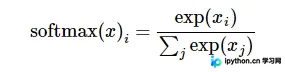
本文介绍在Spyder的IPython Console中运行带有命令行参数的Python脚本的两种方法。通过修改runfile函数的args参数,或在控制台直接使用run命令配合脚本路径及参数,可解决程序依赖外部参数运行的问题,无需切换至CMD即可实现本地调试。
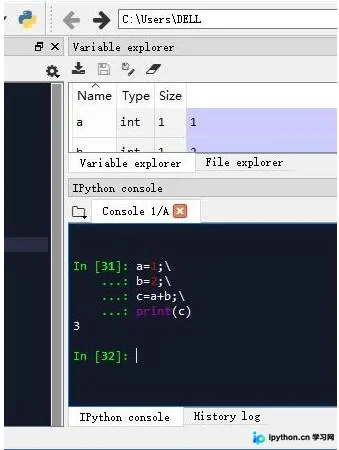
本文介绍在Spyder的IPython Console中执行Python文件及进行调试的具体方法。通过run命令运行脚本,利用debugfile函数设置参数与工作目录进行断点调试,并补充了在控制台输入多行代码时的换行技巧,帮助开发者高效利用Spyder进行Python开发。
在Spyder或IPython中处理大型数组时,默认输出会被省略号截断。本文介绍如何通过np.set_printoptions设置threshold参数来完整显示数组内容,并补充了reset和clear命令用于清理变量和控制台记录的实用技巧。