

解决 Jupyter 中文乱码:Python 源文件编码声明与解释器配置指南

本文详解如何在 Jupyter 及 Python 环境中解决中文乱码问题。重点介绍通过添加 # -*- coding: utf-8 -*- 声明源文件编码格式,以及利用 shebang 指定解释器路径的方法。同时提供修改 sys 模块默认编码的临时解决方案,帮助开发者避免 Non-ASCII character 报错,确保控制台输出正常。
解决 Jupyter 中文乱码:Python 源文件编码声明与解释器配置指南
为了节省篇幅,这里直接展示核心代码与配置方法。
stdi, stdo, stde = sys.stdin, sys.stdout, sys.stderr
reload(sys)
sys.setdefaultencoding('utf-8')
sys.stdin, sys.stdout, sys.stderr = stdi, stdo, stde
Python 源文件编码格式声明与解释器选择
补充知识:Python 源文件编码格式声明与解释器选择
1、当未添加任何编码说明时,Python 默认使用 ASCII 码。若源文件中包含中文字符,会导致页面显示错误或文件无法被解释器正确读取。例如,系统可能报错:“Non-ASCII character '\xe7' in file E:/pythonP/HMMTest.py on line 4, but no encoding declared;”,这表明文件中存在非 ASCII 字符但未声明编码,导致解析失败。
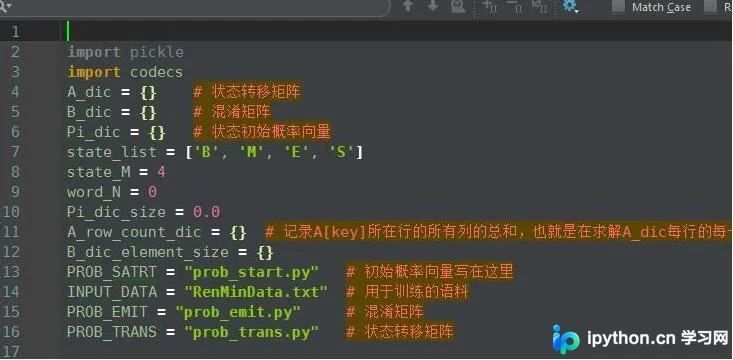
添加编码声明
2、在 Python 源文件中添加编码声明:
该声明语句必须位于文件的第一行或第二行,否则解释器将无法识别。
声明的格式需符合特定的正则表达式规则:"^[ \t\v]*#.*?coding[:=][ \t]*([-_.a-zA-Z0-9]+)"。
常见的标准声明格式如下:
# -*- coding: <encoding name> -*-
# coding=<encoding name>
something something coding=<encoding name>
指定解释器路径
3、经常在文件头部看到类似 #!/usr/local/bin/python 的语句:
这种注释(Shebang)用于指定运行脚本时所使用的解释器路径。如果系统中安装了多个版本的 Python,可以通过这种方式明确指定需要使用的特定 Python 版本。
例如,在源文件起始处写入:#!F://python 来指定具体的 Python 解释器路径。
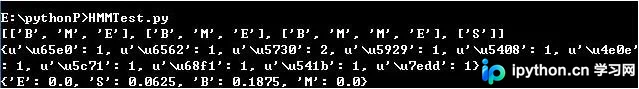
配置完成后,即可直接运行该脚本文件。
以上关于 Jupyter 中文乱码处理、编码格式设置及避免控制台输出错误的解决方案即为全部内容,希望能为各位开发者提供参考,欢迎继续支持本站获取更多技术资讯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









