Python中高效替换NumPy数组大于阈值元素的方法
本文详解在Python中替换NumPy数组中大于特定阈值元素的多项技术。通过对比基础循环、布尔索引、np.minimum、np.clip以及np.putmask等方法的执行效率,结合MRI图像处理的实际场景,推荐在需要原地修改或限制数值范围时优先使用内置函数,以实现代码简洁性与运行速度的最佳平衡。
2026-10-14
12

本文详解在Python中替换NumPy数组中大于特定阈值元素的多项技术。通过对比基础循环、布尔索引、np.minimum、np.clip以及np.putmask等方法的执行效率,结合MRI图像处理的实际场景,推荐在需要原地修改或限制数值范围时优先使用内置函数,以实现代码简洁性与运行速度的最佳平衡。
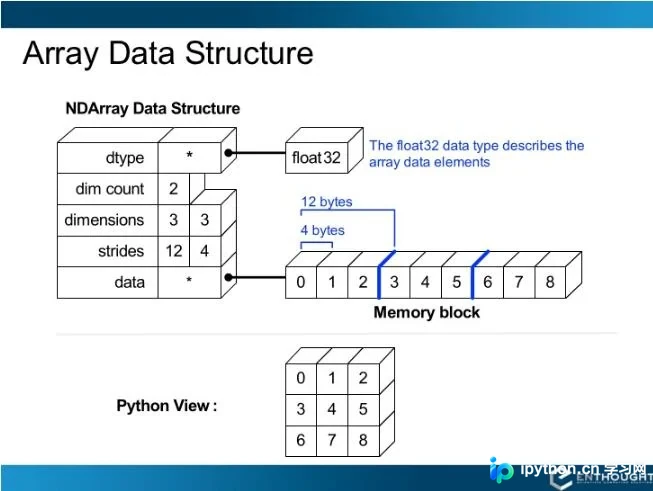
本文介绍如何在Python中使用NumPy计算数组按列非零元素的平均值,通过判断非零元素并求和除以数量实现。同时补充了利用Pandas DataFrame统计行列零值个数的方法,包括按行返回Series及按列返回Series的操作示例,为数据处理提供实用参考。
本文详解如何使用Python将二进制图片存入SQL Server的image类型字段。通过安装pywin32和adodbapi库,利用adodbapi.Binary处理二进制数据流,结合SQL Server OLE DB驱动,先插入元数据记录,再通过UPDATE语句将图片二进制内容写入数据库,确保数据完整保存。
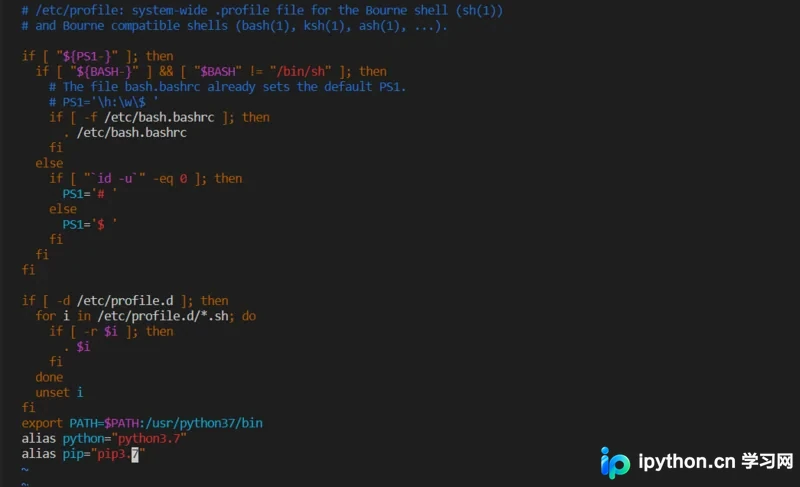
本文详细介绍在 Ubuntu 18.04 系统中通过源码编译方式安装 Python 3.7 的完整步骤。内容涵盖编译依赖工具的安装、Python 源码下载与解压、自定义路径配置、环境变量及别名设置、软链接创建以及国内 pip 源配置。适用于需要特定 Python 版本且希望完全掌控安装路径的 Linux 用户。
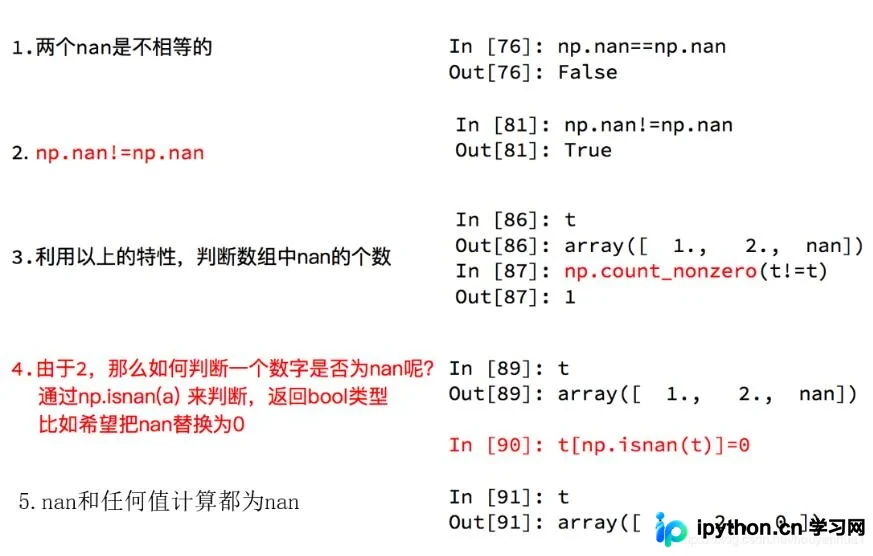
本文介绍如何在Python的Numpy库中处理NaN和Inf值。通过将NaN替换为对应列的均值,避免直接填0对统计结果的影响。同时讲解了使用np.nanmean等函数在计算时忽略NaN值的方法,并提供完整的代码示例。
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
本文详解Python中调用ADB命令的两种主要方式:os.system与os.popen,并重点推荐非阻塞的subprocess模块。通过对比一次性命令与logcat实时日志的处理差异,展示read与readline方法的应用,结合-s参数实现多设备精准控制,助力Python自动化测试开发。
本文介绍Python中字典或列表包含中文字符时,直接打印出现乱码的原因及解决方案。通过引入json模块并使用dumps函数,设置encoding为UTF-8且ensure_ascii为False,可正确输出中文。该方法同样适用于列表,确保数据在控制台或日志中正常显示。
本文详细介绍 Python 中将数据写入文件并保存的标准流程,涵盖 open、write 和 close 函数的配合使用。通过具体代码示例,演示如何保存普通字符串、字典对象以及包含多维数据的列表至文本或 Excel 文件,帮助开发者掌握基础文件操作技巧。
本文详解Python中二维列表的操作方法,包括通过下标访问一维列表、利用flatten函数将二维列表转换为一维列表,以及使用zip函数将多个一维列表组合为二维结构。涵盖基础访问技巧与常见数据转换场景,帮助开发者高效处理列表数据。
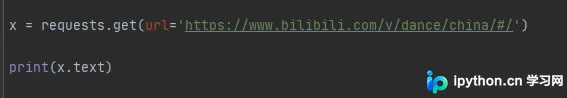
本文详细介绍如何使用Python的requests库查看网页源代码。通过导入requests模块,利用get()函数发送HTTP请求获取指定URL的HTML内容,并设置编码为utf-8后打印输出。文章包含完整代码示例及运行结果分析,适合初学者快速掌握网页数据抓取的基本方法。
本文介绍如何利用Python脚本将Hive命令行输出转换为标准的Insert语句,解决Hive无法直接导出插入语句的问题。同时详细记录了通过impyla、HDFS及MySQL中转等多种尝试路径中的常见陷阱,重点警示批量插入的性能瓶颈,并提供实用的临时解决方案。