

Python爬虫实战:抓取淘宝MM头像、简介及写真图片完整教程
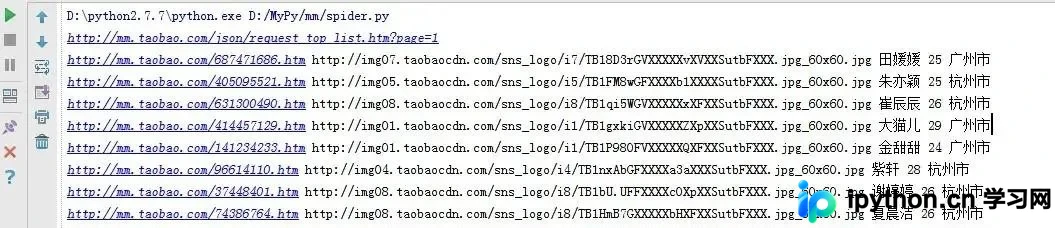
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
2026-10-14
7

本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
本文详细解析使用Python编写网络爬虫的基础流程。通过介绍HTTP协议的基本工作原理,演示如何利用requests模块发起GET请求并处理响应头。随后,结合BeautifulSoup库的find与find_all方法,展示如何从HTML文档中精准提取目标标签信息,帮助初学者快速掌握爬虫核心技能。
本文详解 Python Selenium 中键盘与鼠标的高级操作。通过 Keys 类模拟 Ctrl+A/V 等组合键及删除、清空输入框;利用 ActionChains 类实现右击、双击、拖动及元素悬停。结合具体代码示例,展示如何在 Web 测试中精准控制浏览器交互,提升自动化脚本的实用性与完整性。
本文解析了Python中基于multiprocessing模块的远程过程调用(RPC)实现机制。通过RPCHandler与RPCProxy类,客户端将函数名及参数序列化后通过网络发送,服务器端反序列化并执行对应注册函数,最后将结果或异常序列化返回。代码示例展示了服务端监听与客户端代理的核心逻辑,适用于理解分布式通信基础。
本文介绍如何在 Python 中构建一个灵活的计时器类。通过封装 time 模块,利用 contextlib 协议实现 with 语句支持,并提供 start、stop 和 reset 方法。文章对比了 time.time、time.clock 与 time.perf_counter 的精度差异,并演示了如何使用 time.process_time 仅统计 CPU 时间,帮助开发者准确评估代码执行耗时。
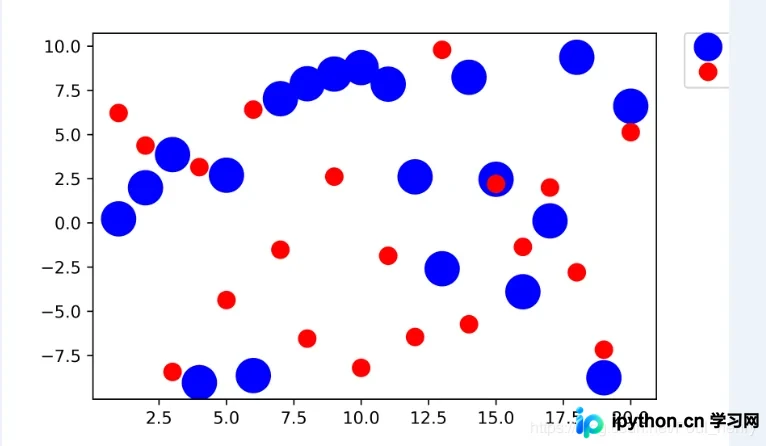
在使用Python matplotlib保存矢量图时,若将图例置于图形外侧,常因savefig()默认的边界框(bbox)未包含图例而导致保存图像显示不完整。本文详细解析该问题的原理,并提供两种解决方案:一是通过subplots_adjust()调整子图边距将图例移入保存区域;二是利用savefig()的bbox_inches='tight'参数自动扩大边界框以包含图例。此外还介绍了pad_inches和bbox_extra_artists参数的用法,确保所有元素完整保存。
本文详细解析Python中字节类型与整型、浮点型及字符串类型的相互转换方法。通过具体代码实例,演示bytes与str的编码转换、bytes与int的大小端转换、利用struct模块实现byte与float的精确互转,以及str与bytearray的无缝切换,帮助开发者掌握底层数据处理的常用技巧。
本文解析Python爬虫选用MongoDB的核心原因。MongoDB采用文档存储方式,直接支持JSON和List结构,无需预定义表结构即可随时创建集合。其模式自由特性允许每条记录字段长度不一致,完美适配爬虫获取的杂乱非结构化数据。此外,MongoDB具备高性能、易部署、支持动态查询及多语言接口等优势,是处理海量爬虫数据的理想选择。
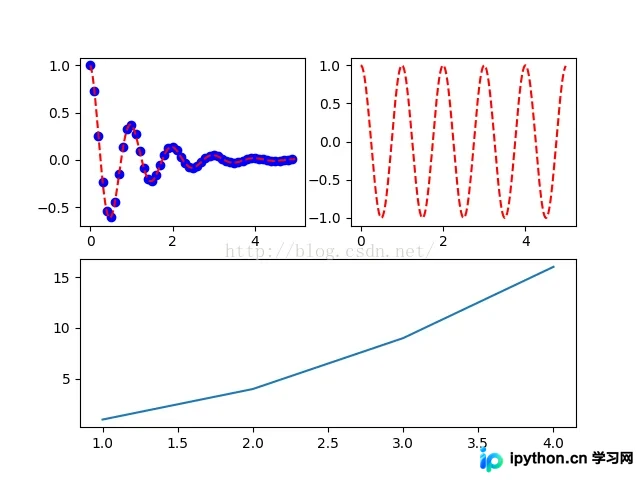
本文介绍如何在matplotlib中使用subplot函数快速绘制多个子图。通过numRows、numCols和plotNum参数定义网格布局与子图位置,结合具体代码示例展示2x2及2x1布局下的绘图实现,帮助开发者掌握多子图创建技巧。
本文详细解析Python3爬虫中携带Cookie的两种核心方法:直接写入Header头部和使用requests库的cookies参数。通过哈工大ACM站点的登录实战,演示如何利用urllib和cookiejar实现自动登录及后续页面访问,帮助开发者解决身份验证相关的爬虫需求。
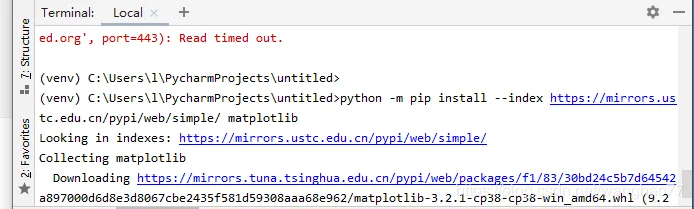
本文详细记录了Python安装matplotlib库时遇到的三种典型失败场景:pip安装超时(read timed out)、缺少Microsoft Visual C++ 14.0报错以及cl.exe编译失败。通过结合清华镜像源、指定Python版本及正确使用python -m pip命令,最终解决了安装难题,提供了小白友好的实操参考。
本文详细讲解Python爬虫中请求头(Headers)的设置方法,涵盖Requests、Selenium(Chrome/PhantomJS)、Scrapy框架及Aiohttp异步库。通过模拟浏览器头部信息,有效绕过网站反爬限制。内容包含具体代码示例及获取Headers的实操步骤,帮助开发者解决访问被拒问题。