

Python爬虫实现中英互译词典功能
本文介绍利用Python3.6及urllib库抓取某平台翻译资源,实现中英互译功能。通过构造请求参数调用翻译接口,解析返回的JSON数据并展示翻译结果,包含输入、处理及输出完整流程,供开发者参考学习。
2026-10-13
7

本文介绍利用Python3.6及urllib库抓取某平台翻译资源,实现中英互译功能。通过构造请求参数调用翻译接口,解析返回的JSON数据并展示翻译结果,包含输入、处理及输出完整流程,供开发者参考学习。
本文演示如何使用Python requests和BeautifulSoup库抓取有道词典网页数据,实现英汉互译功能。通过ctypes模块实现Windows控制台彩色文字输出,并利用PyInstaller将脚本打包为独立的EXE文件,方便在CMD中直接运行。
本文深入解析Python3中requests库的高级功能,涵盖文件上传、Cookies管理与会话维持、SSL证书验证与忽略、代理设置(含SOCKS)、超时控制、身份认证及Prepared Request等核心用法。通过具体代码实例,帮助开发者掌握高效、稳定的网络请求技巧,适用于复杂爬虫场景。
本文详细介绍如何使用Python批量下载抖音视频。通过构建Spider类,利用requests和bs4库解析视频分享链接,提取视频URL并保存至本地文件夹。教程包含环境配置、核心代码编写及运行测试步骤,适合希望学习Python网络爬虫基础的用户参考。
本文分享使用Python进行批量爬取和下载抖音视频的完整代码实现。通过解析用户主页获取视频列表,利用requests和re库提取关键信息,并结合asyncio与aiohttp实现异步并发下载,有效提升批量处理效率。
本文介绍利用 Python 通过搜狗微信搜索接口抓取微信公众号基本信息及最新文章的方法。内容涵盖从分类列表页获取公众号链接、解析详情页数据(名称、ID、主体等),并详细说明了验证码处理、链接时效性及二维码保存等注意事项。最后通过 Flask 结合 SQLite 实现结果的本地展示,并简要对比了 Sanic 框架的尝试过程。
本文演示如何使用Python的urllib库获取基金网站网页内容,并利用BeautifulSoup库解析HTML结构。通过具体代码示例,展示如何读取网页源码、处理编码问题,并提取基金编码、名称及净值等关键信息,供Python开发者参考学习。
本文介绍如何利用Python配合Selenium库实现自动化打开Chrome浏览器进行百度关键词搜索。内容涵盖Python及Selenium的安装、chromedriver的配置、爬虫代理接口的获取,以及包含IP池管理的完整自动化搜索代码示例与运行效果。
本文介绍一个基于Python和OpenCV的简易数据采集工具,用于快速构建目标检测训练集。通过指定分类标签名,程序自动创建对应文件夹,并在运行窗口中按N键实时截取当前画面保存为带时间戳的JPG图片,帮助开发者高效完成自定义数据集的准备工作。
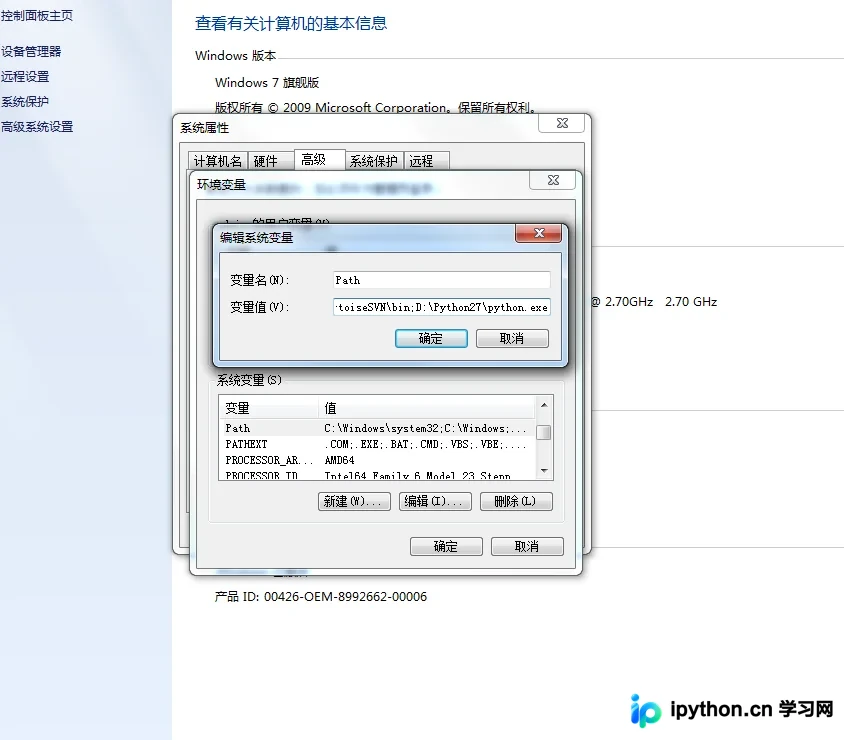
本文详细介绍在 Python 环境中安装 Scrapy 爬虫框架的完整步骤。内容涵盖 Python 环境变量配置、pywin32 组件安装、pip 工具部署以及通过命令行执行安装命令的全过程。最后提供验证 Scrapy 是否安装成功的方法,帮助开发者快速搭建爬虫开发基础环境。
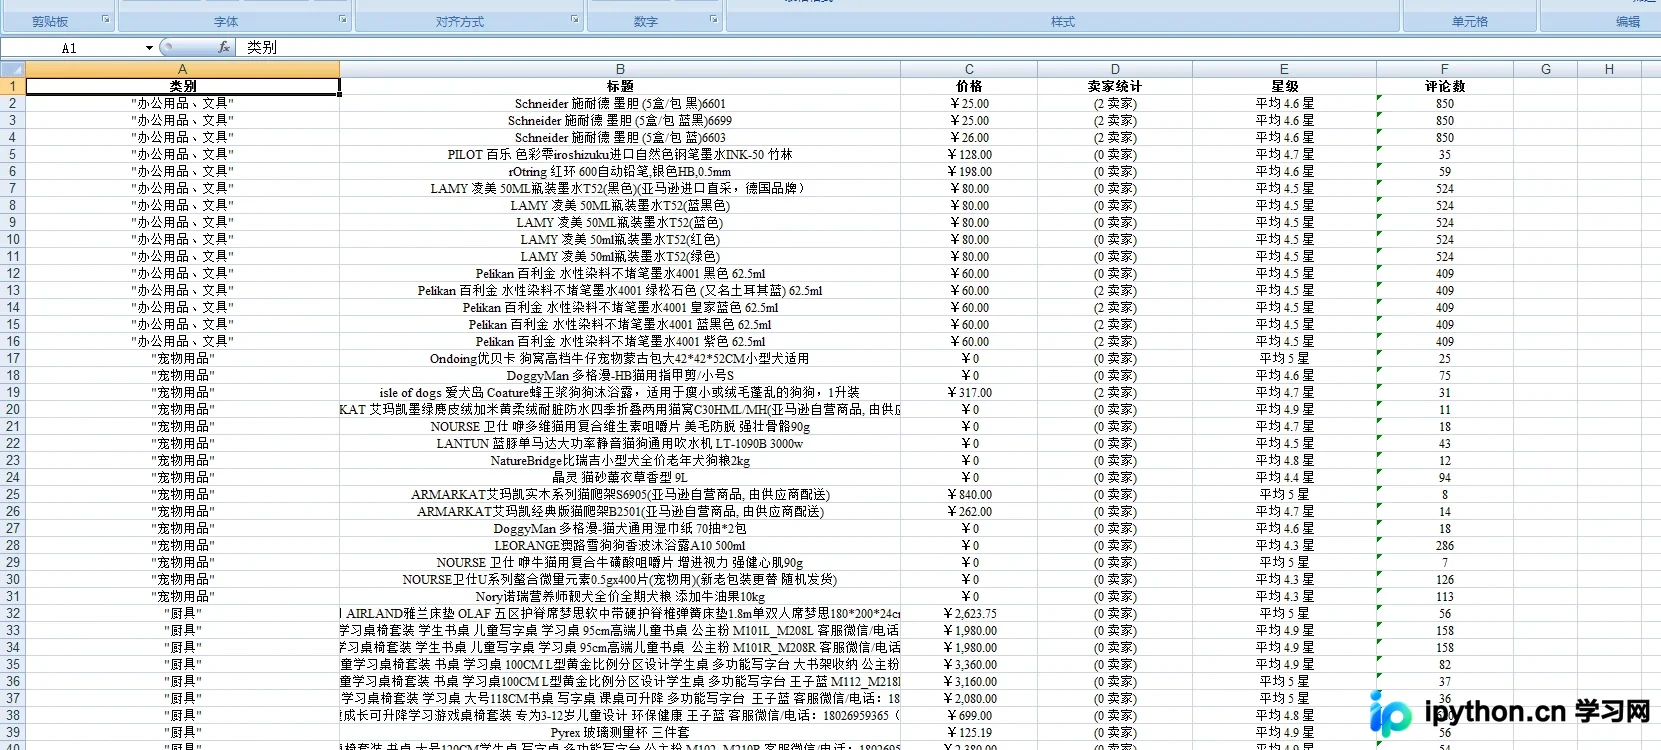
本文分享使用Python爬取亚马逊商品数据并导出为Excel文件的完整示例。内容涵盖数据抓取逻辑、异常处理(如乱码、IP限制、递归深度等)以及使用PyInstaller将脚本打包为可执行exe文件的具体命令与注意事项,适合希望快速实现数据采集功能的开发者参考。
本文深入分析scrapy-redis框架源码,指出其默认仅支持GET请求的限制。通过重写RedisSpider中的make_request_from_data方法,结合FormRequest构造包含url、form_data和meta的POST请求,并演示如何将数据存入Redis以实现分布式POST抓取。