

Python 抓取微信公众号账号信息的方法

本文介绍利用 Python 通过搜狗微信搜索接口抓取微信公众号基本信息及最新文章的方法。内容涵盖从分类列表页获取公众号链接、解析详情页数据(名称、ID、主体等),并详细说明了验证码处理、链接时效性及二维码保存等注意事项。最后通过 Flask 结合 SQLite 实现结果的本地展示,并简要对比了 Sanic 框架的尝试过程。
Python 抓取微信公众号信息:搜狗搜索爬虫实战与 Flask 展示
搜狗微信搜索支持两种关键词检索模式:一是搜索公众号发布的文章内容,二是直接搜索微信公众号本身。利用公众号搜索功能,可以获取公众号的基础资料以及最近发布的10篇文章列表。本文将演示如何抓取微信公众号的账号详细信息。
爬虫实现思路
爬虫实现思路
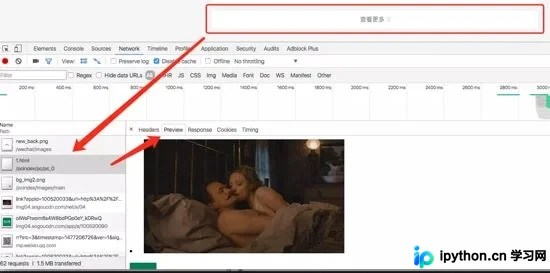
首先从搜狗微信首页进入,可以通过分类进行抓取。通过点击“查看更多”可以分析出页面链接的生成规则:
import requests as req
import re
reTypes = r'id="pc_\d*" uigs="(pc_\d*)">([\s\S]*?)</a>'
Entry = "http://weixin.sogou.com/"
entryPage = req.get(Entry)
allTypes = re.findall(reTypes, getUTF8(entryPage))
for (pcid, category) in allTypes:
  for page in range(1, 100):
    url = 'http://weixin.sogou.com/pcindex/pc/{}/{}.html'.format(pcid, page)
    print(url)
    categoryList = req.get(url)
    if categoryList.status_code != 200:
      break
上述代码通过加载更多页面来获取列表数据,进而从中提取微信公众号的详情页面链接:
reProfile = r'<li id[\s\S]*?<a href="([\s\S]*?)" rel="external nofollow" '
allProfiles = re.findall(reOAProfile, getUTF8(categoryList))
for profile in allProfiles:
  profilePage = req.get(profile)
  if profilePage.status_code != 200:
    continue
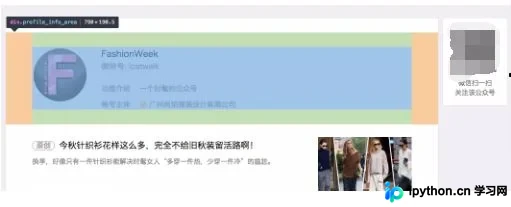
进入详情页面后,可以获取公众号的名称、ID、功能介绍、账号主体、头像、二维码以及最近发布的10篇文章等详细信息:
注意事项
注意事项
详情页面链接示例:http://mp.weixin.qq.com/profile?src=3×tamp=1477208282&ver=1&signature=8rYJ4QV2w5FXSOy6vGn37sUdcSLa8uoyHv3Ft7CrhZhB4wO-bbWG94aUCNexyB7lqRNSazua-2MROwkV835ilg==
1. 验证码问题
访问详情页面时可能会遇到验证码验证。自动识别验证码具有较高难度,因此必须做好爬虫的伪装工作以规避限制。
2. 未保存详情页面链接
详情页面的链接中包含两个关键参数:timestamp(时间戳)和 signature(签名)。这表明页面链接具有时效性,因此直接保存该链接通常无效。
3. 二维码处理
二维码图片的链接同样具有时效性,如果需要获取二维码,建议直接下载图片文件。
使用 Flask 展示结果
使用 Flask 展示结果
近期 Python 社区出现了一款基于 uvloop 和 httptools 的异步增强版 Flask 框架:Sanic。它实现了异步操作且速度更快,同时保持了与 Flask 一致的简洁语法。尽管该项目尚处于起步阶段,许多基础功能尚未完善,但已获得了广泛关注(2,222 Star)。本文原计划使用抓取的微信公众号信息,基于 Sanic 构建一个简单的交互应用。然而,由于目前尚未加入模板功能,且异步 Redis 驱动仍存在未解决的 BUG,经过简单尝试后,最终切换回使用 Flask 结合 SQLite 来呈现抓取结果,后续如有机会再进行更新。
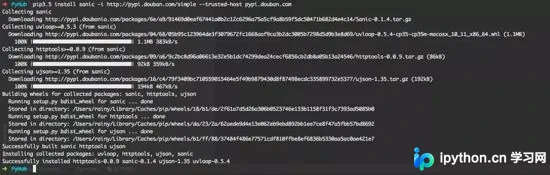
安装 Sanic
Debug Sanic
Flask + SQLite 应用示例
from flask import g, Flask, render_template
import sqlite3
app = Flask(__name__)
DATABASE = "./db/wx.db"
def get_db():
  db = getattr(g, '_database', None)
  if db is None:
    db = g._database = sqlite3.connect(DATABASE)
  return db
@app.teardown_appcontext
def close_connection(exception):
  db = getattr(g, '_database', None)
  if db is not None:
    db.close()
@app.route("/<int:page>")
@app.route("/")
def hello(page=0):
  cur = get_db().cursor()
  cur.execute("SELECT * FROM wxoa LIMIT 30 OFFSET ?", (page*30, ))
  rows = []
  for row in cur.fetchall():
    rows.append(row)
  return render_template("app.html", wx=rows, cp=page)
if __name__ == "__main__":
  app.run(debug=True, port=8000)
总结
以上所述是小编给大家介绍的Python 抓取微信公众号账号信息,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









