

Python实现ComicReaper漫画自动爬取脚本详解
本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
2026-10-14
6

本文详细介绍使用Python 3开发ComicReaper漫画自动爬取脚本的全过程。通过解析HTML结构,利用re与urllib库提取章节标题与URL,并设置User-Agent和Referer请求头以模拟浏览器行为,实现从指定主页URL自动获取整本漫画章节目录的功能。
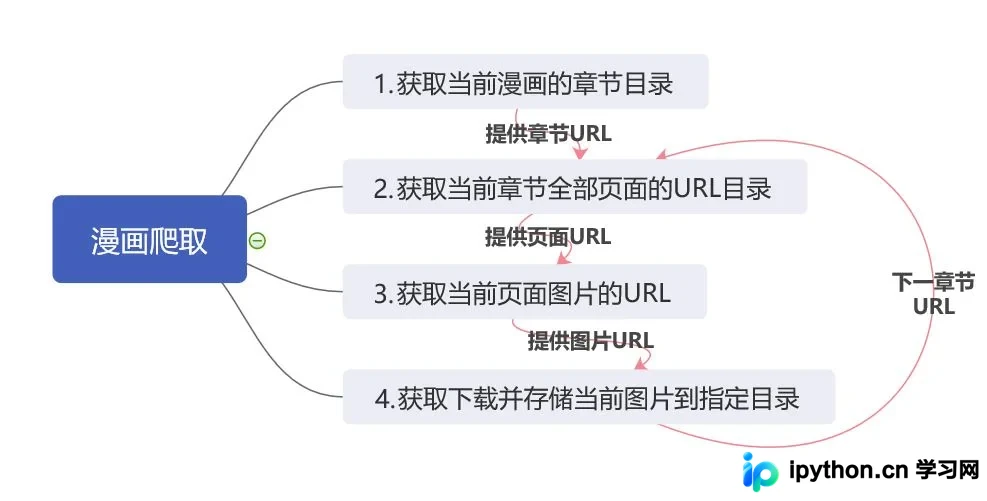
本文解析使用Python抓取B站弹幕的技术流程。针对B站数据异步加载特性,通过浏览器开发者工具定位包含oid的XML请求接口。利用正则表达式从视频页面解析cid和aid,构造API请求获取弹幕文件。文章提供完整代码示例,展示如何从视频链接到最终获取弹幕数据的完整步骤。
本文详解如何使用Python抓取猫眼电影TOP100榜单及电影天堂数据,涵盖静态页面分析、正则表达式提取、User-Agent随机切换及编码处理技巧。重点演示将爬取数据持久化存储至本地CSV文件、MySQL数据库(使用pymysql及executemany批量插入)及MongoDB的具体实现,并提供完整的代码框架与SQL查询示例。
本文详细介绍在Windows系统中为Python3环境安装Scrapy爬虫框架的完整流程。重点讲解通过wheel文件手动安装lxml、zope.interface、pyOpenSSL、Twisted及pywin32等关键依赖项的方法,并针对Python 3.6版本常见的Python.h缺失报错提供具体的apt-get解决方案,帮助用户顺利搭建开发环境。
本文详细介绍如何使用Python爬取新浪微博数据,经过清洗、分词处理后,利用wordcloud和Matplotlib工具生成个性化的词云图像。教程涵盖环境配置、数据抓取、CSV保存及图片生成全流程,帮助开发者掌握从数据采集到可视化的完整技能。
本文介绍如何使用Python实现基于M3U8协议的HTML5视频资源抓取。通过解析m3u8索引文件获取TS分片链接,利用多进程与异步协程(asyncio)加速下载过程,并结合CMD命令将分散的TS文件合并为完整视频。文章还涵盖了装饰器的应用、控制台编码处理及PyInstaller打包成exe的注意事项。
本文详细介绍如何在Scrapy框架中集成Redis以实现分布式爬虫。涵盖scrapy-redis库的安装方法、Redis服务器的启动与缓存清理,以及settings.py中的关键配置参数。通过示例代码展示如何继承RedisSpider类并设置redis_key,帮助开发者高效构建高性能的分布式数据采集系统。
本文详细介绍如何在Python 2.7环境下实现每天定时启动爬虫任务。核心思路是将程序部署于Linux服务器以确保持续运行,并通过编写包含datetime和time模块的Python脚本来控制执行频率。文中提供了具体的代码示例,演示如何设置特定时间(如凌晨1点)自动触发爬虫逻辑,适合需要自动化数据采集的场景。
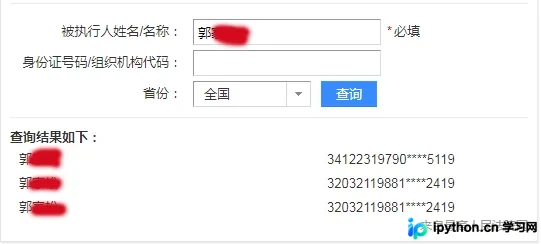
本文介绍如何使用Python编写爬虫程序,通过调用百度公开接口实现全国失信被执行人名单的批量查询功能。文章提供了两个版本的代码示例,分别展示基础姓名与身份证号查询及详细信息抓取,并演示如何将结果去重后保存至Excel文件,供开发者参考学习。
本文介绍Python第三方库retrying的使用,通过retry装饰器实现函数失败时的自动重试。重点解析如何配置最大重试次数及自定义异常判断,并指出在已包含try-except的代码中混用可能导致重试失效的问题,提供优化建议。
本文详细解析Scrapy框架中Spider的四种核心爬取模式。通过具体代码示例,演示如何抓取单页数据、基于预设列表生成多页链接、识别并跟随“下一页”按钮,以及进入子链接提取深层内容。涵盖start_urls配置、parse回调处理及Request对象的使用,帮助开发者掌握不同场景下的爬虫构建技巧。
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。