

Jupyter Notebook 快捷键完整指南:命令模式与编辑模式操作详解
本文详细汇总了Jupyter Notebook中命令模式与编辑模式下的所有常用快捷键。涵盖单元管理、代码执行、文件保存及光标操作等核心功能,帮助开发者提升编码效率,快速掌握Notebook的高级操作技巧。
2026-10-14
11

本文详细汇总了Jupyter Notebook中命令模式与编辑模式下的所有常用快捷键。涵盖单元管理、代码执行、文件保存及光标操作等核心功能,帮助开发者提升编码效率,快速掌握Notebook的高级操作技巧。
本文详解Python中读取文本文件的两种常用方式:一次性读取全部内容和使用循环逐行处理。通过演示open函数、with上下文管理器及rstrip()方法,解析相对路径与绝对路径的应用,并解决逐行打印时常见的多余空行问题,帮助开发者掌握高效且规范的文件操作技巧。
本文详细讲解Python3中calendar模块的常用功能,包括如何生成指定月份的日历文本、获取当月总天数以及查询特定日期对应的星期几。通过具体代码示例,帮助开发者快速掌握时间信息的提取方法,适用于需要处理日期逻辑的开发场景。
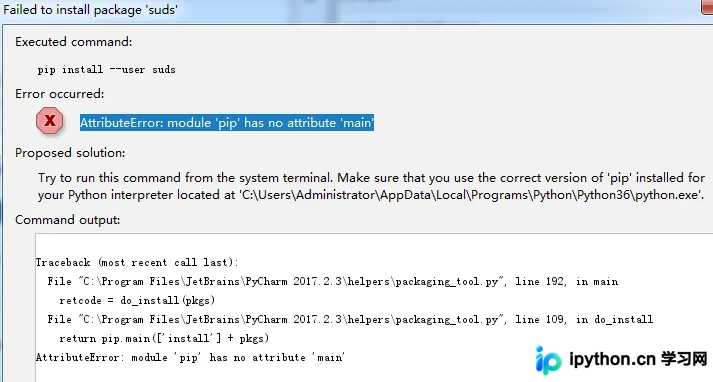
本文解决PyCharm安装第三方库时遇到的ModuleNotFoundError: No module named 'client'及NameError: name 'pip' is not defined错误。通过修改packaging_tool.py文件中的do_install和do_uninstall函数,并修正返回逻辑,配合先安装client再安装suds的命令顺序,可彻底解决该问题。
本文记录在 Scrapy 项目中自定义 Cookie 中间件时遇到的坑:即使手动控制 Request 的 meta 标志位,账号仍被封禁。经排查发现 Scrapy 内置的 CookiesMiddleware(优先级 700)会在自定义中间件(优先级 500)之后自动合并 Cookie 到 Header。解决方案是在 Request meta 中设置 dont_merge_cookies 为 true,并手动将 Cookie 写入 Header 而非 request.cookies 属性,从而避免框架自动处理。
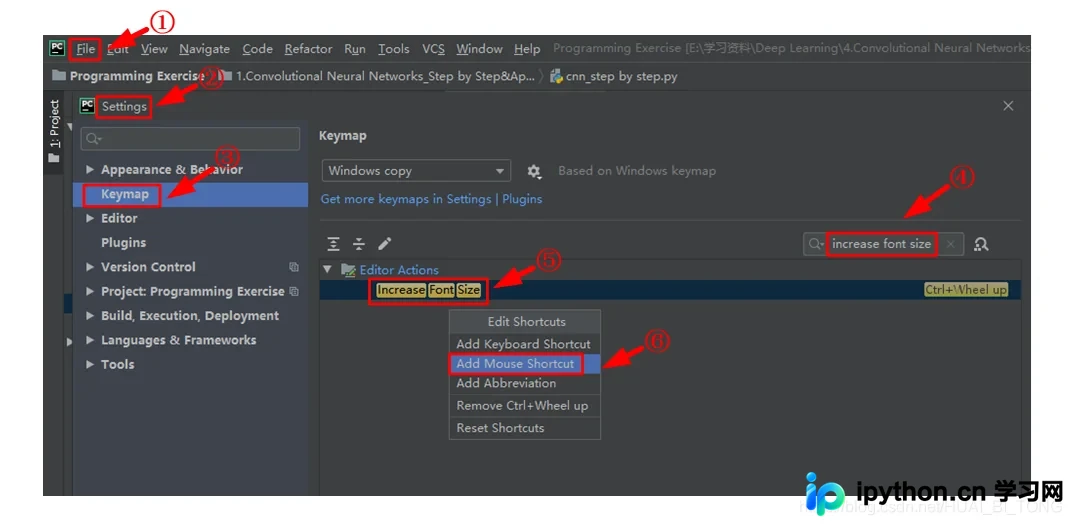
本文详细介绍如何在 PyCharm 中配置使用 Ctrl 配合鼠标滚轮来快速调整字体大小。通过修改 Keymap 中的“increase font size”和“decrease font size”命令,绑定鼠标快捷键,实现类似浏览器的缩放体验,提升编码舒适度。
本文详细讲解Python中strip()、lstrip()和rstrip()三个字符串处理函数的使用方法。重点解析strip()如何去除首尾指定字符或默认空白符,强调其参数拆解机制及中间字符保留特性。同时对比lstrip()与rstrip()在左右侧处理上的差异,通过代码示例展示参数顺序对结果无影响,帮助开发者准确掌握字符串清洗技巧。
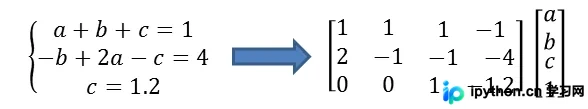
本文介绍如何使用Python的PLY库开发一个解析Protobuf文件的简单编译器。通过多元一次方程组示例,详细讲解基于lex的词法分析和基于yacc的语法分析实现过程。文章涵盖正则表达式定义Token、文法规则构建及归约动作,旨在帮助开发者掌握使用PLY处理复杂格式解析的技术要点,并提供了完整的代码参考。
本文介绍在PyCharm中高效处理重复变量名的技巧。通过多次按下Alt+J快捷键,可快速选中代码中所有相同的变量名,随后进行统一删除或重命名操作。该方法避免了全局替换可能带来的作用域误伤问题,显著提升编码效率与代码安全性。
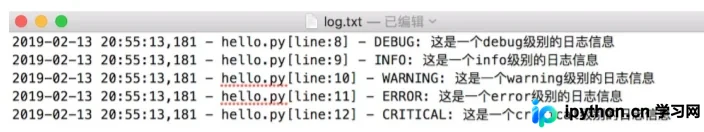
本文详细介绍Python标准库logging模块的使用方法。涵盖DEBUG至CRITICAL五个日志等级的定义与区别,讲解如何配置日志输出格式、控制台输出及文件保存。通过mini-web项目案例,演示如何在实际开发中统一配置并应用日志功能,帮助开发者高效排查Bug与分析程序运行状态。
本文详解Python中requests库模拟登录的三种方式。首先区分Cookie与Session机制,随后介绍直接使用抓包Cookie、通过字典参数传递Cookie以及利用Session对象保持会话状态的方法。文章涵盖代码示例与注意事项,帮助开发者高效实现网页数据抓取与自动化请求。
本文详细解析Windows环境下Python 3.x安装Numpy后Import失败的问题。错误通常表现为DGEBAL等参数非法值报错,根本原因在于Windows系统兼容最新Numpy版本(如1.19.4)存在运行时Bug。解决方案是卸载当前版本并强制安装稳定的1.19.3版本,通过指定版本号pip3 install numpy==1.19.3即可解决该兼容性问题。