

Python开发解析Protobuf文件的简单编译器:PLY实战指南

本文介绍如何使用Python的PLY库开发一个解析Protobuf文件的简单编译器。通过多元一次方程组示例,详细讲解基于lex的词法分析和基于yacc的语法分析实现过程。文章涵盖正则表达式定义Token、文法规则构建及归约动作,旨在帮助开发者掌握使用PLY处理复杂格式解析的技术要点,并提供了完整的代码参考。
引言与背景
引言
近期使用Python完成了一个用于解析Protobuf文件的简易编译器,深刻体会到PLY在实现词法分析和语法分析时的简洁与便捷。趁记忆清晰,整理部分总结与心得,供Python开发者参考。
PLY使用
PLY库简介与学习建议
简介
若非从事编译器或解析器开发,可能未曾听闻PLY。PLY是基于Python实现的lex和yacc工具,其作者正是《Python Cookbook》第三版的主编。部分业务开发人员或许疑惑:为何需要自行编写编译器?正如业界专家所言,应多尝试新技术。掌握语法解析技巧,对于后续处理复杂日志或数学公式解析极具帮助。
针对缺乏编译原理基础的读者,强烈建议先了解文法相关基本概念。虽然轮子哥推荐的《Parsing Techniques》和《编译原理》(龙书)经典,但不太适合入门。此处推荐胡伦俊编著的《编译原理》(电子工业出版社),书中概念讲解配有大量实例,非常适合初学者。无需深入研究,仅需掌握词法分析和语法分析的基本概念与方法,即可顺畅使用PLY。文档链接:http://www.pchou.info/open-source/2014/01/18/52da47204d4cb.html
为便于上手,本文以求解多元一次方程组为例,演示PLY的具体用法。
多元一次方程组解析示例
例子说明
输入为多个格式如“x + 4y - 3.2z = 7”的一次方程。为简化示例,设定以下限制条件:
- 每个方程中变量部分位于等号左侧,常数项位于右侧
- 每个方程不限制变量数量及顺序,但同一变量在单个方程中仅允许出现一次
- 变量命名规则为小写字母串(如x、y、xx、yy、abc均为合法变量名)
- 变量系数限制为整数或浮点数,不支持1.4e8等科学计数法格式;系数与变量紧邻,且系数不为0
- 方程组内部及方程组之间使用逗号(,)或分号(;)分隔
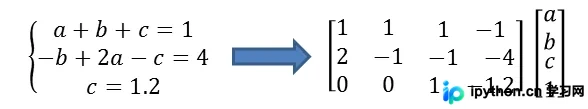
具备线性代数基础的读者可知,只需将方程组抽象为矩阵,即可利用线性代数方法求解。因此,只需将输入方程组解析为右侧矩阵和变量列表,后续求解过程即可交由线性代数相关工具处理。
基于Lex的词法解析实现
词法解析
在PLY中,使用lex模块进行词法解析。尽管词法解析理论繁杂,但lex的使用十分直观,即通过正则表达式将文本字符串解析为一系列Token。以下代码展示了使用lex实现词法解析的过程。
from ply import lex

# 空格 制表符 回车这些不可见符号都忽略
t_ignore = ' \t\r'

# 解析错误的时候直接抛出异常
def t_error(t):
  raise Exception('error {} at line {}'.format(t.value[0], t.lineno))

# 记录行号,方便出错定位
def t_newline(t):
  r'\n+'
  t.lexer.lineno += len(t.value)

# 支持c++风格的\\注释
def t_ignore_COMMENT(t):
  r'\/\/[^\n]*'

# 变量的命令规则
def t_VARIABLE(t):
  r'[a-z]+'
  return t

# 常数命令规则
def t_CONSTANT(t):
  r'\d+(\.\d+)?'
  t.value = float(t.value)
  return t

# 输入中支持的符号头token,当然也支持t_PLUS = r'\+'的方式将加号定义为token
literals = '+-,;='
tokens = ('VARIABLE', 'CONSTANT')


if __name__ == '__main__':
  data = '''
  -x + 2.4y + z = 0; //this is a comment
  9y - z + 7.2x = -1;
  y - z + x = 8
  '''

  lexer = lex.lex()
  lexer.input(data)
  while True:
    tok = lexer.token()
    if not tok:
      break
    print tok
直接运行该文件即可打印出解析后的Token串,具体输出如下所示。详细使用文档可参考PLY官方文档。
基于Yacc的语法解析与总结
LexToken(-,'-',2,5)
LexToken(VARIABLE,'x',2,6)
LexToken(+,'+',2,8)
LexToken(CONSTANT,2.4,2,10)
LexToken(VARIABLE,'y',2,13)
LexToken(+,'+',2,15)
LexToken(VARIABLE,'z',2,17)
LexToken(=,'=',2,19)
LexToken(CONSTANT,0.0,2,21)
LexToken(;,';',2,22)```

### 语法解析

ply中的yacc用作语法分析,虽然复杂的词法分析可以代替简单的语法分析,但类似于编程语言的解析再复杂的词法分析也胜任不了。在使用yacc之前,需要了解上下文无关文法,这部分内容太多太杂,我也只了解部分简单的概念,有兴趣的可以看一看编译原理深入了解。

目前语法分析的方法有两大类,即自下向上的分析方法和自上而下的分析方法。所谓自上而下的分下法就是从文法的开始符号出发,根据文法规则正向推到出给定句子的一种方法,或者说,从树根开始,往下构造语法树,直到建立每个树叶的分析方法。代表算法是LL(1),此算法文法解析能力不强,对文法定义要求比较高,主流的编译器都没有使用。自下而上的分析法是从给定的输入串开始,根据文法规则逐步进行归约,直至归约到文法的开始符号,或者说从语法书的末端开始,步步向上归约,直至归约到根节点的分析方法。代表算法有SLR、LRLR,ply使用的就是LRLR。

因此我们只需要定义文法和规约动作即可,以下就是完整的代码。

```python
# -*- coding=utf8 -*-

from ply import (
  lex,
  yacc
)

# 空格 制表符 回车这些不可见符号都忽略
t_ignore = ' \t\r'

# 解析错误的时候直接抛出异常
def t_error(t):
  raise Exception('error {} at line {}'.format(t.value[0], t.lineno))

# 记录行号,方便出错定位
def t_newline(t):
  r'\n+'
  t.lexer.lineno += len(t.value)

# 支持c++风格的\\注释
def t_ignore_COMMENT(t):
  r'\/\/[^\n]*'

# 变量的命令规则
def t_VARIABLE(t):
  r'[a-z]+'
  return t

# 常数命令规则
def t_CONSTANT(t):
  r'\d+(\.\d+)?'
  t.value = float(t.value)
  return t

# 输入中支持的符号头token,当然也支持t_PLUS = r'\+'的方式将加号定义为token
literals = '+-,;='
tokens = ('VARIABLE', 'CONSTANT')

# 顶层文法,规约的时候equations对应的p[1]是一个列表,包含了方程左边各个变量与系数还有方程左边的常数
def p_start(p):
  """start : equations"""
  var_count, var_list = 0, []
  for left, _ in p[1]:
    for con, var_name in left:
      if var_name in var_list:
        continue
      var_list.append(var_name)
      var_count += 1

  matrix = [[0] * (var_count + 1) for _ in xrange(len(p[1]))]
  for counter, eq in enumerate(p[1]):
    left, right = eq
    for con, var_name in left:
      matrix[counter][var_list.index(var_name)] = con
    matrix[counter][-1] = -right

  var_list.append(1)
  p[0] = matrix, var_list

# 方程组对应的文法,每个方程用,或者;做分隔
def p_equations(p):
  """equations : equation ',' equations
         | equation ';' equations
         | equation"""
  if len(p) == 2:
    p[0] = [p[1]]
  else:
    p[0] = [p[1]] + p[3]

# 单个方程对应的文法
def p_equation(p):
  """equation : eq_left '=' eq_right"""
  p[0] = (p[1], p[3])

# 方程等式左边对应的文法
def p_eq_left(p):
  """eq_left : var_unit eq_left
        |"""
  if len(p) == 1:
    p[0] = []
  else:
    p[0] = [p[1]] + p[2]

# 六种文法对应例子: x, 5x, +x, -x, +4x, -4y
# 归约的形式是一个元组,例: (5, 'x')
def p_var_unit(p):
  """var_unit : VARIABLE
        | CONSTANT VARIABLE
        | '+' VARIABLE
        | '-' VARIABLE
        | '+' CONSTANT VARIABLE
        | '-' CONSTANT VARIABLE"""
  len_p = len(p)
  if len_p == 2:
    p[0] = (1.0, p[1])
  elif len_p == 3:
    if p[1] == '+':
      p[0] = (1.0, p[2])
    elif p[1] == '-':
      p[0] = (-1.0, p[2])
    else:
      p[0] = (p[1], p[2])
  else:
    if p[1] == '+':
      p[0] = (p[2], p[3])
    else:
      p[0] = (-p[2], p[3])

# 方程等式右边对应的常数,对应的例子:1.2, +1.2, -1.2
def p_eq_right(p):
  """eq_right : CONSTANT
        | '+' CONSTANT
        | '-' CONSTANT"""
  if len(p) == 3:
    if p[1] == '-':
      p[0] = -p[2]
    else:
      p[0] = p[2]
  else:
    p[0] = p[1]

if __name__ == '__main__':
  data = '''
  -x + 2.4y + z = 0; //this is a comment
  9y - z + 7.2x = -1;
  y - z + x = 8
  '''

  lexer = lex.lex()
  parser = yacc.yacc(debug=True)
  lexer.lineno = 1
  s = parser.parse(data)
  print s
直接运行文件即可,所得输出如下,随后可依据线性代数方法求解各变量值。
([[-1.0, 2.4, 1.0, -0.0], [7.2, 9.0, -1.0, 1.0], [1.0, 1.0, -1.0, -8.0]], ['x', 'y', 'z', 1])
总结
依托Python简洁的语法,PLY为我们提供了强大的语法分析工具。更复杂的示例可参考https://github.com/LiuRoy/proto_parser,这是我使用PLY实现的简易Protobuf解析器,旨在减少频繁生成中间文件的需求。拥有此类工具,开发效率显著提升!
以上为Python开发解析Protobuf文件简单编译器的详细内容,更多关于Python开发编译器的资料请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









