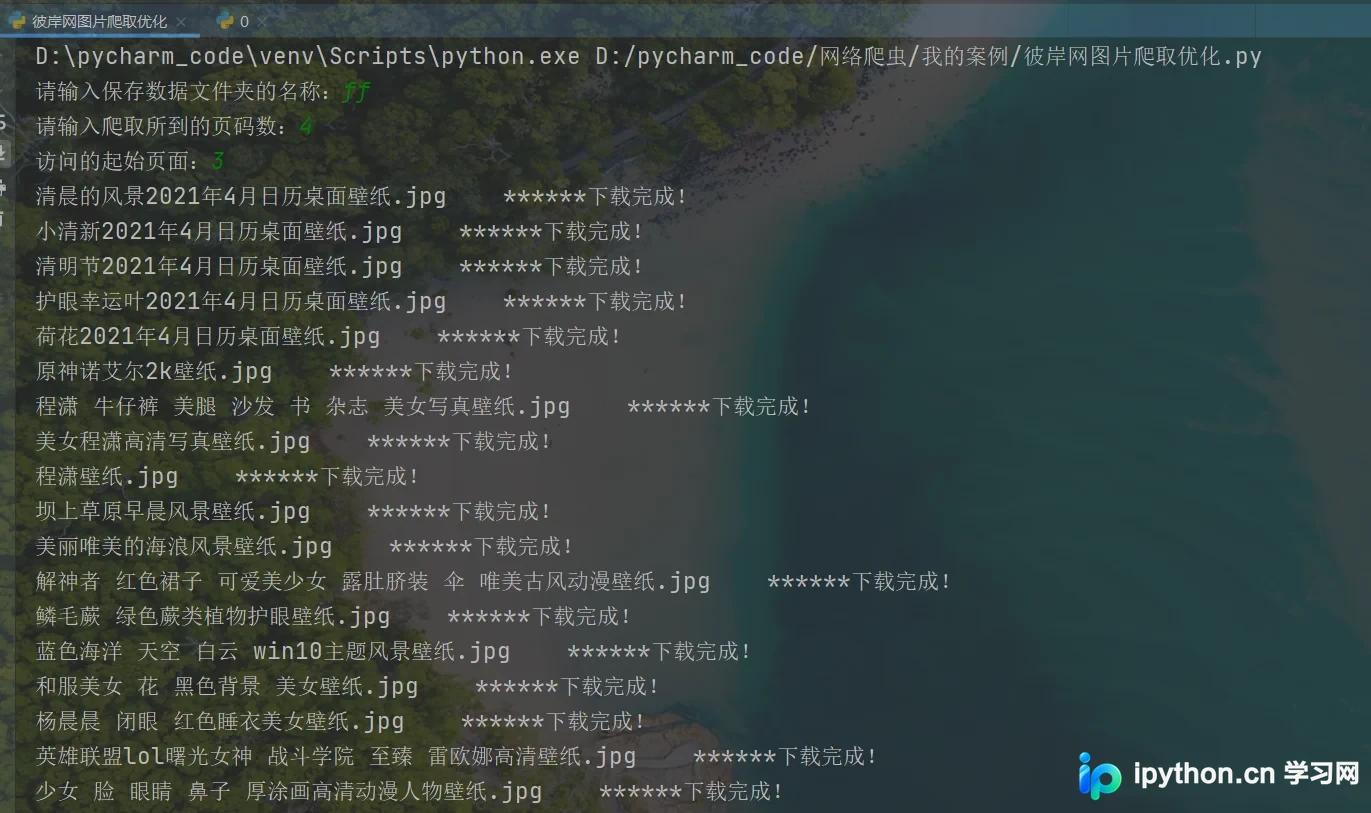
Python实现按关键词分类下载百度图片并保存至独立文件夹
本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
2026-10-14
8

本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
本文深入解析Python中Lambda函数的5种核心用法,包括命名使用、与map/filter/reduce配合、作为key参数、立即调用表达式及闭包应用。通过对比传统函数与列表推导式,展示Lambda在简化代码、提升优雅度方面的优势,帮助开发者掌握这一函数式编程利器。
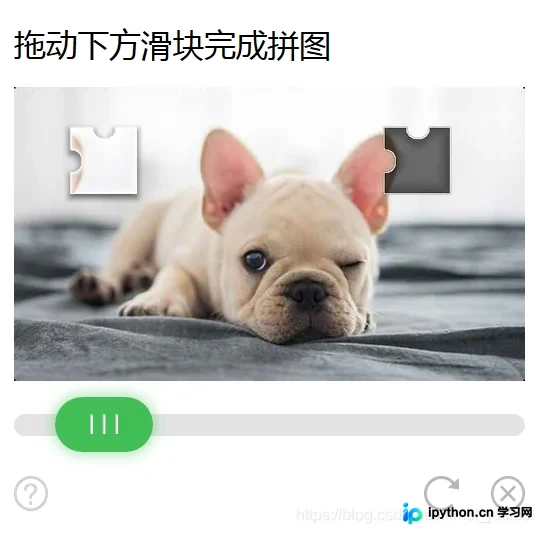
本文详解如何利用Python和OpenCV库识别滑块验证码中的缺口位置。通过读取背景与缺口图片,使用Canny算子提取边缘并转换为RGB格式,再借助matchTemplate函数进行模板匹配,最终定位最大相关系数点以获取缺口X轴坐标。文章提供完整代码封装,适用于爬虫开发中的验证码破解场景。
本文详细介绍如何结合Tushare、PyCharm和Excel进行股票数据分析。通过PyCharm安装numpy、tushare和matplotlib库,使用Tushare接口获取指定股票的历史交易数据,并导出至Excel。为解决PyCharm写入Excel时覆盖其他Sheet的问题,文章提出建立双文件同步策略,利用Excel公式实现数据自动关联,最终支持K线、MACD等技术指标分析。
本文详细介绍Python3中整数反转的多种实现方式。涵盖将数字转为字符串翻转、纯数学取余取整、栈模拟及切片操作等方法。重点解析如何处理负号、前导零以及32位有符号整数溢出边界[-2^31, 2^31-1],并提供完整代码示例与测试用例,帮助开发者深入理解算法逻辑与性能差异。
本文详解Python模块导入规范,对比import与from...import语句的优劣,指出直接调用属性可能带来的可读性问题。深入解析sys.path列表机制,演示如何通过append和insert方法动态添加搜索路径,实现多级目录下的模块导入,确保代码规范与可维护性。
本文介绍使用 Python 结合 pymysql 库实现 MySQL 数据库自动增删分区的方法。通过连接数据库查询当前最大分区日期,利用 datetime 和 dateutil 计算新分区时间并执行 ALTER TABLE 添加分区;同时查询最小分区,若超过保留期限则自动删除旧分区。脚本通过命令行参数指定主机、数据库和表名,实现自动化维护,适用于大数据量表的长期存储管理。
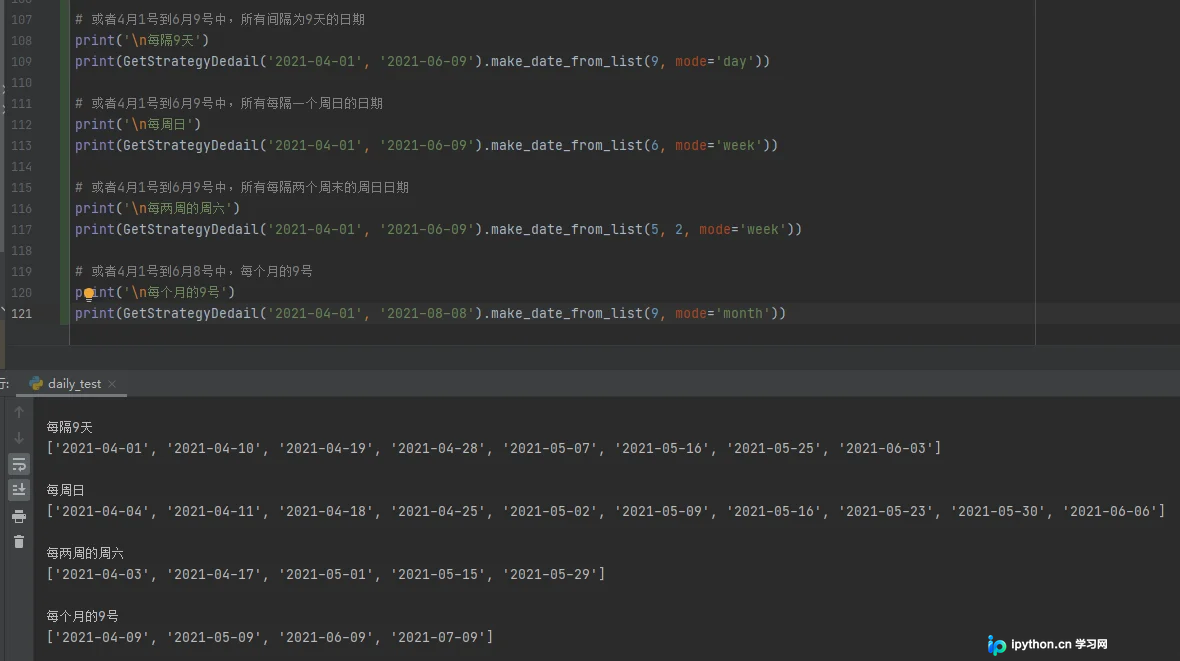
本文介绍在Python中如何生成指定时间段内符合特定规律的日期列表。通过封装GetStrategyDedail类,实现了固定天数间隔、按周几循环以及按月循环三种策略。文章提供了核心代码逻辑与make_date_from_list方法的使用示例,适用于需要自定义回归时间或周期性执行任务的场景。
本文深入解析Python中zip、map和filter三个核心内置函数的用法。通过具体代码示例,展示如何利用zip实现多序列并行遍历与字典构建,使用map对序列元素进行统一映射处理,以及借助filter结合lambda表达式筛选符合条件的数据。内容涵盖Python3中zip对象的迭代特性及实际编程技巧,帮助开发者高效处理序列数据。
本文介绍Python中统计列表元素出现次数的5种方法,包括collections.Counter、list.count、Numpy花式索引等。通过具体代码示例,展示如何获取单个或全部元素的出现频率,并讨论不同数据类型下的处理差异。
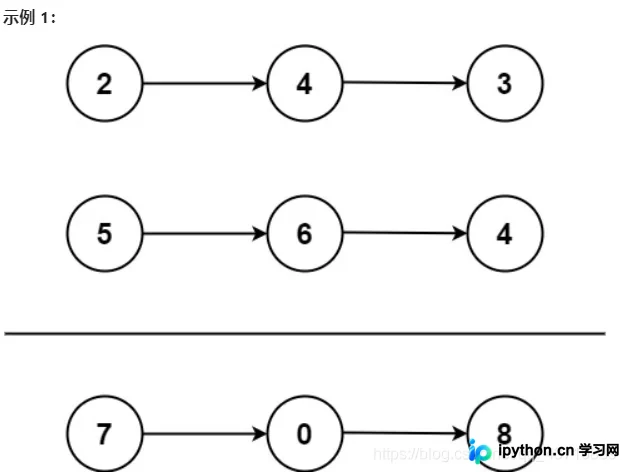
本文详细解析Python3中两个非空链表表示的非负整数相加问题。通过逆序存储特性,逐步演示如何创建新链表、处理进位及边界情况。文章对比了基础实现与优化后的代码逻辑,重点解决链表长度不一致及末尾进位问题,提供完整可运行的ListNode定义与Solution类实现,帮助开发者掌握链表遍历与节点操作技巧。
本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。