

Python使用Matplotlib和Seaborn绘制箱型图详解
本文介绍了如何在Python中使用Matplotlib和Seaborn库绘制箱型图。通过具体代码示例,详细展示了箱型图的垂直/水平显示、异常值处理、箱体样式、均值线及缺口设置等关键参数的配置方法,帮助读者快速掌握数据分布可视化技巧。
2026-10-14
8

本文介绍了如何在Python中使用Matplotlib和Seaborn库绘制箱型图。通过具体代码示例,详细展示了箱型图的垂直/水平显示、异常值处理、箱体样式、均值线及缺口设置等关键参数的配置方法,帮助读者快速掌握数据分布可视化技巧。
本文通过Python代码实例,详细讲解如何构建一个基于控制台的简单名片管理系统。内容涵盖项目结构设计、主循环逻辑、菜单显示、名片的创建、遍历展示、条件查询以及修改与删除功能。通过实际代码片段,帮助读者理解列表与字典在数据存储中的应用,以及函数模块化编程的最佳实践。
本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。
本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。
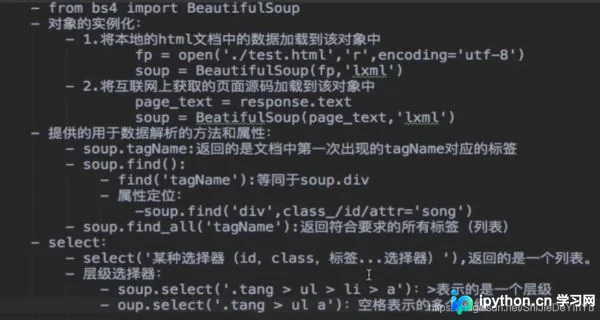
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。
本文介绍Python爬虫的基础流程,包括指定URL、发送请求及数据存储三步。详细讲解requests外部库的安装方法,并通过完整代码示例演示如何爬取搜狗首页并保存为HTML文件,帮助初学者快速掌握网络数据抓取的基本操作。
本文详解Django中Cookie机制及其在反爬虫中的应用。通过解析request对象获取Cookie,利用set_cookie方法配置max_age、expires及path等关键参数,有效限制爬虫抓取频率并隐藏生成逻辑。结合代码示例,帮助开发者构建更安全的Web应用。
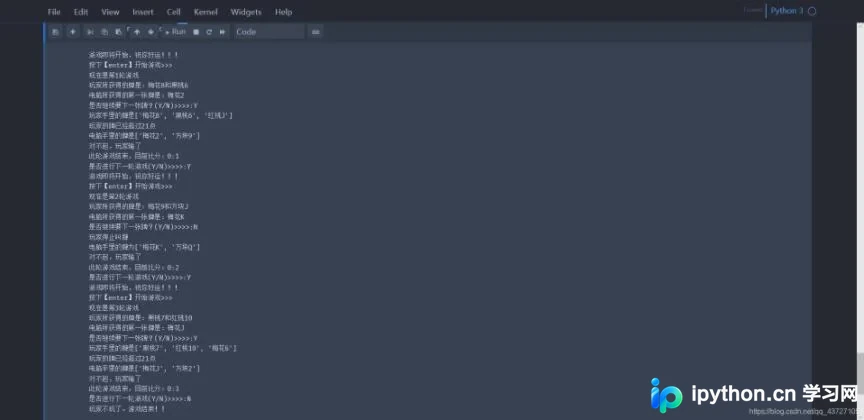
本文详细介绍如何使用Python语言实现经典的21点小游戏。内容涵盖扑克牌的初始化、洗牌算法、A牌点数动态计算规则以及多轮游戏的计分逻辑。通过完整代码示例,帮助开发者理解基础游戏逻辑与Python编程技巧的结合应用。
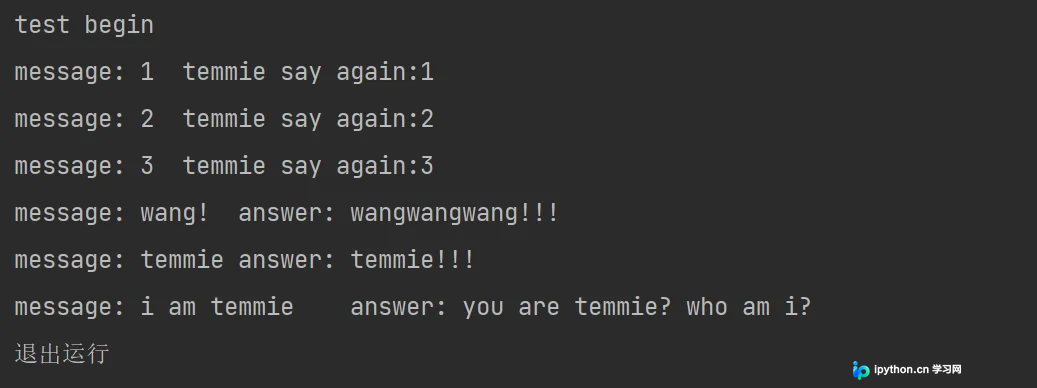
本文介绍如何利用Python的文件读写功能,结合字典匹配与定时轮询机制,开发一个简易的本地聊天机器人。通过监听指定文本文件的变化,程序可实现预设回复或复读功能,适合Python初学者理解IO操作与基础逻辑控制。
本文深入解析Python中常见的切片符号,包括[-1]获取末尾元素、[:-1]排除末尾元素、[::-1]实现逆序遍历以及[n::-1]从指定索引逆序截取。结合NumPy多维数组示例,详细演示各语法的实际效果与参数含义,帮助开发者掌握高效的数据处理技巧。
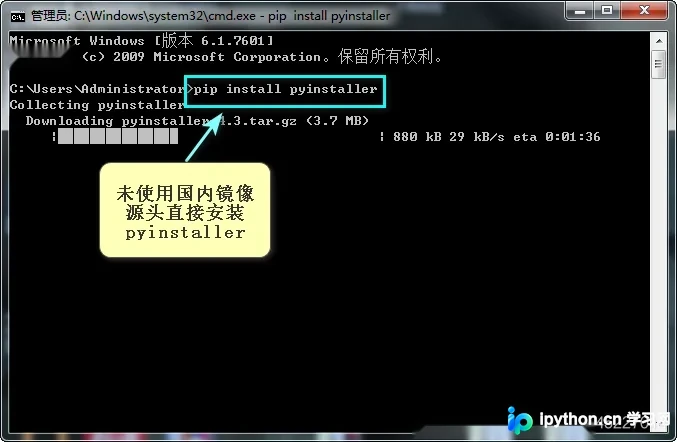
本文详细介绍如何使用PyInstaller将Python脚本打包为Windows可执行文件。内容涵盖通过pip安装PyInstaller、配置国内镜像源加速下载、使用-F参数生成单文件EXE,以及打包后运行环境的迁移与注意事项。
本文详细介绍Python中glob模块的使用方法,涵盖glob()与iglob()函数的参数、返回值及递归选项。重点解析*、?、[]等通配符的匹配规则,结合Windows与Linux路径示例,演示如何高效查找符合特定规则的文件与目录,适用于自动化脚本与文件管理场景。