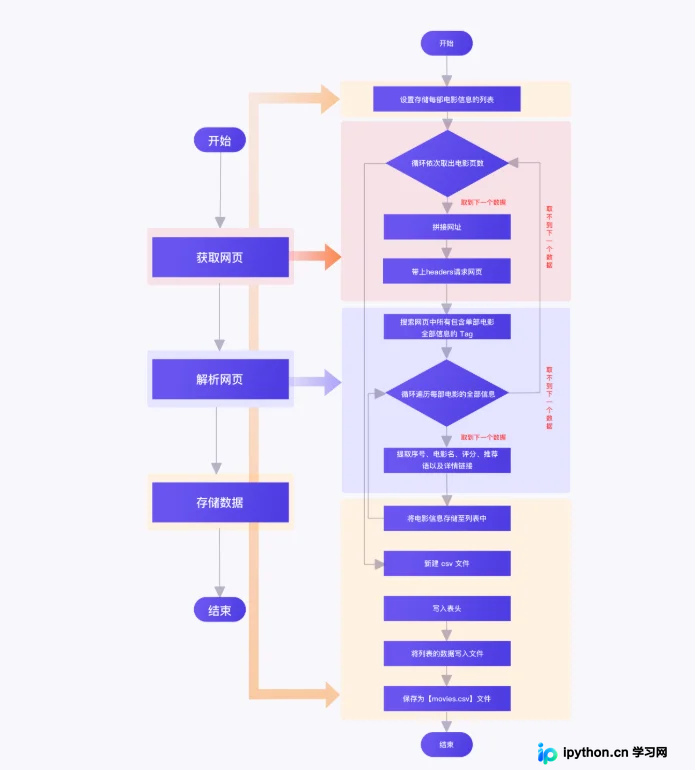
Python爬取豆瓣电影Top100实战:从请求到存储
本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。
2026-10-15
7

本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。
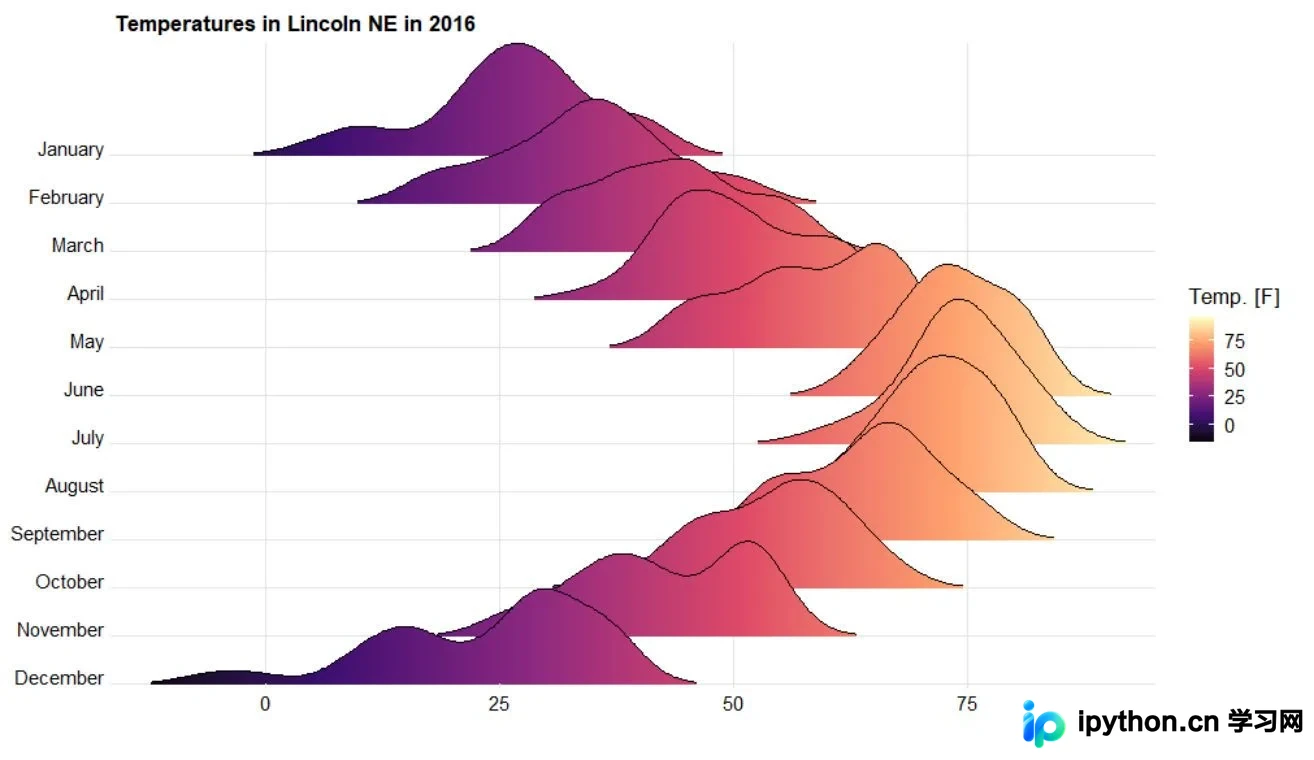
本文介绍如何使用Python的Joypy库绘制嵴线图,以展示八大城市日最高温和最低温的分布情况。通过解析数据读取、参数设置(如by、fill、alpha)及代码实现,演示多类别连续变量的分布对比方法,帮助读者掌握该可视化技巧。
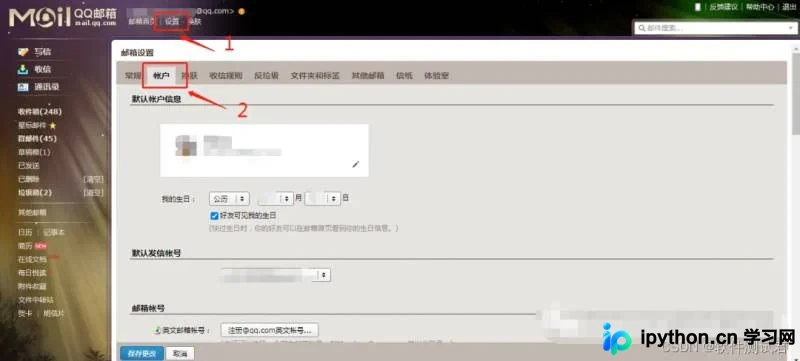
本文详解Python实现自动化发送邮件的方法。涵盖SMTP协议基础、QQ邮箱授权码开启步骤,以及使用smtplib和email库发送纯文本、HTML格式邮件及添加各类附件的具体代码实现与参数配置。
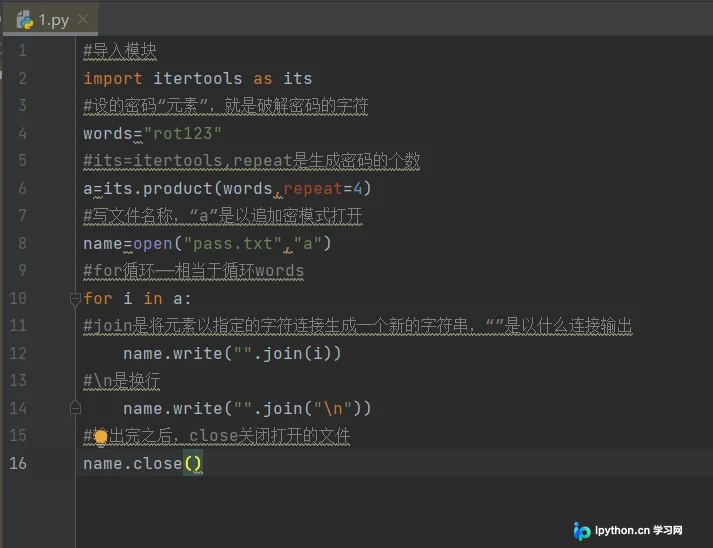
本文详细介绍如何利用Python的itertools模块生成密码字典。通过定义字符集和重复次数,程序可自动组合生成指定长度的所有可能字符串,并写入文本文件。该方法适用于安全测试中的字典生成场景,代码简洁高效,适合初学者掌握基础的文件操作与迭代工具。
本文介绍如何使用Python编写一个简单的爬虫程序,从特定图片网站批量下载图片。通过Requests发起HTTP请求获取页面源码,利用Lxml结合XPath定位封面链接及高清图片地址,最后将图片保存至本地文件夹。文章包含完整代码示例及优化建议。
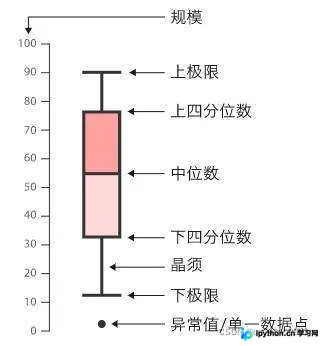
本文介绍如何使用Python的Seaborn库绘制数值箱型图,通过Boss直聘八个城市的算法岗位数据,展示不同职位的薪资分布。文章涵盖数据清洗、导入及绘图代码,重点解析箱线图、散点图叠加及辅助线的实现,帮助读者掌握多类别连续数据的对比分析方法。
本文深入解析Python中re模块的核心功能,涵盖常用方法如match、search、findall及finditer的区别。详细讲解元字符、多字符匹配规则(贪婪与非贪婪)、分组匹配及边界匹配,并通过代码示例演示数据验证、文本替换与子串提取的实际应用场景。
本文详细介绍Python程序设计的三大基本结构之一:顺序结构。重点解析赋值语句的多种写法,包括增强赋值、元组与列表分解赋值及扩展序列解包,并演示标准的输入输出语句实现方法,帮助初学者掌握程序执行的基础逻辑。
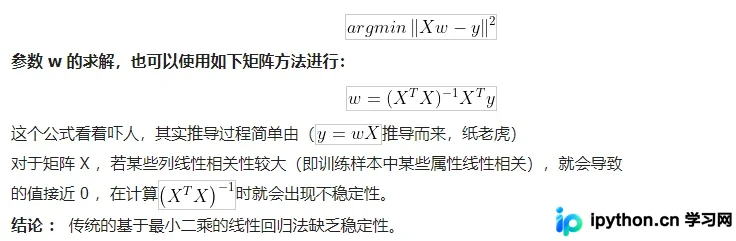
本文介绍岭回归作为处理共线性数据的有偏估计方法,对比最小二乘法与过拟合现象。详解sklearn中Ridge模型的alpha、fit_intercept等关键参数,并通过Python代码实现基于小时、星期等多维特征的交通流量多项式回归预测,展示完整数据处理与可视化过程。
本文介绍了如何使用Python和Pygame库开发一个简单的俄罗斯方块游戏。内容涵盖游戏初始化、方块定义、移动逻辑、碰撞检测及得分系统,提供了完整的代码示例供学习参考。
本文详细介绍sklearn中make_blobs函数的用法,涵盖n_features、n_samples、centers、random_state及cluster_std等核心参数的含义与配置方法,通过具体代码示例展示如何生成指定特征、样本量及方差的多类聚类数据集,并说明随机种子对结果复现的重要性。
本文详细介绍Python中Pandas库的apply函数,涵盖其函数原型、参数含义及核心用法。通过具体代码示例,演示如何对DataFrame的指定列、整体列及行进行自定义函数计算,并展示其与groupby函数结合使用的场景,帮助开发者高效处理数据。