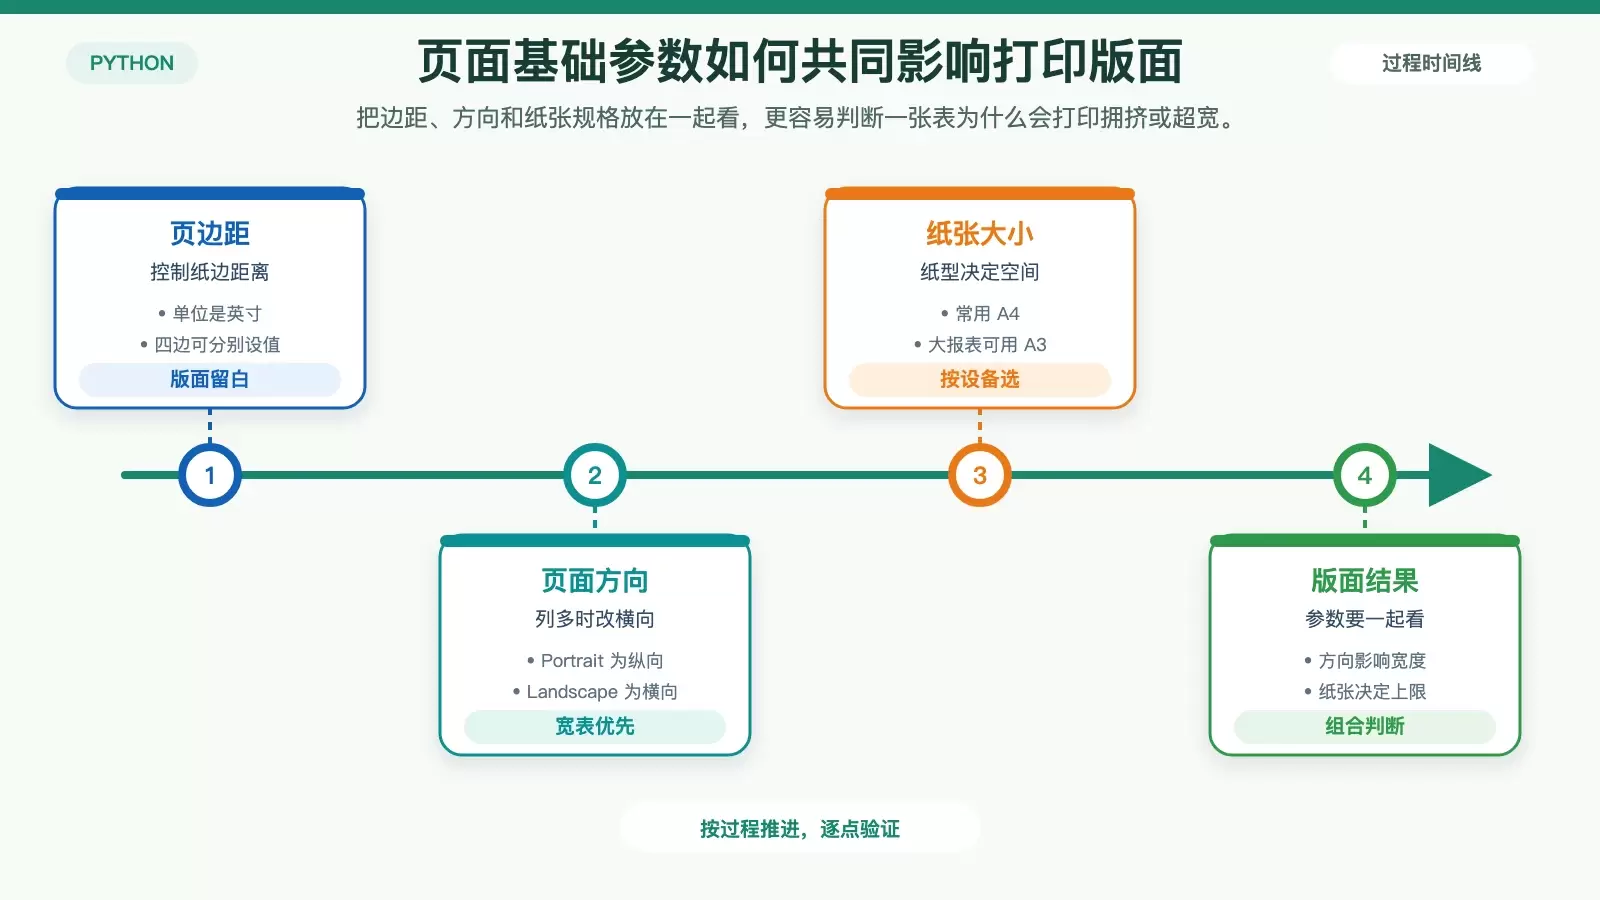
Python 实现 Excel 页面布局与打印设置自动化
用 Python 生成 Excel 时,只把数据写进去往往不够,真正到打印预览阶段,边距、方向、表头重复和缩放才决定成品是否可用。本文基于 Spire.XLS for Python,梳理几项最常用的页面设置,并给出可直接套用的综合示例。
2026-08-25
17

用 Python 生成 Excel 时,只把数据写进去往往不够,真正到打印预览阶段,边距、方向、表头重复和缩放才决定成品是否可用。本文基于 Spire.XLS for Python,梳理几项最常用的页面设置,并给出可直接套用的综合示例。
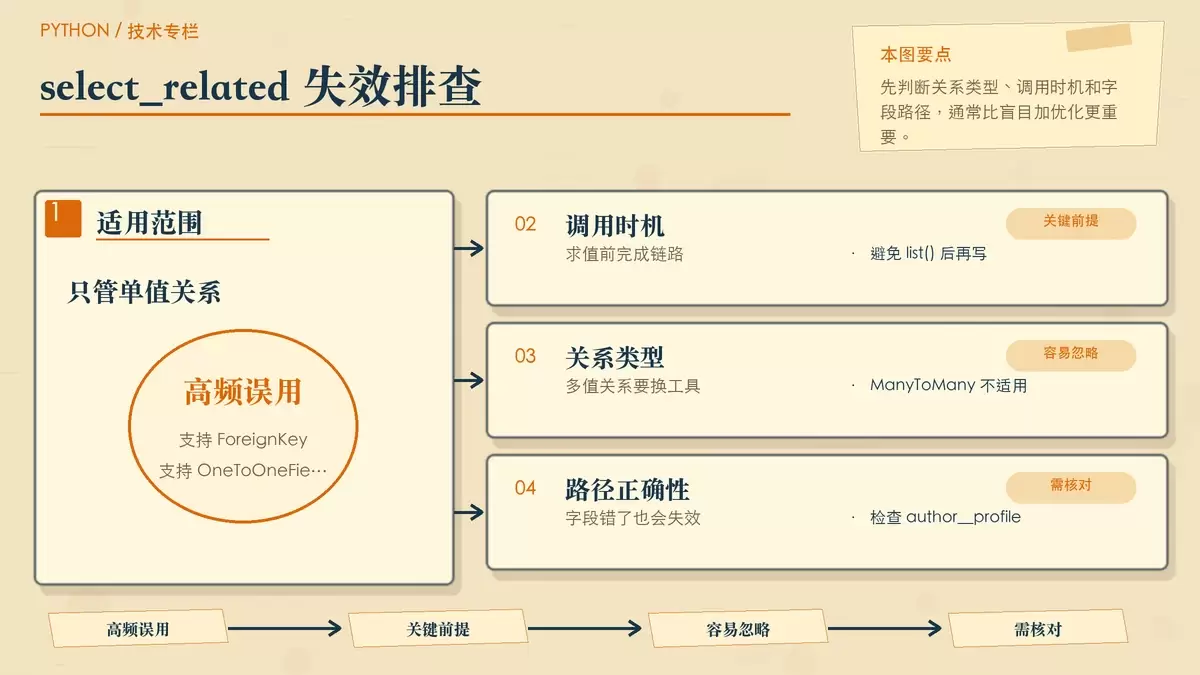
在 Django 里用了 `select_related()` 却还是出现 N+1,问题通常不在“有没有写”,而在是否用对了关系类型、调用时机和查询路径。本文把 `select_related` 的适用范围、常见失效场景、与 `prefetch_related` 的配合顺序,以及验证方法拆开讲清,方便你快速判断该用 JOIN 还是额外查询。
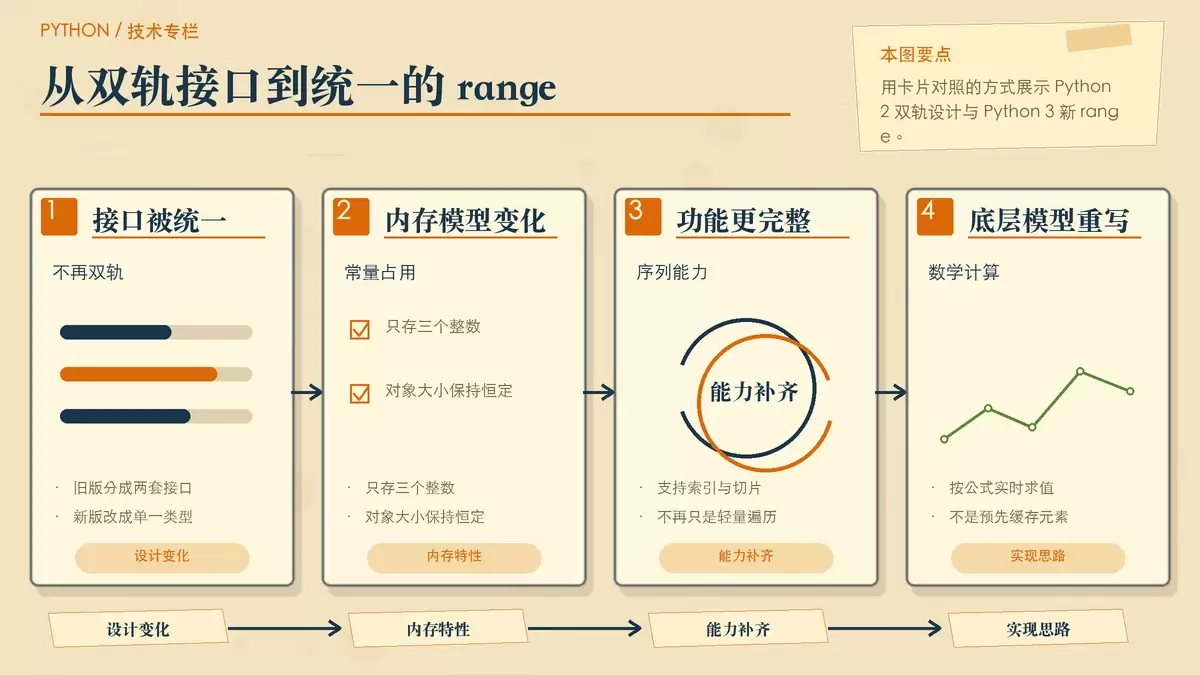
很多人把 Python 3 的 `range` 理解成“把 Python 2 的 `xrange` 改了个名字”,这其实不准确。它真正的变化是:`range` 被重写成不可变序列类型,既保留了惰性、省内存的特性,又补上了索引、切片和高效成员判断等能力。 很多人把 Python 3 里的 range 直接等同于 Python 2 的 xrange ,这能帮助记忆,却不足以指导迁移。
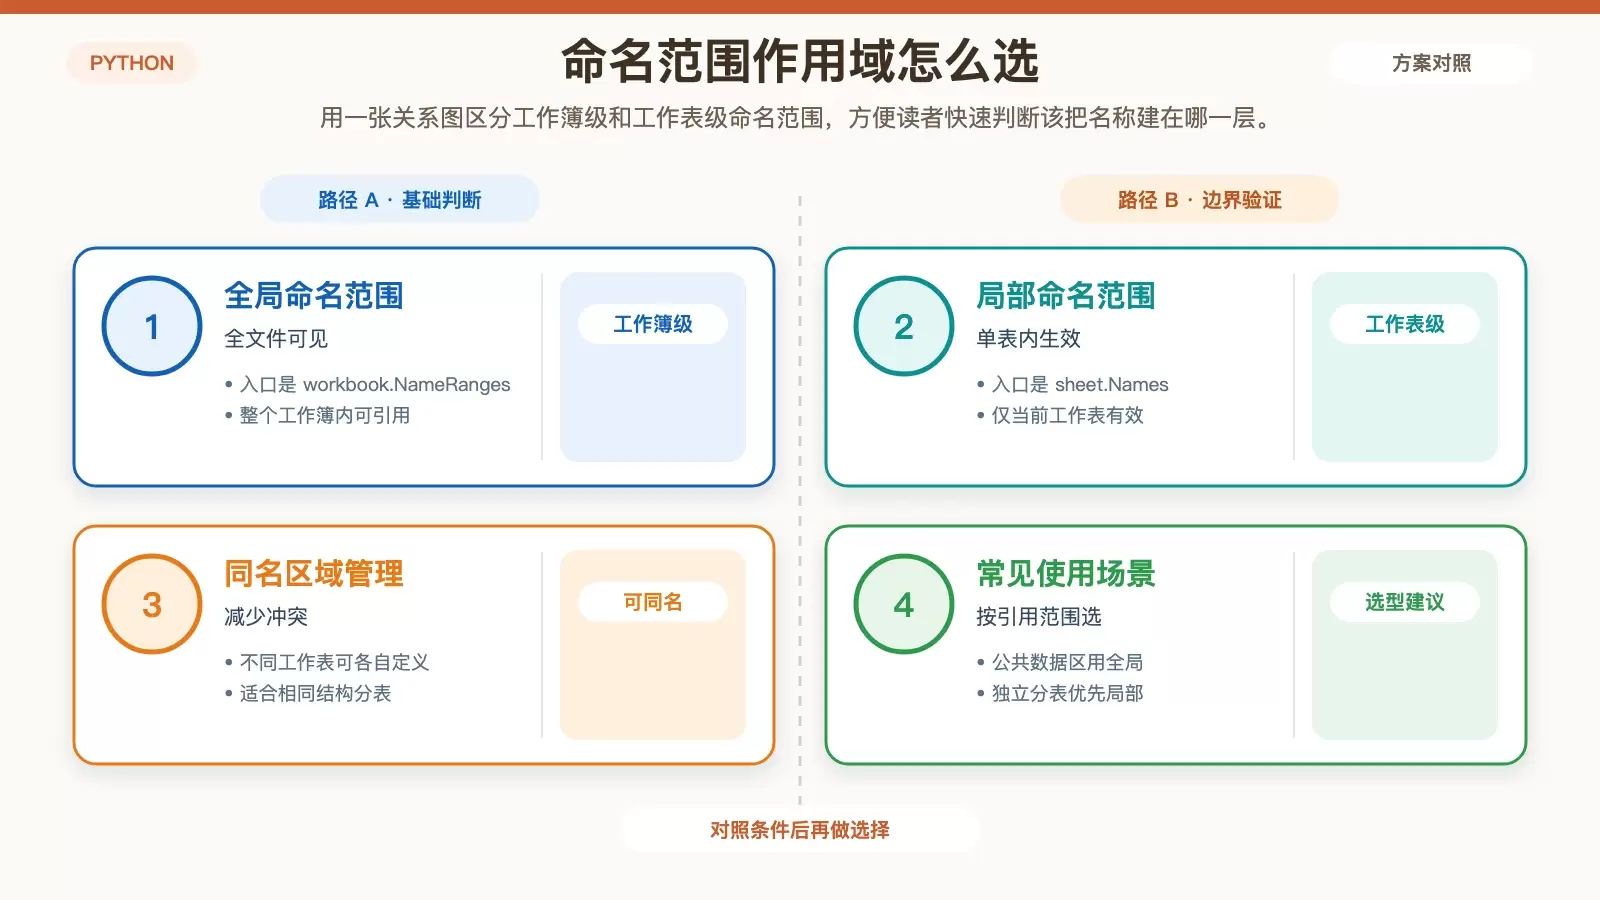
命名范围能把 Excel 里难记的 A1:D10 变成可读的业务名称,适合公式复用和自动化脚本维护。本文用 Spire.XLS for Python 梳理创建、查询、重命名、样式处理、公式引用与删除等常见操作,并说明工作簿级与工作表级作用域该怎么选。
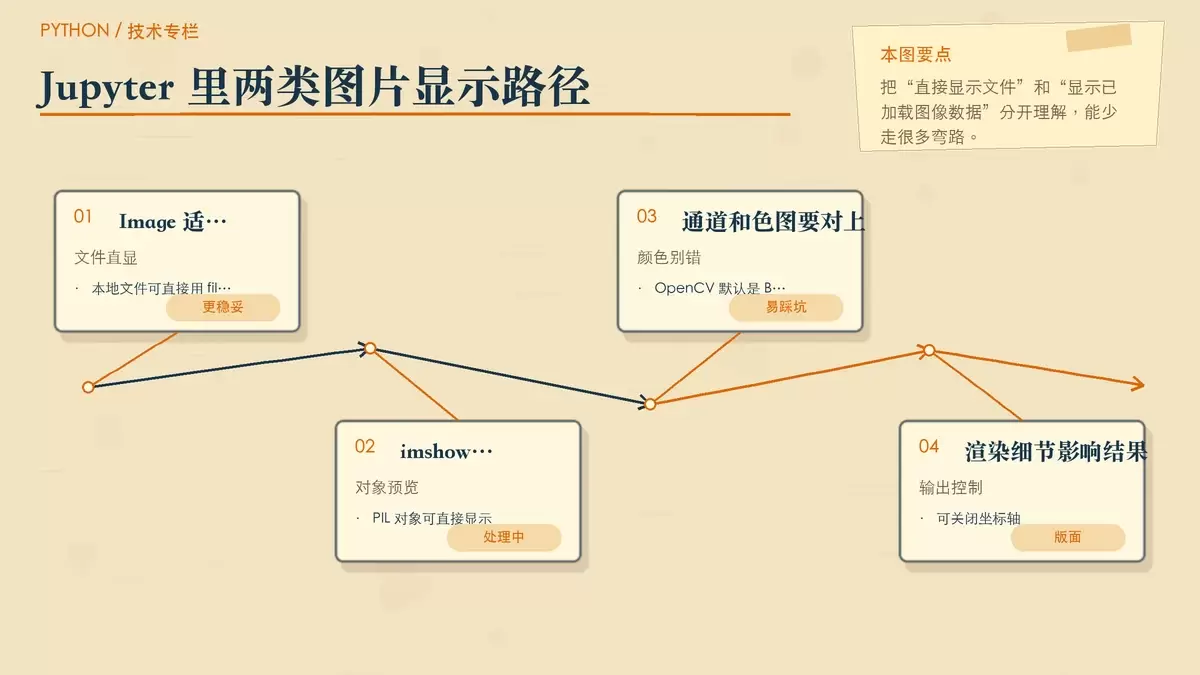
在 Jupyter Notebook 里显示图片,常见做法其实只有两条主线:直接把文件交给 IPython 渲染,或把已读入的图像数据交给 matplotlib。本文按使用场景拆开说明,并把最容易踩的路径、颜色通道和 `.show()` 误用问题一起讲清。
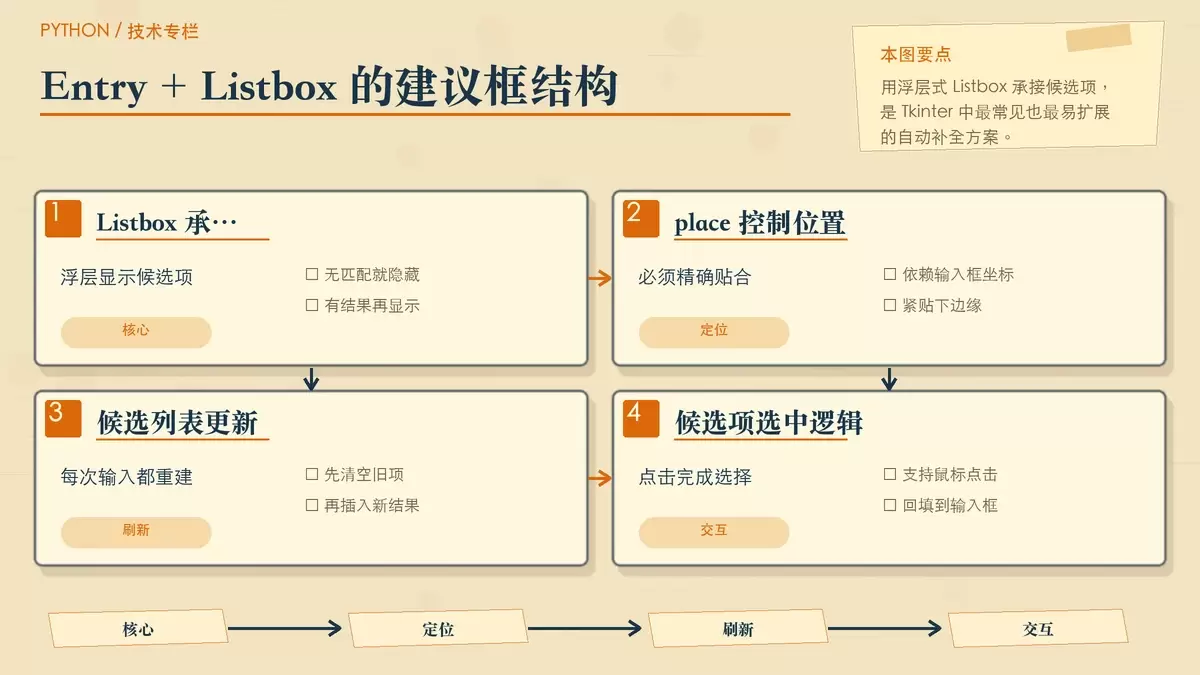
Tkinter 的 Entry 没有原生自动补全能力,常见的搜索建议框其实是 Entry、Listbox 和事件处理拼起来的交互组件。本文从为什么不能直接开箱即用讲起,再拆解轻量实现方式、Combobox 的局限,以及决定可用性的焦点、显隐和防抖细节。
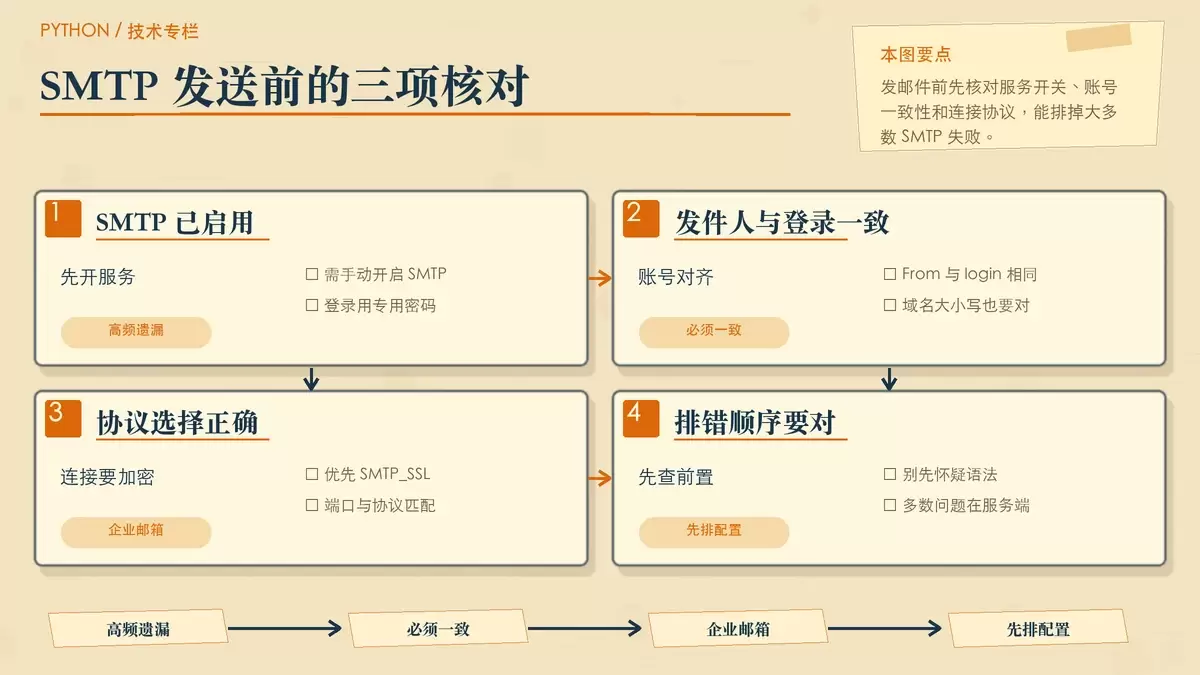
把分析结果自动推送到邮箱或企业微信,真正容易出问题的不是发送代码本身,而是鉴权、消息格式、调度稳定性和密钥管理。本文按这四个环节拆解常见报错与避坑点,并给出可直接改造的 Python 示例。
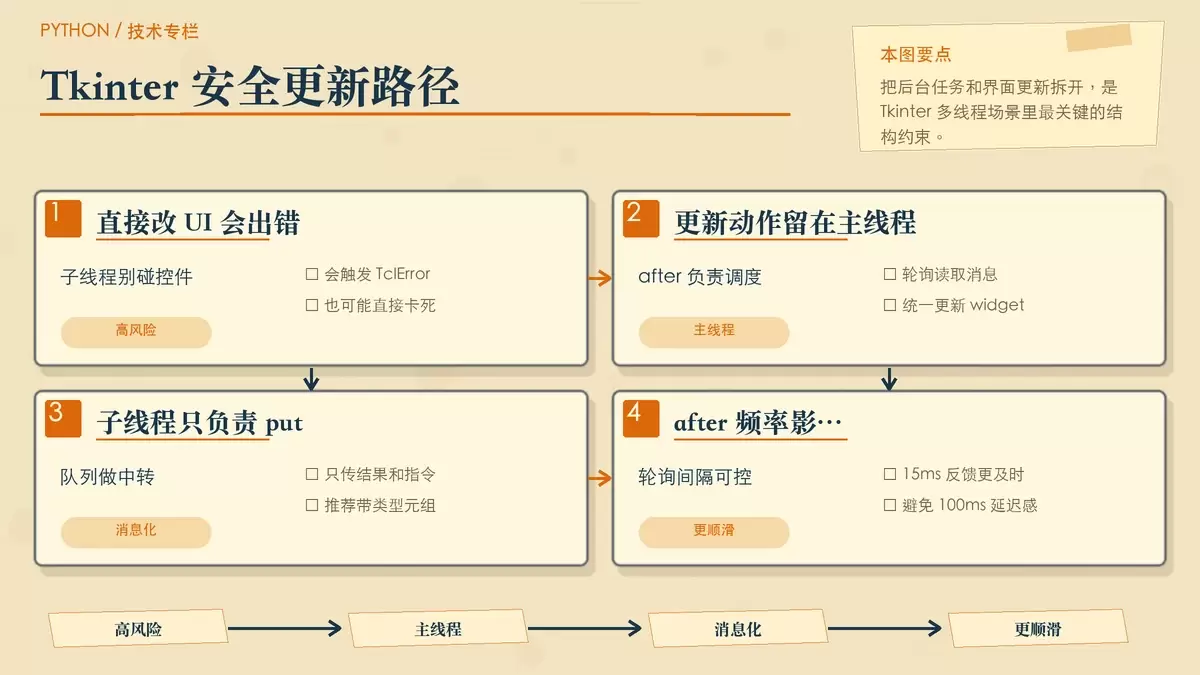
在 Tkinter 里,子线程直接改界面不是“有风险”,而是设计上就不成立。稳定做法只有一条:子线程把结果放进 `queue.Queue`,主线程借助 `root.after()` 定时取出并更新控件。文章会把原因、正确写法,以及线程池和退出清理这些常见细节一次讲清。
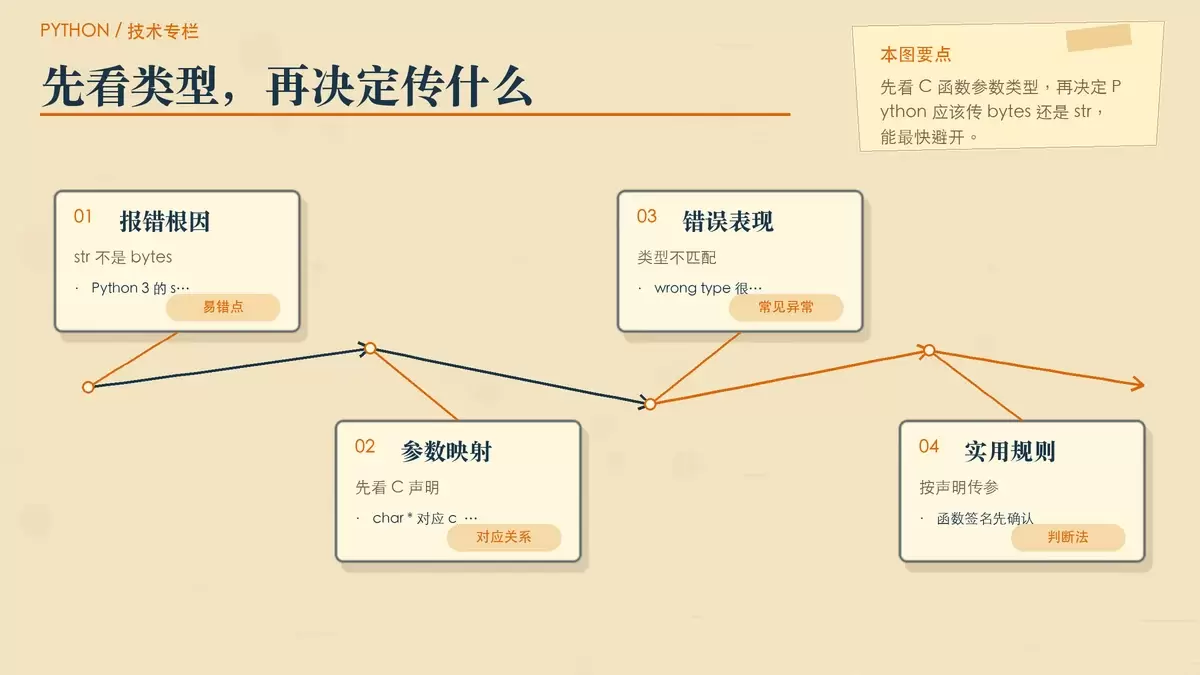
在 Python 里用 ctypes 调 C 共享库时,`char *` 参数最常见的坑就是把 `str` 直接传进去,结果触发 `ArgumentError: wrong type`。这篇文章把 `c_char_p`、`bytes`、编码方式以及 `c_wchar_p` 的适用场景拆开说明,帮你快速判断该传什么、什么时候该换类型。 用 Python 的 ctypes 调 C 共享库时,字符串参数经常在看似最简单的地方翻车:C 端写的是 char * ,Python 端却直接传了 str 。
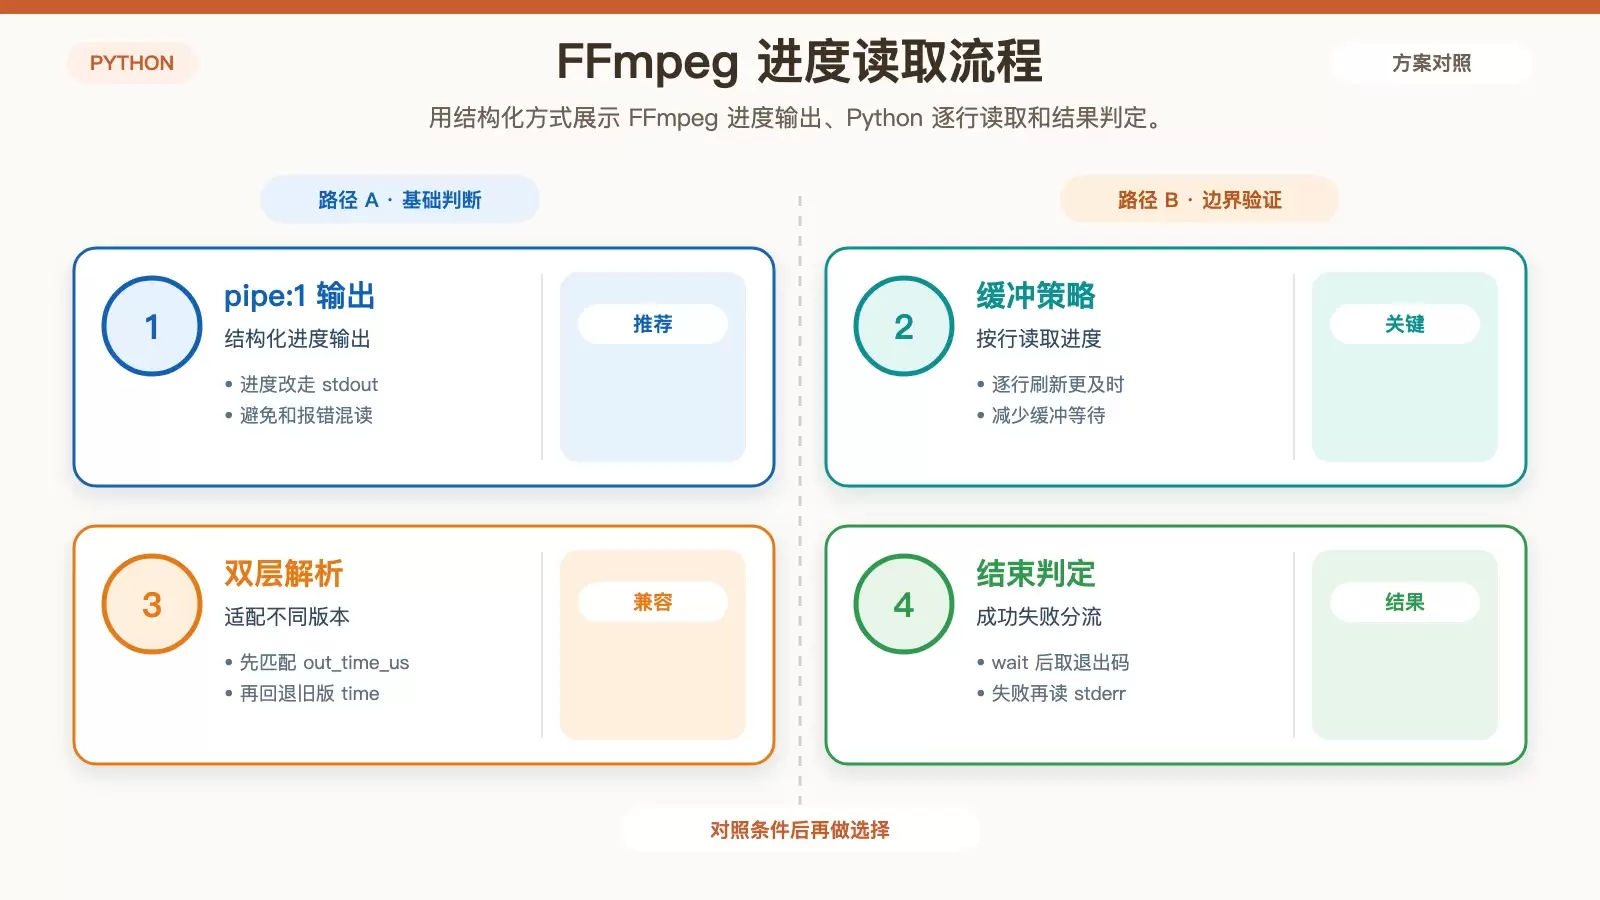
在 Python 里调用 FFmpeg 并不难,真正麻烦的是卡住、没进度、批量任务中断和 Windows 环境问题。本文按“一次性执行、实时进度、批量处理、常见报错”四个场景重组做法,保留可直接使用的命令与代码,并说明什么情况下该选 `run`、`Popen` 或 `pathlib` 组合。
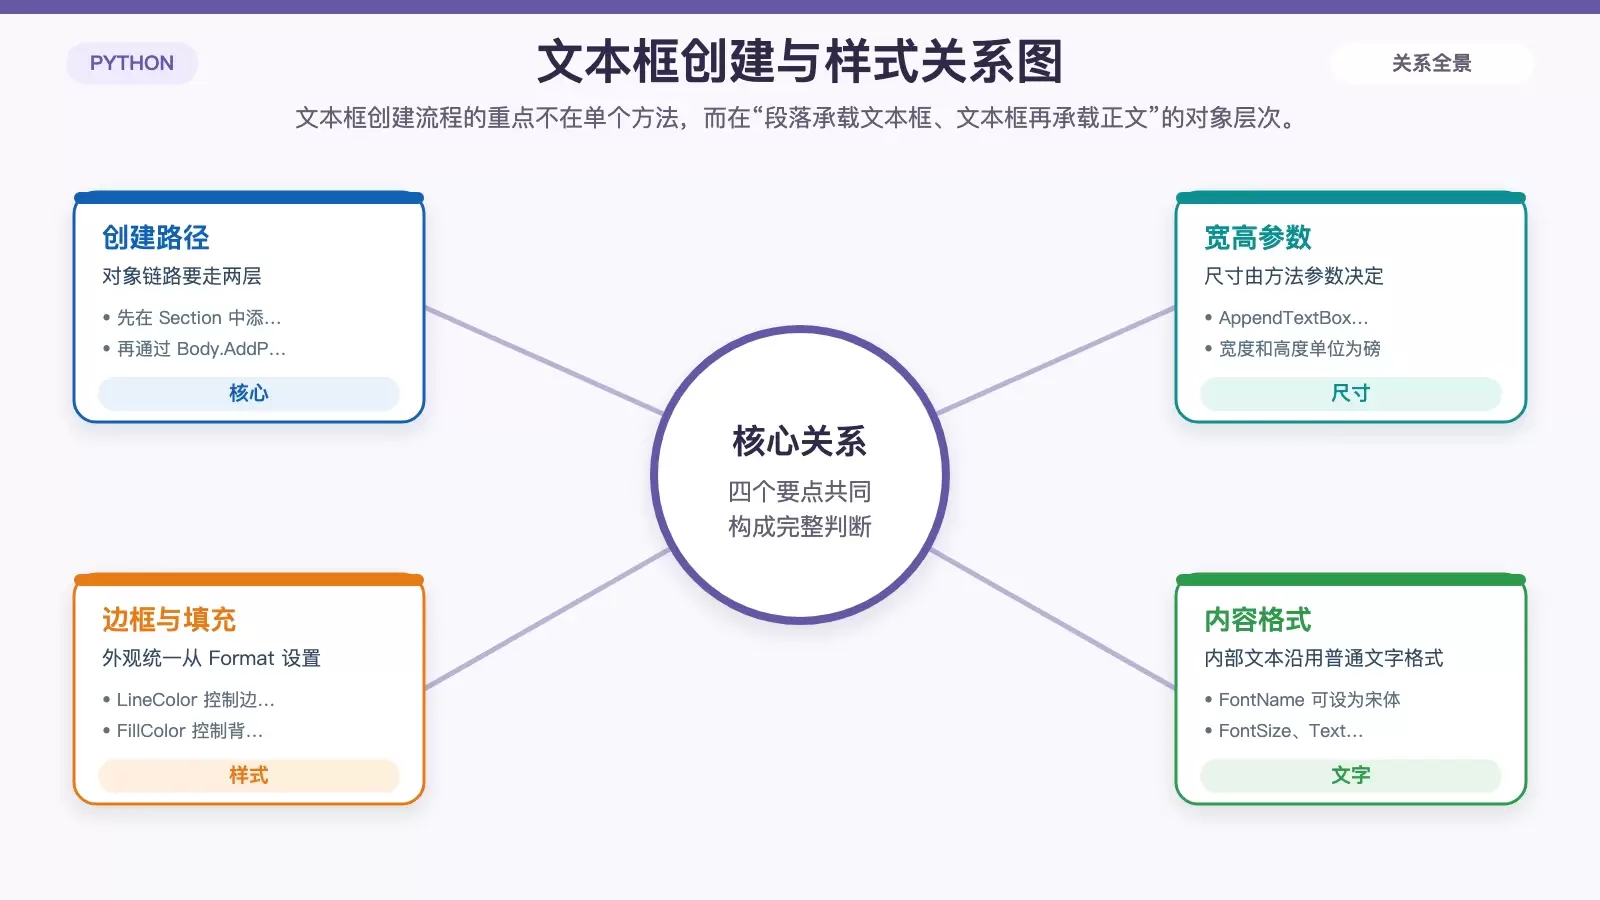
本文用 Spire.Doc for Python 梳理 Word 文本框的几个高频操作:创建、设置样式与位置、按索引删除,以及遍历提取文本框内容。文中保留完整示例代码,并补充了定位基准、内边距和批量删除时索引变化等实用细节。
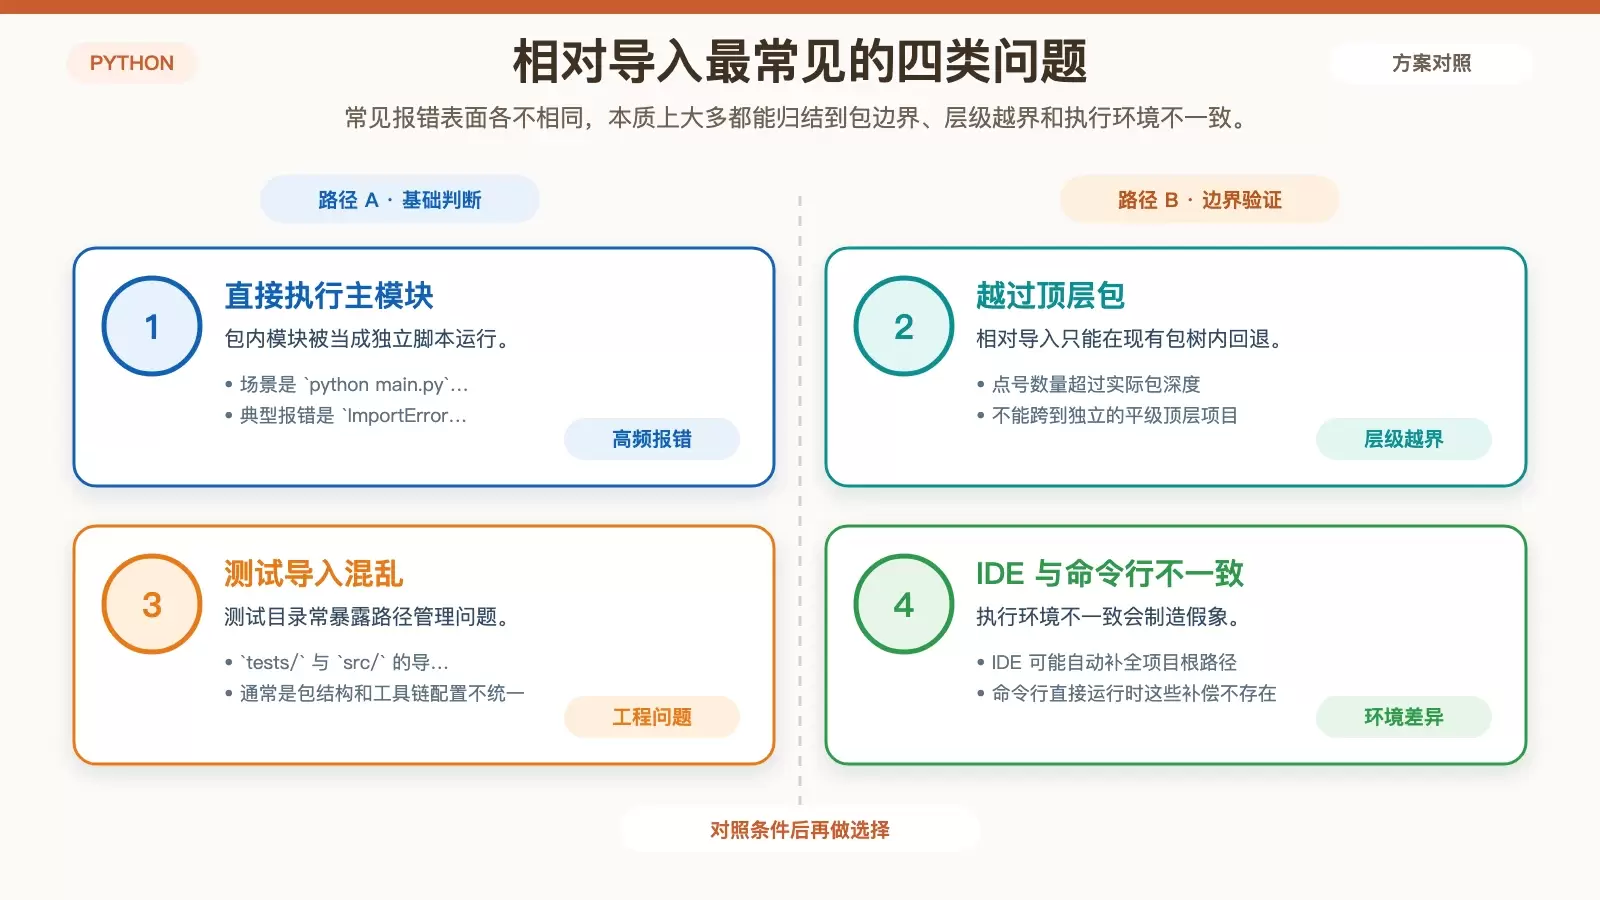
Python 的相对导入问题,表面看是语法报错,实质上是包上下文、运行方式和 `sys.path` 共同作用的结果。把 `__name__`、`__package__`、`python -m` 和标准包结构放到一条线上理解,很多“IDE 能跑、命令行就炸”的问题就能直接定位。 很多 Python 导入报错并不是代码写错,而是模块被解释器放进了错误的运行语境里。