


很多旧教程提到 Python 2 和 Python 3 的循环差异时,常会顺手说一句“xrange 被并入了 range”。这句话便于记忆,但会误导迁移判断。真正发生的事不是简单合并名字,而是 Python 3 直接用一个全新的 range 类型替换了 Python 2 里那对职责分裂的 range/xrange。
理解这一点,才能看清两个版本在内存模型、对象语义和性能表现上的区别,也能避开迁移中那些“看起来只是换函数名,实际行为已经变了”的坑。下面就按这个思路拆开看。
为什么 Python 3 不再需要 xrange
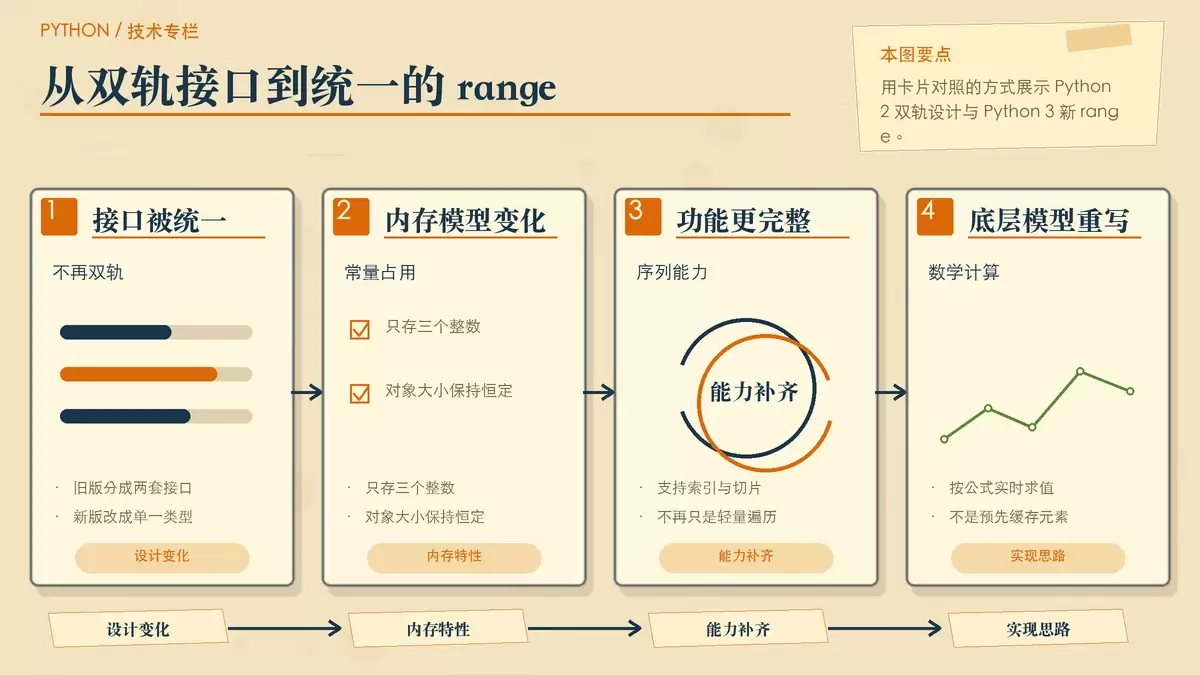
在 Python 2 中,range 和 xrange 分工很明确,但也各有明显短板:
- Python 2 的
range返回list,调用时就会立刻分配整段内存 xrange返回轻量对象,避免一次性展开全部元素,但功能比较受限
Python 3 没有保留这套双轨设计,而是重写出一个新的 range。它不是列表,也不是单纯的迭代器,而是一个不可变序列类型,只保存 start、stop、step 这三个整数。
这意味着它并不会缓存整个序列,而是把一系列值当作一个可计算的数学区间。无论是 len()、索引、切片,还是 in 判断,底层都通过公式实时计算完成。
因此,Python 3 里的 range 不只是“继承了 xrange 的省内存特性”,而是把它提升成了功能完整的序列对象。原文提到的例子很能说明这一点:像 range(10**15) 这样的大范围对象,本身依然只占约 48 字节左右的恒定内存。
换句话说,Python 3 并不是把 xrange 直接改名,而是移除了 Python 2 的 range,吸收并增强了 xrange 的思路,再把这个全新实现命名为新的标准 range。
迁移时最容易忽略的,不是名字变化,而是语义变化
从旧代码迁移到 Python 3 时,最容易出问题的地方,往往不是循环能不能跑,而是程序是否还把 range 当成了原来的那类对象。
1. 新 range 真的支持索引
在 Python 2 中,xrange 更接近“按需产生值”的轻量对象,不具备完整的序列行为。比如下面这个判断,在 Python 2 中会得到 False:
if hasattr(xrange(5), '__getitem__')但换成 Python 3 的 range(5) 后,结果会变成 True,因为它本身就支持索引访问。这不是边缘差异,而是对象模型已经换了。
2. 它不是生成器,也不是普通迭代器
很多旧代码或扩展逻辑,会把 xrange 误归类为“某种生成器式对象”。这在 Python 3 里不成立。比如:
isinstance(x, types.GeneratorType)这个判断如果原本是针对 xrange 写的,那么迁移到 Python 3 后会失效。原因很简单:新的 range 既不是生成器,也不是迭代器,而是序列。
这会影响的不只是类型判断,还包括一些围绕对象接口写出的兼容逻辑。
3. 老的类型硬编码检查需要改写
如果代码里,尤其是老 C 扩展中,存在类似这样的硬编码检查:
type(x) is xrange那在 Python 3 中就必须改成面向新类型模型的写法:
isinstance(x, range)但这里还有一层兼容问题不能忽略:在 Python 2 里,range 是 list,所以如果代码需要同时兼容两个版本,判断方式也要按运行时版本重新设计,不能机械替换名称。
为什么 in 和切片差异,最能暴露底层模型变化
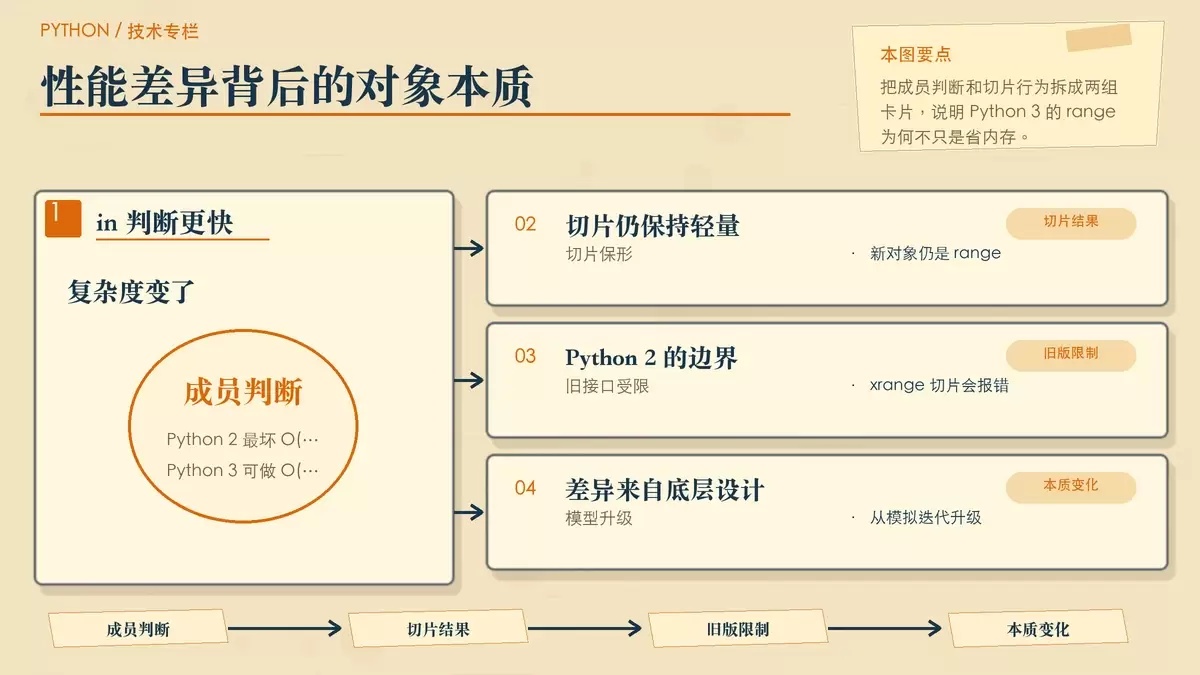
如果说“省内存”还容易被理解成实现细节,那么成员判断和切片行为,几乎就是两代设计思路差异的直接证据。
in 判断:从线性扫描变成算术判断
在 Python 2 中:
999 in xrange(1000)本质上要逐步扫描,最坏时间复杂度是 O(n)。
而在 Python 3 中:
999 in range(1000)则可以直接通过算术关系判断成员是否落在这个序列定义中,因此是 O(1)。这说明新 range 并不是在“模拟遍历”,而是在操作一个数学定义出来的序列。
切片:返回新的 range,而不是报错
同样的差异也体现在切片上。
Python 3 中这段代码:
range(0, 100, 2)[5:15:2]不会展开成列表,而是直接推导出新的参数组合,得到:
range(10, 30, 4)返回值依然是一个恒定内存的 range 对象。
对比之下,Python 2 的:
xrange(10)[2:5]会直接抛出 TypeError。这正说明两者不是“一个能省内存,一个不能”这么简单,而是底层模型已经从“迭代近似物”变成了“可计算序列抽象”。
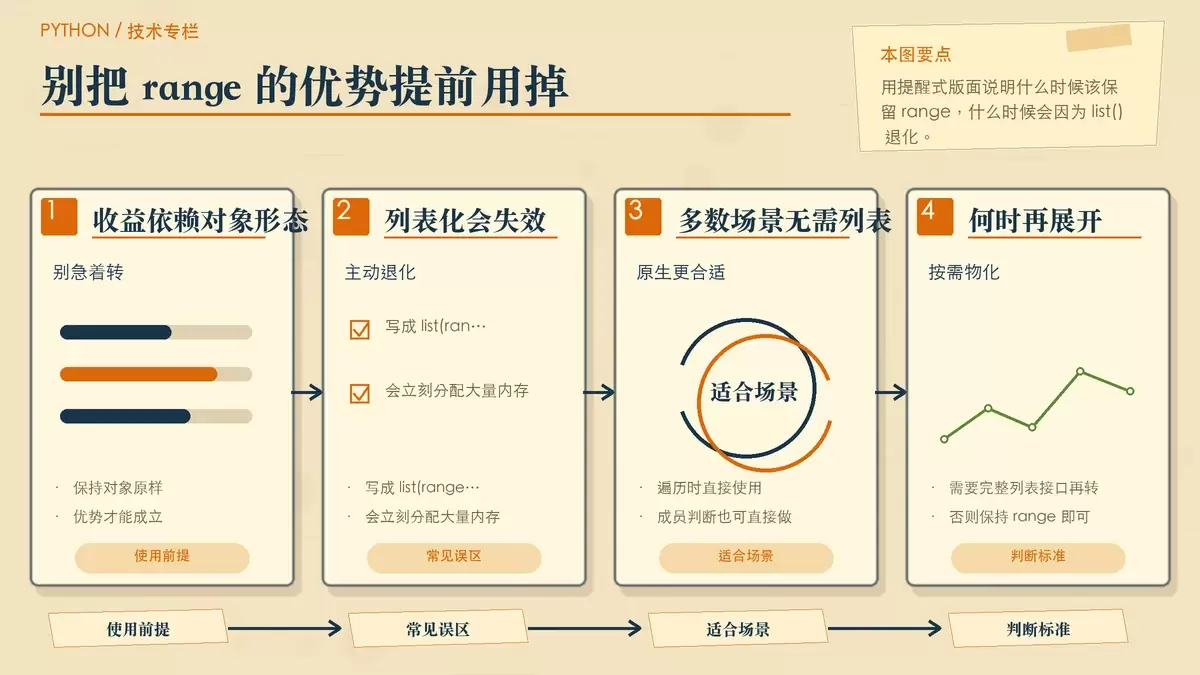
真正决定收益的前提:别过早把 range 变成列表
还有一个很常见、也最容易被忽略的误区:很多人知道 Python 3 的 range 更先进,却又在使用时第一时间把它转成列表。
一旦你写出这样的代码:
list(range(10**8))那么前面提到的恒定内存、按公式计算、快速成员判断等优势,基本就都被你主动放弃了。程序会立刻退化成接近 Python 2 的 range() 行为:一次性分配大量内存,把所有值真实存下来。
所以,内存爆炸并不是 range 的问题,而是代码提前把一个数学序列对象强行物化成了列表。只有在确实需要完整列表接口时,才应该这样做;如果只是遍历、判断成员或继续切片,尽量保持 range 对象本身,才算真正用上 Python 3 这次设计升级的价值。
结论:Python 3 的 range 是重写,不是换壳
回到最初那个问题,为什么 Python 2 的 xrange 在 Python 3 中被“整合”进了 range?更准确的说法应该是:Python 3 不再需要两个相互割裂的接口,于是用一个新设计的 range 同时解决了省内存和功能完整性的问题。
它继承了 xrange 的核心优势,但又比 Python 2 的 xrange 更完整、更可靠:支持索引、支持切片、支持高效 in 判断,并带有溢出防护,不会在大整数场景下静默截断。
因此,遇到旧文档里“Python 3 的 range 就是 xrange”这类说法时,最好把它当作入门级简化表述,而不是严格的技术结论。真正影响代码行为的,是它已经从一个偏迭代式工具,变成了一个基于数学定义的不可变序列类型。









