

Python Pandas 处理时间数据:转换、计算与提取
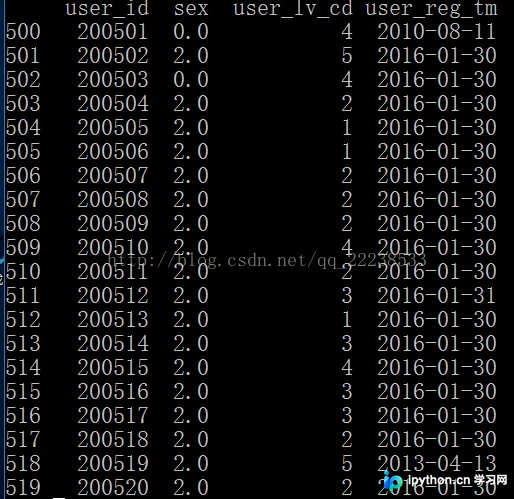
本文介绍如何使用 Python Pandas 处理数据集中的时间信息。通过 pd.to_datetime 将字符串转换为标准日期格式,利用 datetime 对象计算时间差,并提取具体的天数信息。文章涵盖日期格式解析、时间差计算及属性访问方法,帮助开发者高效处理时间序列数据。
2026-10-11
6

本文介绍如何使用 Python Pandas 处理数据集中的时间信息。通过 pd.to_datetime 将字符串转换为标准日期格式,利用 datetime 对象计算时间差,并提取具体的天数信息。文章涵盖日期格式解析、时间差计算及属性访问方法,帮助开发者高效处理时间序列数据。
本文详细介绍 Python numpy 库中 polyfit 函数的作用与应用场景。该函数主要用于基于最小二乘法的多项式曲线拟合,核心参数包括自变量序列、因变量序列及拟合阶数。通过实际代码演示如何求解一次函数 y=kx+b 的参数,并解释返回值结构与计算机浮点数精度特性,协助开发者快速掌握坐标点拟合与系数提取方法。
本文介绍在Visual Studio 2017环境中,通过IronPython引擎实现C#调用Python脚本的方法。重点解决第三方库(如requests)的依赖问题,通过配置sys.path指向Python标准库目录,确保IronPython能正确解析非内置模块,从而在C#项目中成功执行包含网络请求的Python代码。
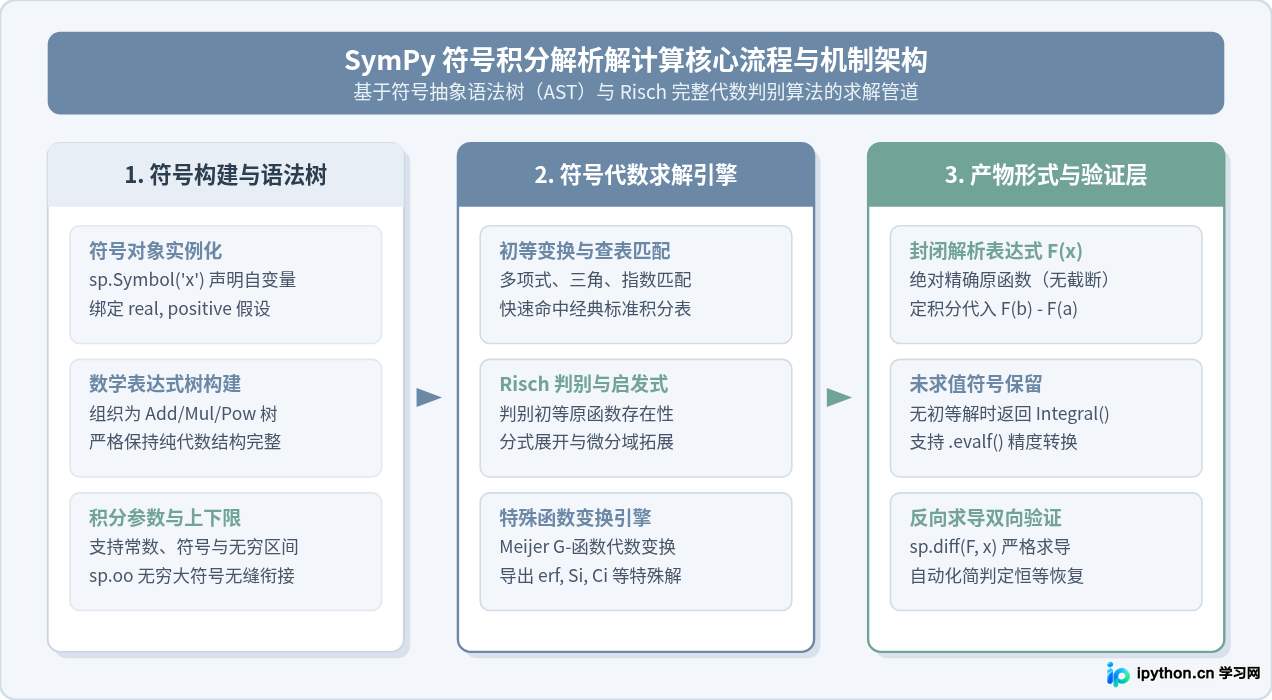
系统介绍如何使用Python符号计算库SymPy求解微积分中的积分解析解,涵盖符号变量声明、不定积分与定积分的核心函数integrate用法、双重与广义积分实战、与SciPy数值计算的对比以及常见问题排查与反向求导验证。
通过构建独立的虚拟环境并结合PyInstaller编译工具,可将Python脚本打包为脱离解释器运行的独立程序。该方法能有效隔离系统级依赖、消除版本冲突,大幅缩减交付体积并提供跨平台兼容性。以下为完整的标准化操作指引。
本文详细说明如何通过Python脚本读取包含图片URL的TXT文本,并提供三种实现路径:轻量级URL扩展、基于Pillow的基础几何与像素变换,以及调用imgaug的高级批量增强流程。内含完整可运行代码、依赖配置步骤、输出目录校验方法及版权合规提示,适用于计算机视觉模型训练前的样本扩充任务。
本文详解如何利用 Python 第三方库 python-docx 实现 Microsoft Word 文档的自动化读写、样式修改、页面排版、批量合并拆分及表格图像处理。提供完整可运行的代码示例与防错指南,助力开发者快速搭建办公提效脚本。
Python 中的 re 模块提供了完整的正则表达式工具链,涵盖模式匹配、文本提取、条件替换及多行处理等核心场景。本文梳理从基础导入到高级断言、分组及编译优化的完整工作流,配合可运行的代码示例,帮助开发者高效解决复杂的字符串解析与数据清洗任务,提升代码健壮性与执行效率。
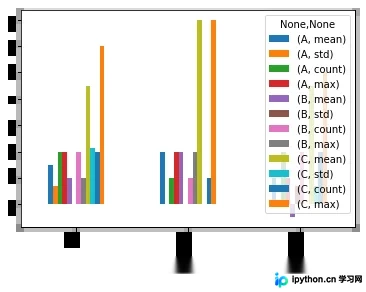
本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
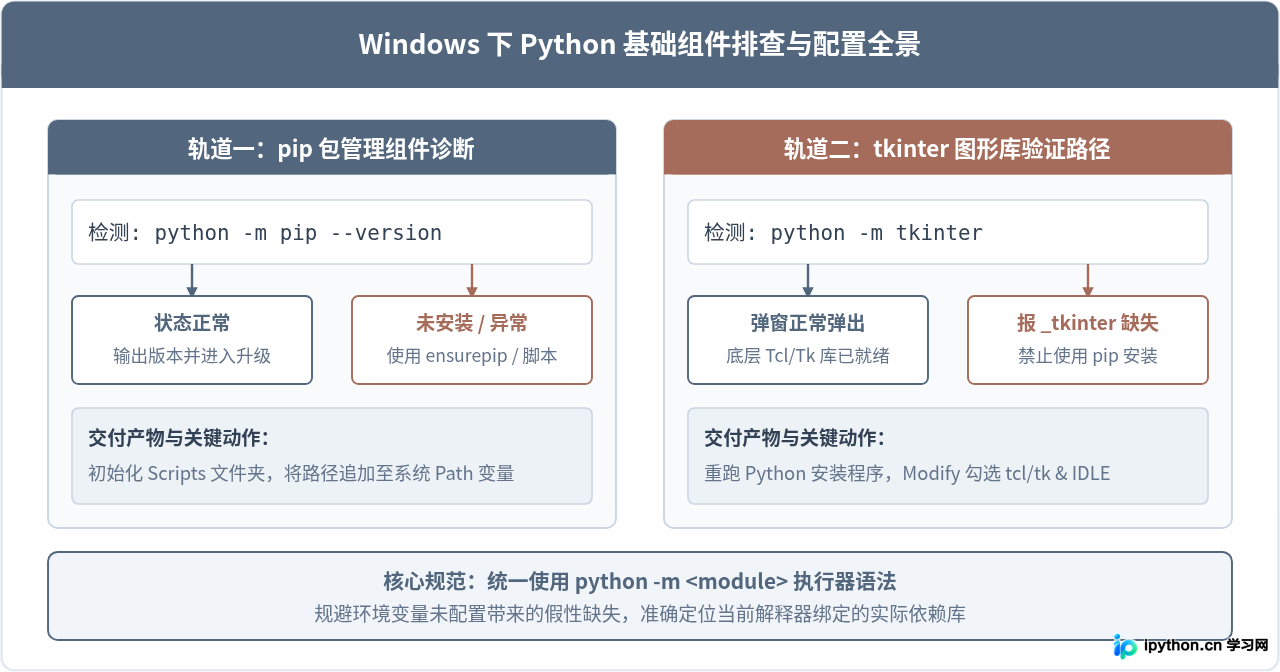
详细介绍在Windows操作系统下安装与修复Python包管理器pip、排查环境变量Path,以及正确验证与补全图形库tkinter可用性的具体操作步骤与排错方法。
本文总结了在 Python 中使用 pexpect 模块进行交互自动化时的三种日志记录方式。通过设置 child.logfile 属性、重定向 sys.stdout 对象以及直接打印输出到文件,可以实现对子进程交互过程的完整记录。文章提供了具体的代码示例,详细解析了文件打开模式(二进制与文本)的选择依据及注意事项,帮助开发者根据实际需求选择最合适的日志记录方案。
本文详解 NumPy 中用于数组合并的 np.vstack() 与 np.hstack() 方法。两者分别实现竖直堆叠与水平拼接,核心差异在于目标轴与维度匹配规则。文章提供完整代码示例,梳理常见报错原因与参数传递技巧,帮助开发者准确重组数据矩阵。