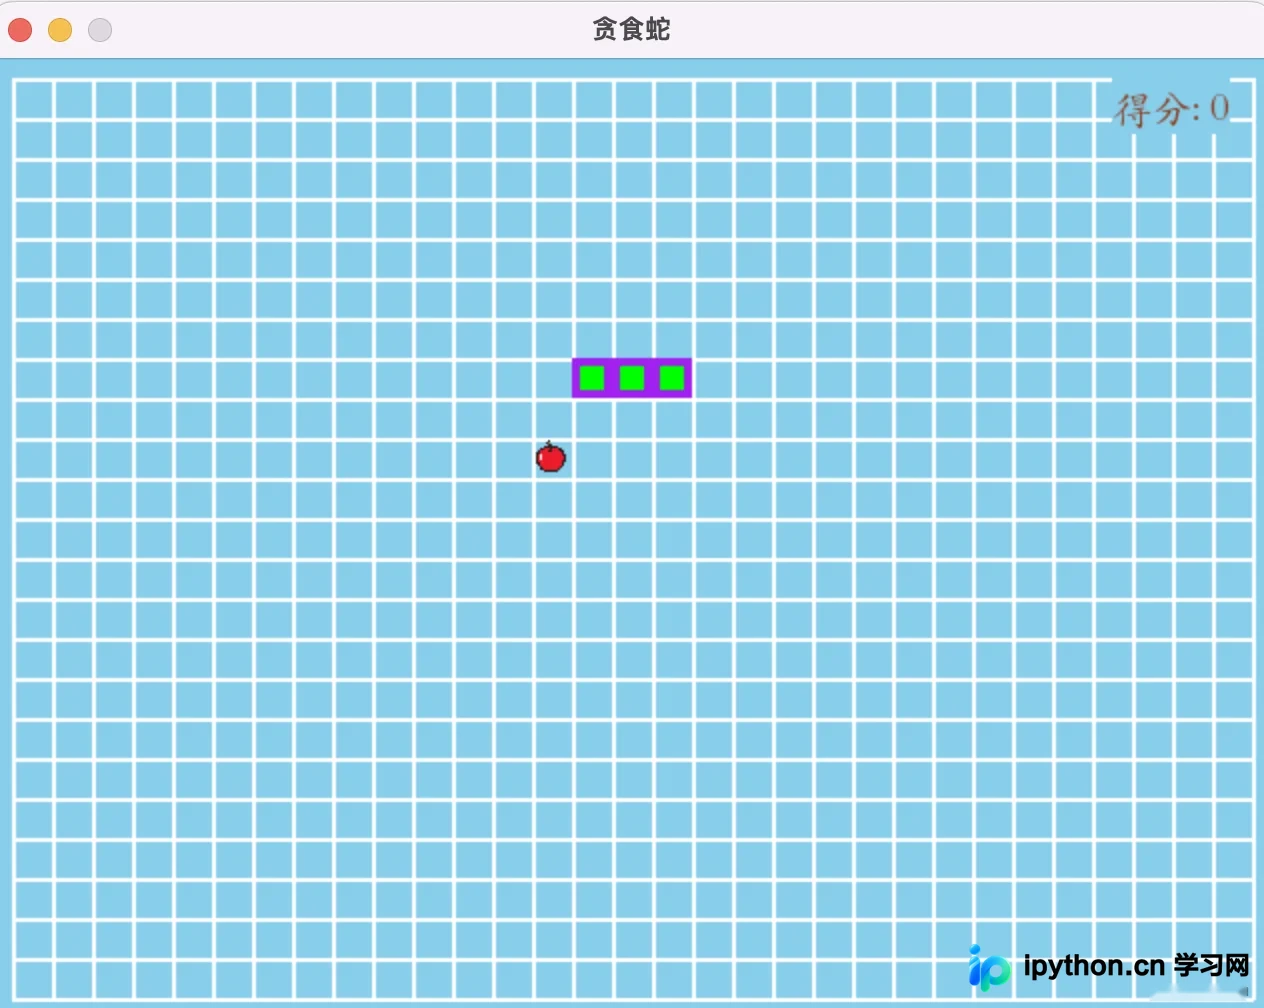
Python贪吃蛇核心功能实现:苹果生成、碰撞判定与得分系统
本文详细讲解基于PyGame的贪吃蛇游戏核心交互功能的实现方法。通过模块化代码展示如何随机生成避开蛇身的苹果、处理头部碰撞与身体增长逻辑,并补充了撞墙以外的自撞判定、RGB闪烁结束动画及自定义中文字体的实时计分渲染,帮助开发者快速完善基础游戏循环。
2026-10-12
6

本文详细讲解基于PyGame的贪吃蛇游戏核心交互功能的实现方法。通过模块化代码展示如何随机生成避开蛇身的苹果、处理头部碰撞与身体增长逻辑,并补充了撞墙以外的自撞判定、RGB闪烁结束动画及自定义中文字体的实时计分渲染,帮助开发者快速完善基础游戏循环。
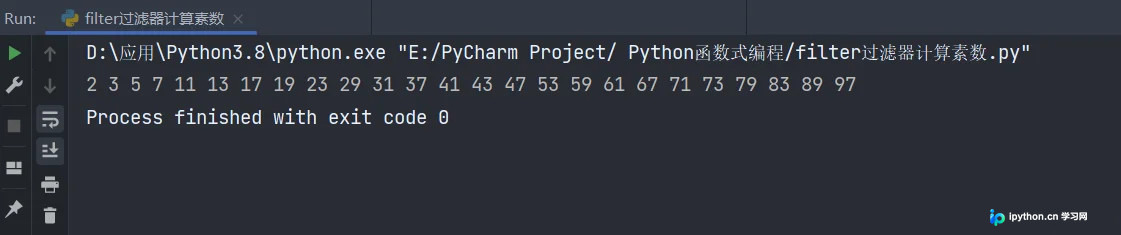
本文详解Python高阶函数中返回函数的核心机制,通过动态求和示例展示闭包工作原理,并结合无限生成器与filter函数实现埃氏筛法,自动生成并验证小于100的全部素数。该方法能显著简化传统嵌套循环,提升代码运行效率与逻辑清晰度。
fileinput 模块专为迭代处理一个或多个文本文件设计,采用逐行生成的惰性读取方式,在批量处理大文件时可显著降低内存占用。相比传统的 open() 结合循环,它原生支持原地修改、自动备份、跨文件序号追踪及自定义读取钩子。通过合理配置参数与方法,可快速实现日志清洗、代码批量检索与格式标准化等任务。
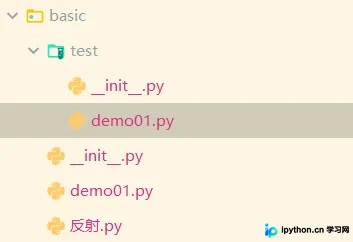
本文详解如何在Python中利用反射机制,通过字符串动态导入模块、获取属性与方法,以及修改对象状态。结合动态导入参数配置、内置反射函数与完整的路由分发代码,帮助开发者掌握运行时灵活调度对象的实战技巧。
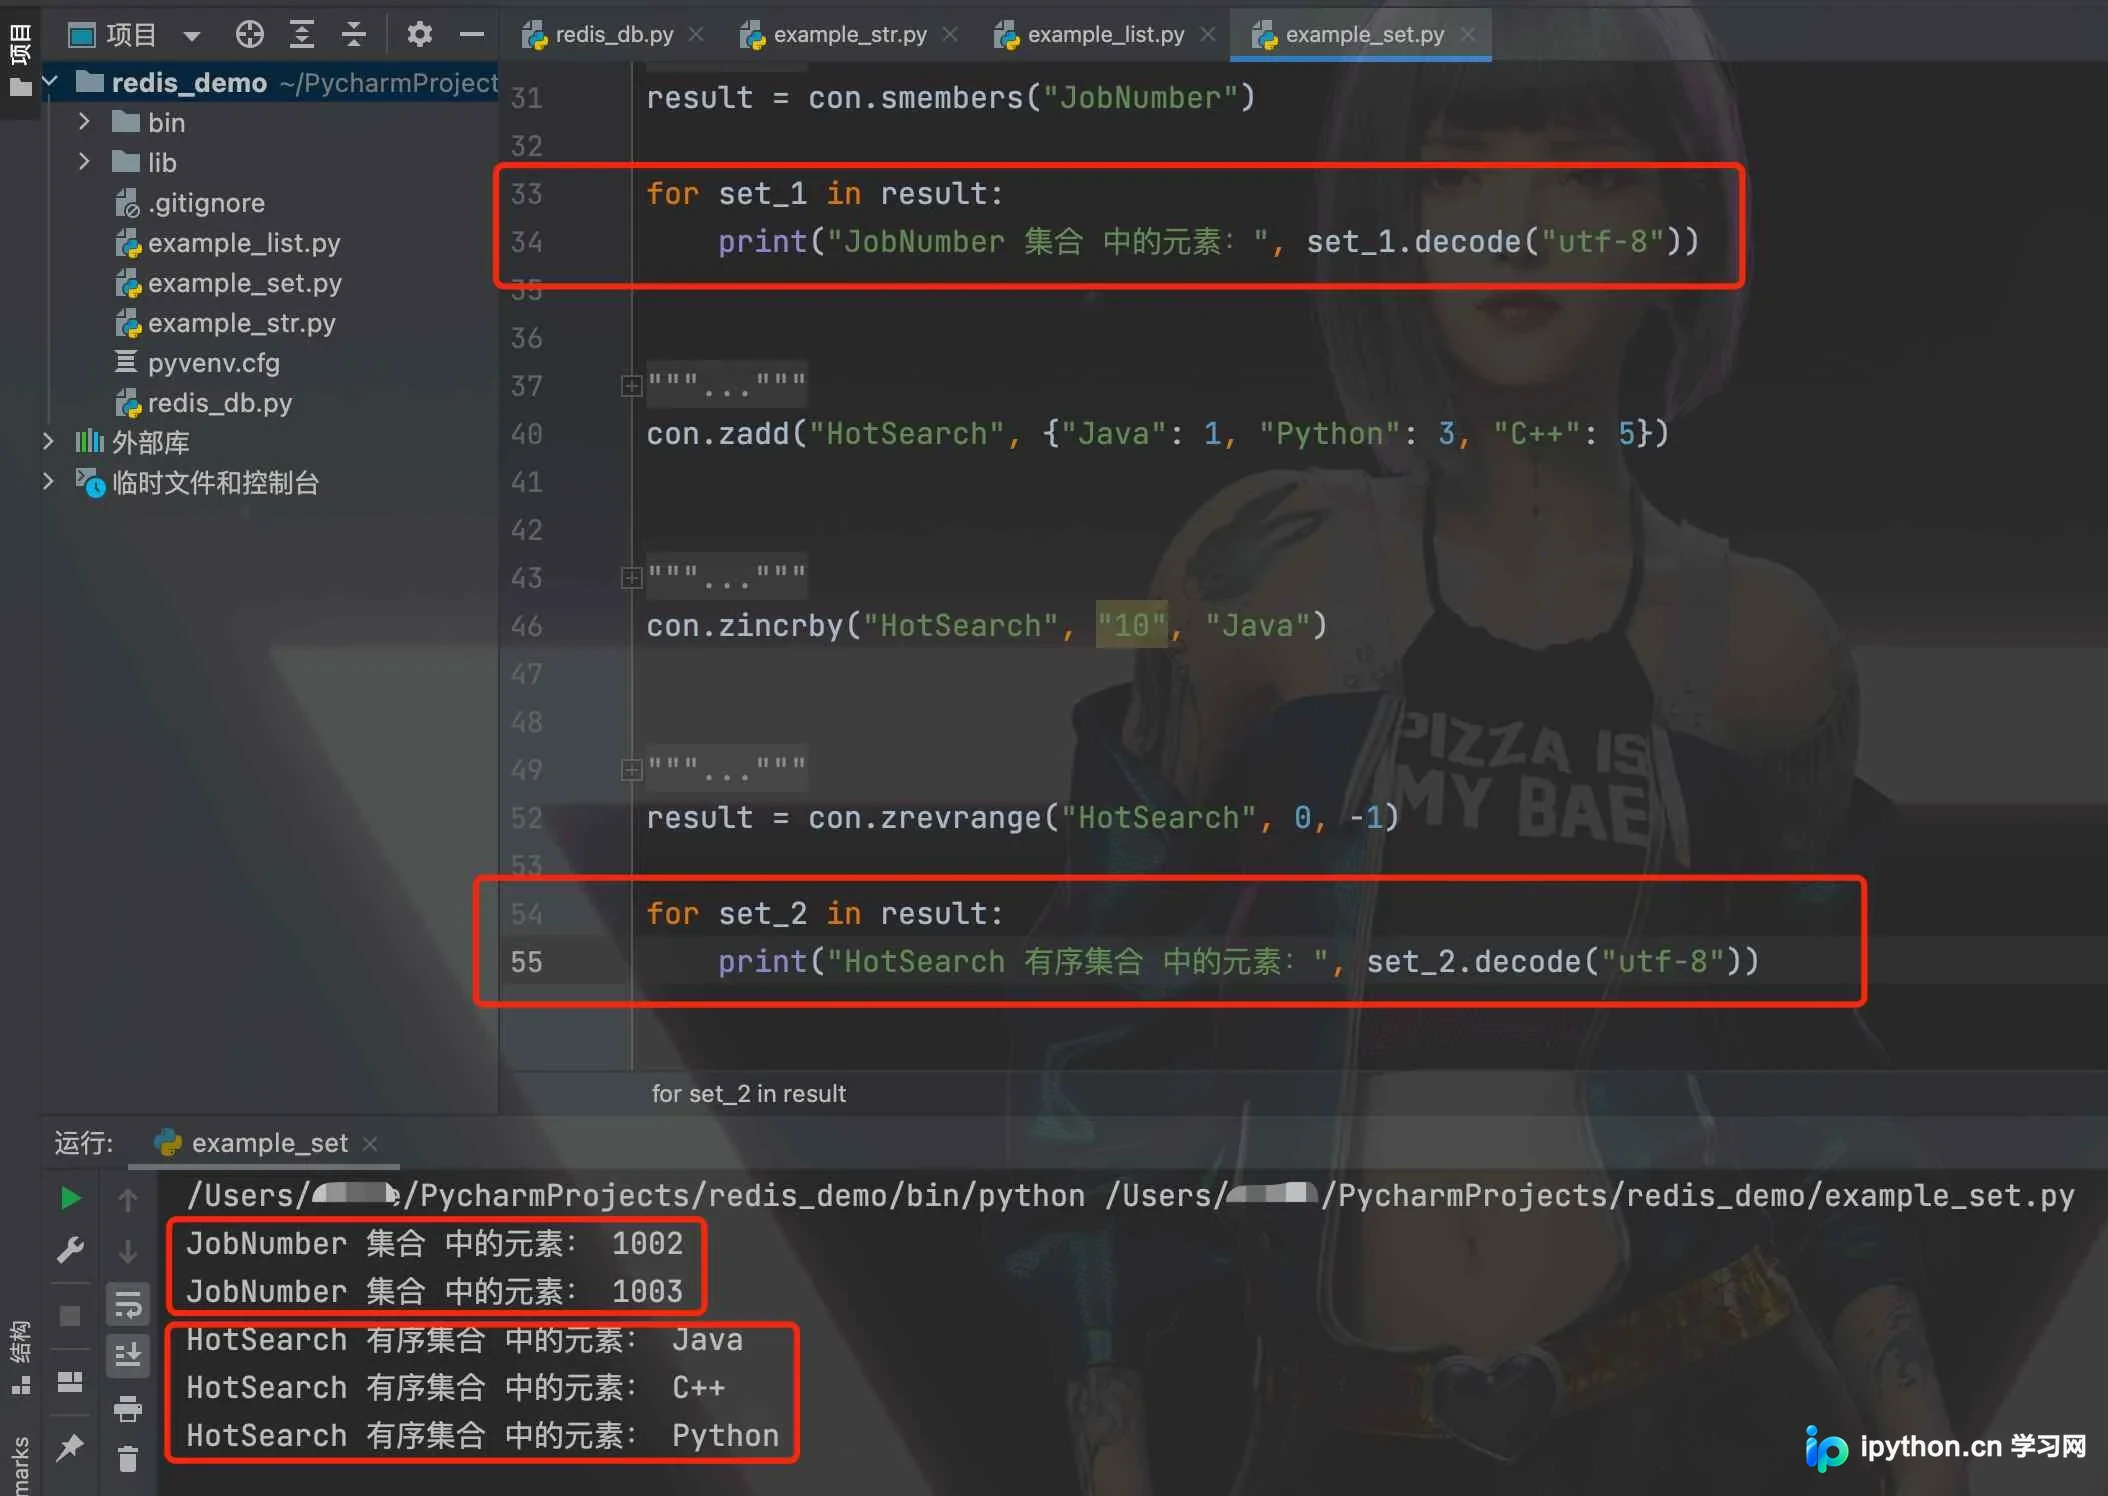
基于 redis-py 客户端对 Redis 集合(Set)与有序集合(ZSet)进行创建、增删、排序与读取的实操指南。通过 sadd、srem、smembers 及 zadd、zincrby、zrevrange 等核心指令,结合完整 Python 示例代码,快速掌握内存数据结构的高效操作方法。
本文系统梳理Python中字符串处理的核心方法,涵盖定义规则、索引与切片截取、大小写转换与字符填充、精确查找与统计、空格清理与内容分割、格式对齐与模板替换,以及类型校验和遍历逻辑。通过标准代码示例与常见应用场景说明,帮助开发者快速掌握Python文本处理的最佳实践。
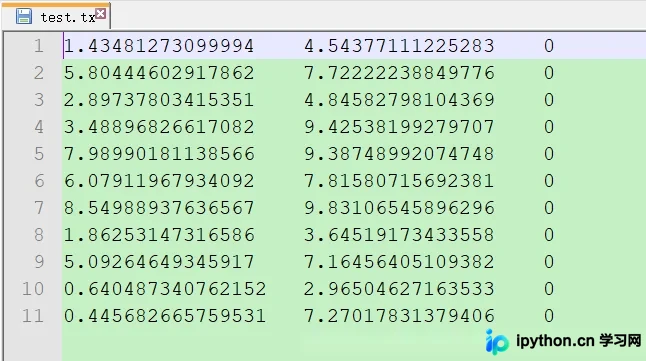
本文介绍在Python中加载数据文件的两种实用方法,分别使用内置open()函数和pandas库的read_csv()功能。通过实例演示如何读取特征和标签数据,比较结果一致性,适用于机器学习等数据密集型任务的预处理环节。
本文详细讲解如何使用 Python 第三方库 psutil 进行系统级资源监控与进程管理。内容覆盖从环境配置、CPU 与内存数据采集、进程列表遍历到安全终止任务的具体操作流程,附带可直接运行的代码片段与关键参数说明,适合需要编写自动化运维脚本或性能分析工具的开发者参考。
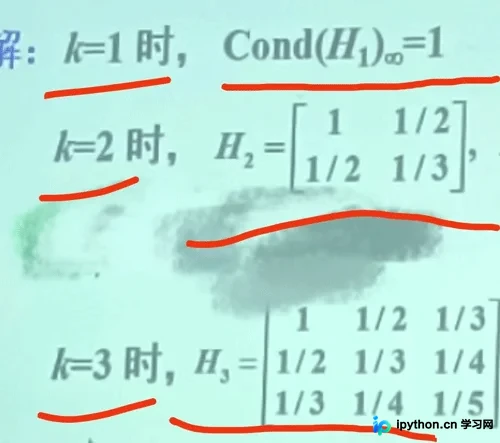
本文详细讲解利用Python与NumPy库生成Hilbert矩阵的核心逻辑。通过解析行列下标与元素值的对应规律,提供基础构造代码,并演示如何扩展生成包含行求和结果的增广矩阵。附完整源码、运行结果及关键参数说明,帮助开发者快速掌握矩阵计算技巧。
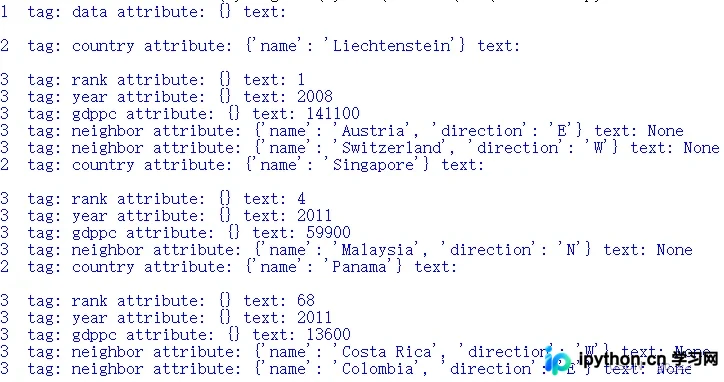
详细介绍Python中使用内置标准库读取和编写XML配置文件的核心方法。通过xml.etree.ElementTree与xml.dom.minidom两大模块的代码示例,涵盖文件解析、节点遍历、属性读取、动态构建树结构及数据持久化的完整操作流程,并对比两者的性能特点与适用场景。
本文系统梳理 Python 中列表的核心操作方法。从引用传递机制与遍历技巧入手,详细演示 append、extend、insert 添加元素,以及 del、pop、remove 删除元素的差异。深入解析分片赋值的覆盖与插入用法,并对比 reverse、sort 与 sorted 的排序逻辑。提供可直接运行的代码示例,帮助开发者快速掌握数据结构实操。
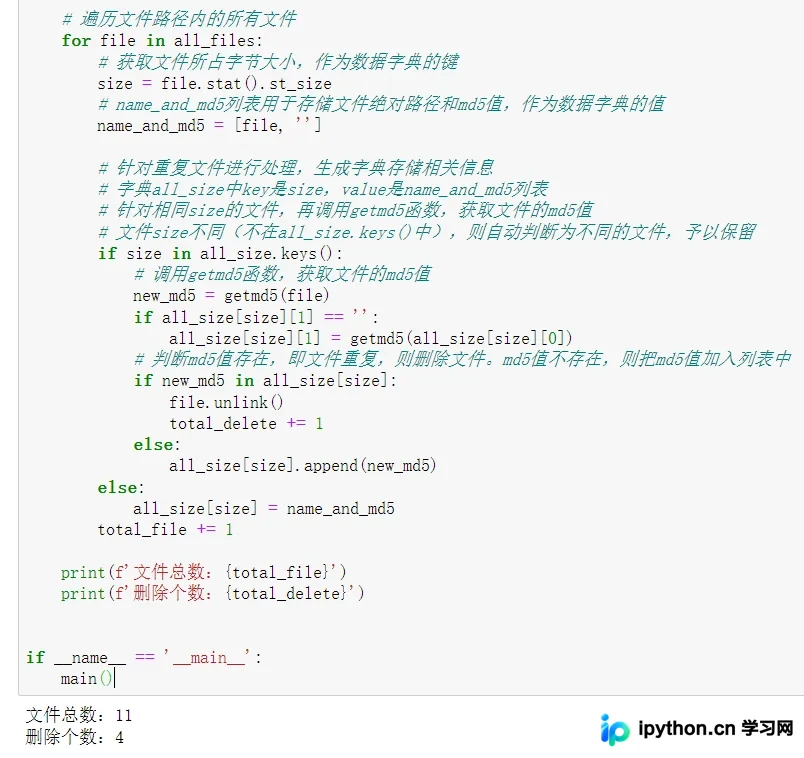
通过Python标准库遍历目录,采用文件大小初筛配合MD5精准比对的双层逻辑快速定位冗余数据。本文提供含安全提示的去重脚本、执行流程解析及常用路径操作对照指南,协助开发者高效完成批量文件清理。