Python列表推导式高效筛选长度大于5的名字
本文详细讲解如何利用Python列表推导式,一键从多层嵌套的数据结构中筛选出长度大于5的名字。通过拆解遍历顺序、对比常规循环写法,并提供可直接运行的测试代码与结果验证方法,帮助用户快速掌握高效的数据清洗技巧。
2026-10-12
7

本文详细讲解如何利用Python列表推导式,一键从多层嵌套的数据结构中筛选出长度大于5的名字。通过拆解遍历顺序、对比常规循环写法,并提供可直接运行的测试代码与结果验证方法,帮助用户快速掌握高效的数据清洗技巧。
本文系统整理Python中常用数据类型的转换方法,涵盖int、float、str、list、tuple及bool之间的转换规则。通过标准内置函数与字符串方法,结合实操代码示例,提供清晰的输入输出结果与异常处理建议,帮助开发者快速完成数据格式清洗与类型校验。
本文系统梳理Python中字符串的定义规范及高频处理方法,涵盖大小写转换、长度与零填充、子串定位统计、前后缀校验、字符过滤替换、类型诊断以及进阶切片规则。搭配可直接运行的代码示例,帮助开发者快速掌握文本处理的核心技巧。
本文详细解析Python列表中元素增加与删除的核心方法。通过对比append、extend、insert三种添加方式,以及pop、remove、del、clear四种删除操作的语法结构、返回值差异与典型应用场景,配合完整代码示例,帮助开发者快速掌握序列数据处理技巧,有效规避索引越界与类型混淆问题。
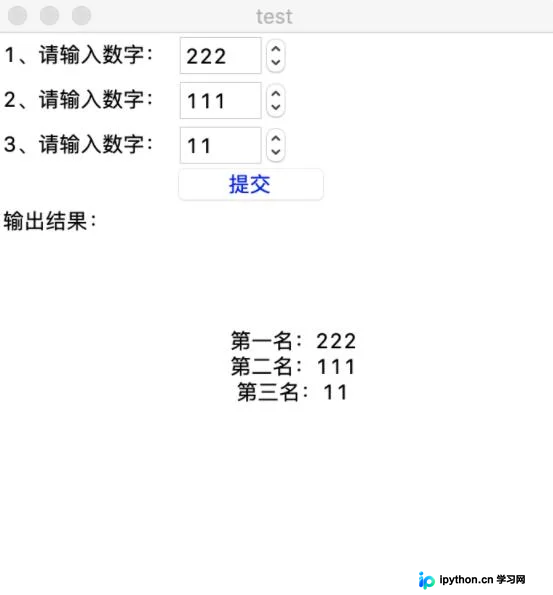
本文介绍了使用Python标准库tkinter搭建轻量级图形界面的方法。通过结合Spinbox输入框、Button按钮与Text文本框,实现了多组数据的捕获、排序与动态刷新输出,附带完整源码及常见报错排查指南。
详细介绍Python h5py库的核心操作,涵盖HDF5文件的读写模式配置、一维及多维数据集的创建与NumPy数据对接,以及组的嵌套管理与路径映射机制。提供完整代码示例与运行结果对照,适用于数据存储与科学计算场景的快速上手。
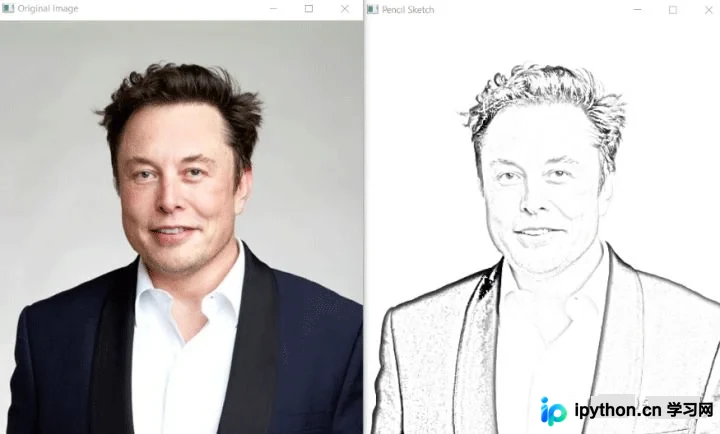
Python凭借简洁语法与丰富生态,成为编写自动化脚本的首选语言。本文整理5个实用自动化场景代码,涵盖网页新闻抓取朗读、图像素描生成、Excel联系人批量邮件发送、Dtale一键数据探索及Windows桌面定时弹窗提醒。提供完整依赖配置、核心代码块与运行环境说明,帮助开发者快速集成到日常工作流中提升效率。
本文系统梳理Python常用快捷语法与底层技巧,涵盖条件判断、集合翻转、进制转换、多维列表初始化、字符串处理、循环控制及内置函数调用。通过规范代码示例与参数说明,帮助开发者简化冗余逻辑,提升日常编写与调试效率。
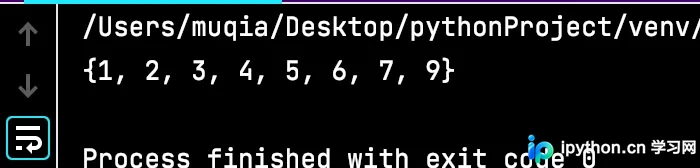
本文详解 Python 中集合(set)的定义特性与核心操作方法。通过实际代码演示初始化构建、add/update 添加、remove/discard/pop 删除及 clear 清空等步骤,并完整展示交集、并集、差集与子集判断等数学运算用法,帮助开发者高效实现数据去重与逻辑运算。
在Python数据分析中,pandas库提供了apply()、map()和applymap()三个核心函数,分别用于DataFrame的行列级操作、Series的逐元素处理以及DataFrame的逐元素清洗。本文通过实际代码示例与运行结果对比,明确三者的作用范围、参数配置及典型应用场景,帮助开发者快速掌握批量数据处理技巧。
本文详解如何利用Pipenv创建纯净虚拟环境配合Pyinstaller打包Python项目。通过隔离无用依赖库,可显著降低生成的exe文件体积。涵盖环境准备、虚拟环境管理、依赖安装、打包参数配置及常用命令,帮助开发者快速输出轻量级可执行文件。
本文详细解析Python的五个标准数据类型:数字、字符串、列表、元组和字典。涵盖各类数据的创建方式、核心特性(可变性与不可变性)、常用操作及代码示例,帮助开发者快速掌握Python基础数据结构的使用方法与实际应用场景。