

Python NumPy结构体数组定义、内存对齐与C语言交互详解
本文详解Python中利用NumPy创建结构体数组的方法,涵盖通过字典定义字段类型、字节序控制及内存对齐设置。重点解析如何与C语言结构体二进制数据无缝交互,包括读写、字段访问及视图操作,并提供Python类模拟结构体的替代方案,适用于高性能数据处理场景。
2026-10-15
8

本文详解Python中利用NumPy创建结构体数组的方法,涵盖通过字典定义字段类型、字节序控制及内存对齐设置。重点解析如何与C语言结构体二进制数据无缝交互,包括读写、字段访问及视图操作,并提供Python类模拟结构体的替代方案,适用于高性能数据处理场景。
本文介绍如何使用Python PIL库实现按比例裁剪图片。通过计算目标宽高比,自动确定裁剪区域并保存结果。同时提供Image.resize方法实现图片等比例缩放,保持画面不变形。
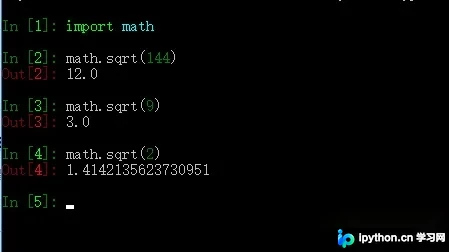
本文详细介绍在Python中实现数字开平方的三种常用方法:通过math模块调用sqrt函数、使用内置pow函数进行幂运算,以及直接利用数学表达式求解。文章分别演示了各方法的代码示例与注意事项,帮助开发者快速掌握Python中的根号计算技巧。
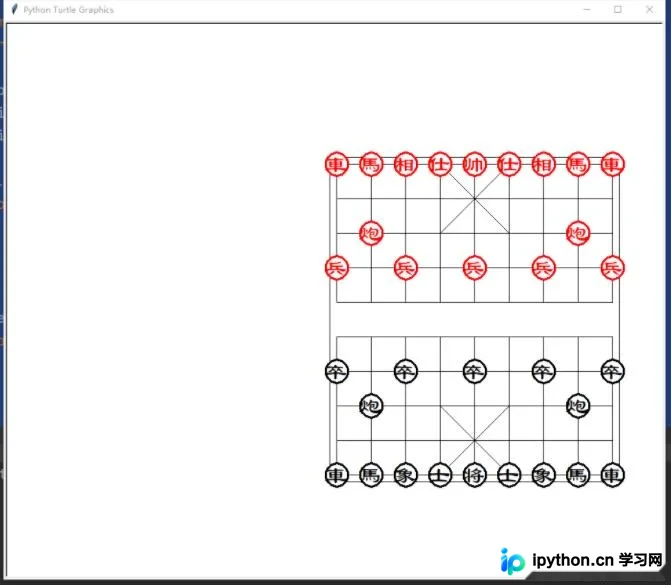
本文介绍了使用Python标准库Turtle实现中国象棋游戏的方法。通过定义棋盘尺寸与画笔速度,利用循环语句绘制纵横网格、九宫格斜线及河界楚河汉字区域。代码详细展示了红黑双方棋子的坐标定位与名称渲染逻辑,包括车马炮卒士象将的初始布局,为Python游戏开发提供完整参考。
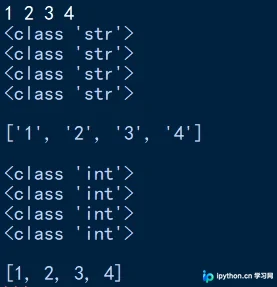
本文介绍在Python中如何在一行输入多个数字并存入列表。主要包含两种方法:一是使用split()分割字符串后通过索引遍历转换为int或float类型;二是结合map()与split()函数直接生成整型列表。文章提供了相关代码示例及注意事项,适用于Python3环境。
本文详细介绍Python字典的常用操作,涵盖初始化、合并、推导式及collections标准库的使用。重点讲解defaultdict和Counter的高级用法,以及字典与JSON、Pandas DataFrame/Series之间的转换方法,帮助开发者高效处理数据结构。
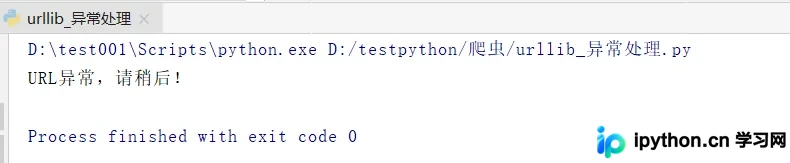
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
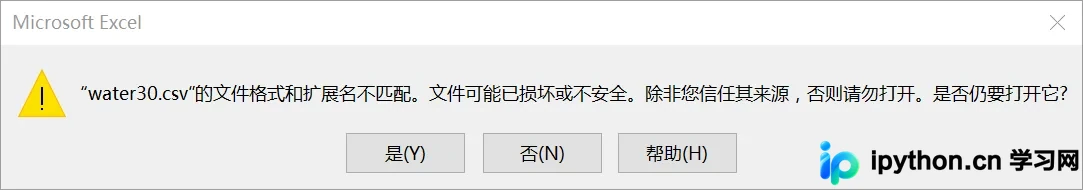
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
本文介绍Python中获取字典关键字与值的两种主要方式。通过values()方法可直接提取所有值,而items()方法则返回键值对元组。文章还对比了使用普通字典与defaultdict构建键值列表的两种代码实现,展示了从文件列表生成分类字典的实际应用案例。
本文深入解析Python中类的私有属性与公共属性。通过双下划线前缀定义私有属性,Python会在内部进行名称改写(Name Mangling)以限制访问。文章展示了直接访问私有属性及子类继承时的异常行为,并对比了单下划线与双下划线的区别,帮助开发者理解Python的封装机制。
本文详细介绍pandas中Series对象的三种创建方式,包括通过字典、一维数组和标量值构建Series,并深入解析Series的常用操作方法,如创建、追加、删除、修改及查询。文章通过具体代码示例展示了不同场景下的正确用法,特别是嵌套Series追加时的常见错误与修正方案,帮助开发者高效掌握Series的核心功能。