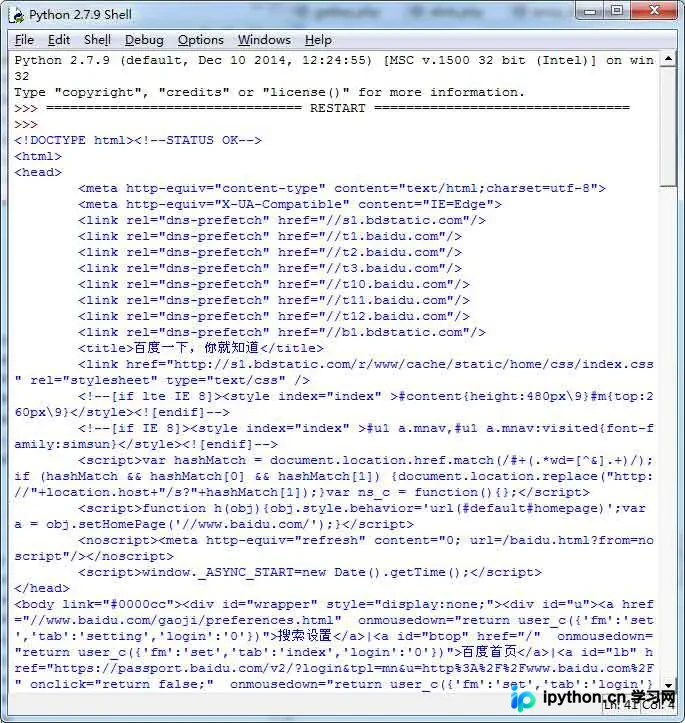
Python使用httplib下载网页源码的示例
本文提供使用Python标准库httplib模块发起GET请求并获取网页源码的完整代码示例。通过连接指定域名、发送请求、读取响应数据并打印结果,展示了基础的HTTP交互流程,适用于Python初学者理解网络请求实现。
2026-10-13
8

本文提供使用Python标准库httplib模块发起GET请求并获取网页源码的完整代码示例。通过连接指定域名、发送请求、读取响应数据并打印结果,展示了基础的HTTP交互流程,适用于Python初学者理解网络请求实现。
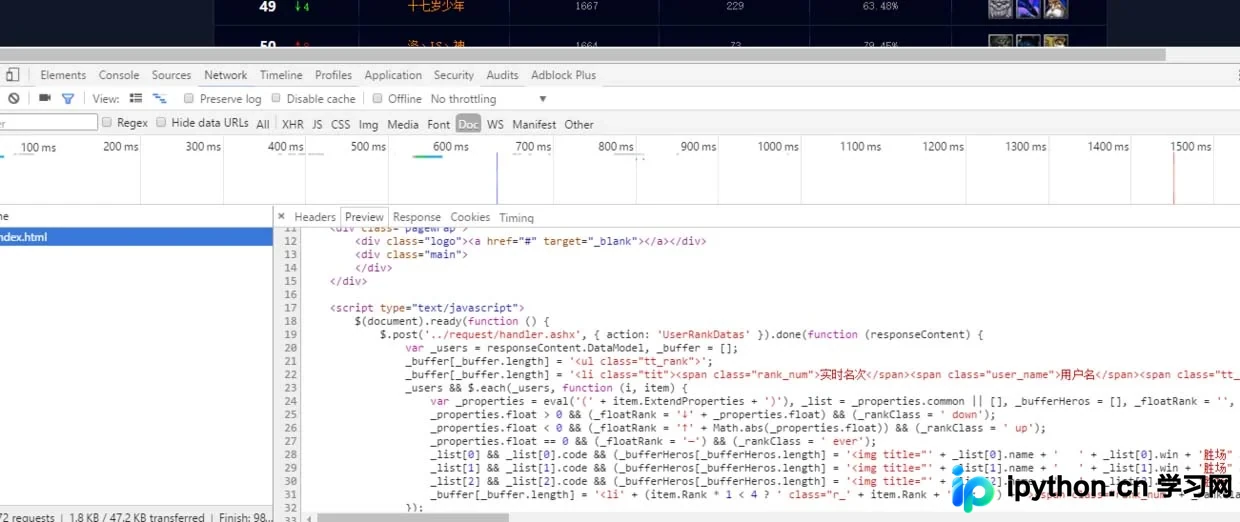
本文详细介绍如何利用Python抓取DOTA2游戏排行榜数据。通过浏览器开发者工具分析网络请求,定位异步POST接口及JSON数据结构,编写脚本模拟浏览器行为获取数据,并最终将结果保存至Excel文件中。适合希望学习网络爬虫基础及数据处理流程的开发者参考。
本文介绍在Python中快速删除列表中重复元素的方法。通过示例代码展示如何利用set函数实现去重,并指出该方法会改变元素原有顺序。同时提供在线去重工具链接及Python相关教程推荐,帮助开发者高效处理数据。
本文介绍如何使用Python实现一个单线程多任务的非阻塞TCP服务端。通过设置socket为非阻塞模式,利用异常处理机制检测客户端连接与数据接收状态,从而在单个线程中并发处理多个客户端请求,避免阻塞等待。
本文深入解析Django ORM中objects.all()、get()与filter()的核心区别。all()返回QuerySet对象,支持惰性查询与迭代;get()直接执行SQL并返回单个Model实例,适用于精确查找;filter()则提供丰富的查询条件支持。文章详细列举了__exact、__contains等常用查询后缀及distinct去重用法,帮助开发者根据场景选择高效的数据获取方式。
本文系统梳理Scrapy框架的五大核心命令行操作,涵盖从项目初始化、Spider文件生成到程序执行及交互式调试的完整流程。详细解析scrapy startproject、genspider、crawl及shell等关键指令的语法结构与使用场景,帮助开发者快速掌握Scrapy基础工作流,提升爬虫开发与调试效率。
本文详解Python中在遍历列表时直接删除元素导致的遗漏问题,通过代码示例展示错误现象。提供两种有效解决方案:一是通过复制列表并遍历原列表来删除目标列表,二是利用简洁高效的列表推导式过滤元素,帮助开发者避免常见陷阱。
本文记录使用Python对23万条自然语言分析数据进行并行数据库读写优化的过程。通过为每个进程分配独立的connection和cursor避免冲突,并采用分表策略解决多进程写入竞争问题。文章详细阐述了并行读取与写入的实现逻辑及关键代码,旨在提升大规模数据处理的执行效率。
本文详细介绍 Python 中枚举类 Enum 的定义方法、成员访问方式及比较规则。涵盖如何导入模块、使用 class 继承 Enum 类、处理重复值限制(@unique)以及通过名称或值获取成员。同时说明枚举的单例特性、不可变性及迭代支持,帮助开发者规范使用常量。
本文深入探讨Python中HTTP长连接客户端的实现,针对高并发场景下短连接导致的Time-Wait状态堆积和端口耗尽问题,提供了从单进程到多进程,再到长连接优化的完整解决方案。通过对比短连接与长连接代码,展示了如何利用Requests库的Session对象维持连接,显著提升系统稳定性和处理效率。
本文详解如何利用Python、Requests库及Unittest框架实现API接口自动化测试。通过集中管理正常与异常参数,动态生成多维度的测试用例组合,并循环执行请求以验证接口健壮性。文章提供了从参数配置到脚本执行的完整代码示例,适用于需要覆盖边界值、SQL注入及类型错误的接口测试场景。
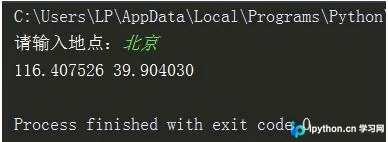
本文介绍如何使用Python调用百度地图API获取地址对应的经纬度信息。通过构造GET请求,传入地址和Key参数,解析返回的JSON数据即可提取坐标。文中提供了完整的代码示例及运行结果分析,适用于需要地理位置信息的爬虫或数据处理场景。