

Python获取SQLite查询结果表列名的方法
本文介绍在Python中获取SQLite查询结果表列名的两种方法。通过cur.description属性可直接从查询结果中提取列名列表;使用PRAGMA table_info(table)语句可获取表的详细结构信息。适用于需要动态处理数据库字段名的场景,帮助开发者更高效地进行数据交互与处理。
2026-10-13
8

本文介绍在Python中获取SQLite查询结果表列名的两种方法。通过cur.description属性可直接从查询结果中提取列名列表;使用PRAGMA table_info(table)语句可获取表的详细结构信息。适用于需要动态处理数据库字段名的场景,帮助开发者更高效地进行数据交互与处理。
本文介绍Python内置函数reversed(),用于反转序列对象。通过列表和range对象的示例,展示其返回迭代器的特性及输出结果,帮助开发者理解序列反转的实现方式。
本文通过Python解析XML时的ElementTree与SAX对比,引出回调函数的概念。文章利用家政服务API的通俗比喻解释回调机制,并提供了Python代码示例展示如何通过函数指针调用回调函数,帮助开发者理解事件响应编程模式。
本文深入解析 Python sqlite3 模块的事务处理机制,重点对比了不指定 isolation_level 时的智能提交模式与指定 isolation_level=None 的自动提交模式。通过实际代码示例和 10 万次数据插入的性能测试,展示了手动管理事务对提升批量操作效率的关键作用,并提供了避免常见错误的最佳实践。
本文介绍在Python中将Unicode字符串(如u'\u810f\u4e71')转换为普通字符串的方法。核心技巧是利用encode('unicode-escape')配合decode('string_escape')实现编码转换,适用于需要处理原始Unicode转义序列的场景。
本文介绍使用Python实现两个文件夹内容的对比功能,涵盖子目录遍历、差异文件列出及相同文件大小与内容比对。通过示例代码展示如何识别A比B多出的文件、B比A多出的文件,以及大小相同或不同的相同文件。
本文详解Python中实现自定义回调函数的两种优雅方式。首先通过kwargs接收回调标识,利用getattr进行反射调用;其次进一步抽象为装饰器模式,封装URL请求与回调逻辑,提升代码复用性与可维护性。
本文通过Python MySQLdb库演示完整的数据库事务操作流程。代码实现了账户合法性检查、余额充足性验证及转账逻辑,重点展示如何在发生异常时执行回滚以确保数据一致性。该示例适用于学习Python数据库编程及事务管理机制,包含完整的异常捕获与资源释放逻辑。
本文通过Python示例展示如何使用threading模块实现多并发访问网站的功能。代码包含对每次请求开始与结束时间的记录,计算单次耗时、总耗时、最大及最小响应时间,并统计超过1秒的请求次数。通过多线程并行执行,可评估网站在高并发场景下的性能表现及稳定性。
本文介绍如何使用Python 3.4结合pymysql库,通过循环方式向MySQL 5.7数据库插入多条数据,并在插入完成后查询输出结果。文章提供了完整的连接配置、事务提交及异常处理代码示例,适用于需要批量处理数据库记录的Python开发者参考。
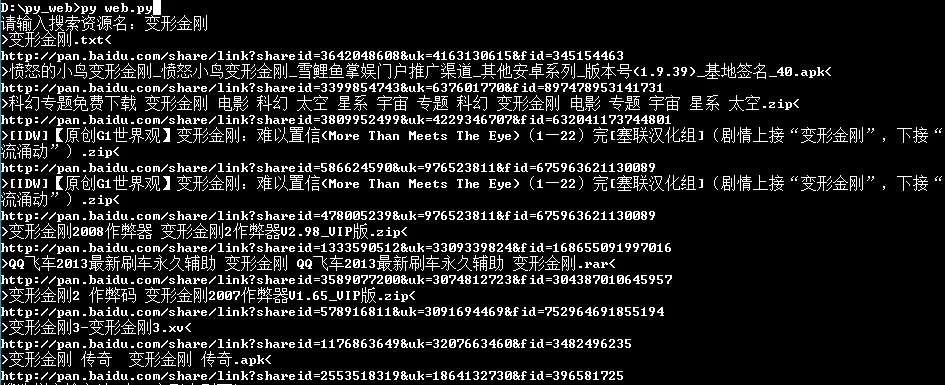
本文分享了一段使用Python编写的爬取盘多多网站百度云资源链接的示例代码。作者回顾了早期学习Python时的开发过程,提供了完整的源代码及必要的库依赖说明。代码通过urllib和BeautifulSoup解析网页,提取并解码搜索资源对应的百度云地址,适合初学者参考Python网络爬虫的基础实现逻辑。
本文详细解析在Linux CentOS 7环境下使用Python 2.7及Matplotlib绘制图表时中文显示为方框的问题。通过获取matplotlibrc路径、安装系统字体、修改配置文件及清除缓存等步骤,提供了一套完整的修复方案,确保横坐标等中文标签正常显示。