pandas read_table读取CSV文件的参数设置与默认行为分析
本文介绍如何使用pandas的read_table函数读取CSV文件。通过对比指定sep=','与不指定分隔符两种情况,分析read_table在默认行为下的数据解析差异。结果显示,明确指定分隔符可正确生成DataFrame结构,而省略sep参数可能导致列名合并及数据解析异常,建议在实际操作中显式声明分隔符以确保数据准确性。
2026-10-13
7

本文介绍如何使用pandas的read_table函数读取CSV文件。通过对比指定sep=','与不指定分隔符两种情况,分析read_table在默认行为下的数据解析差异。结果显示,明确指定分隔符可正确生成DataFrame结构,而省略sep参数可能导致列名合并及数据解析异常,建议在实际操作中显式声明分隔符以确保数据准确性。
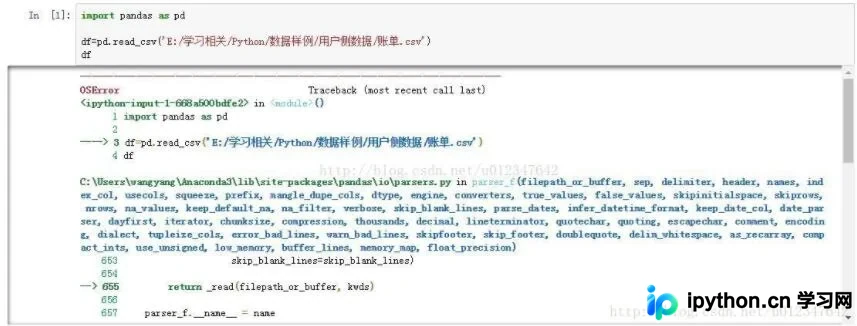
在使用Pandas的read_csv函数时,若文件路径或文件名包含中文字符,直接导入会触发报错。本文介绍通过Python内置open函数先打开文件对象,再将其传递给read_csv的方法,从而成功读取含中文路径的数据文件。
本文详细解析了朴素贝叶斯分类器的数学原理及Python实现方法。从贝叶斯定理出发,推导先验概率、后验概率与似然度的关系,并介绍算法流程。通过具体示例演示如何计算条件概率,最后提供完整的Python类封装代码及Matlab实现对比,帮助开发者掌握该算法的核心逻辑与应用。
本文介绍如何使用Python的Numpy库高效读取CSV文件,并将数据转换为数组或列表格式。同时详细讲解了利用np.delete函数对Numpy数组进行行和列删除的具体语法与参数设置,包括axis参数的作用,帮助开发者快速掌握基础数据处理技巧。
本文介绍在Python中将mat文件转换为csv文件的两种常用方法。第一种利用h5py库直接读取HDF5格式数据并转为DataFrame;第二种通过scipy.io.loadmat加载结构体后提取数据。两种方案均使用pandas将结果保存为csv文件,适用于数据预处理及格式转换场景。
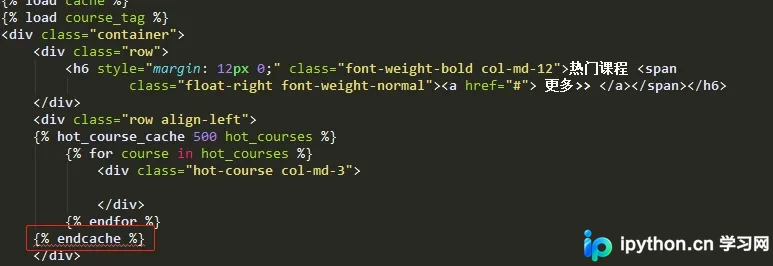
本文深入探讨Django模板碎片缓存的性能瓶颈,指出常规方式需视图层预取数据导致冗余。通过实现自定义模板标签,引入回调函数机制,实现缓存数据的按需获取与渲染解耦。该方法避免了视图层重复代码,提升了内存利用率,并提供了完整的代码实现示例及IDE兼容性说明。
本文深入解析Django框架中的多表查询机制,重点阐述ForeignKey与ManyToManyField的使用。通过官方示例代码,详细说明外键约束、反向查询、自定义关联表及多对多关系的添加删除操作,帮助开发者掌握Django模型层的核心关联查询技巧。
本文系统梳理了Python中处理CSV文件的两种主流方式:内置csv模块与第三方Pandas库。详细解析了csv.writer、csv.DictWriter等核心类的创建与读写方法,涵盖数据写入、读取及方言注册;同时深入讲解Pandas中read_csv、to_csv等导入导出接口,以及数据筛选、清洗、分组聚合、合并与统计等高频操作,助力开发者高效处理结构化数据。
本文介绍如何利用Python的NumPy库实现CSV文件与矩阵之间的相互转换。通过loadtxt函数可将CSV数据读取为矩阵,而savetxt函数则能将矩阵数据保存为CSV格式,适用于基础的数据处理场景。
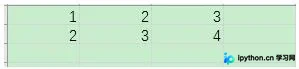
本文介绍如何使用Python将两个CSV文件的数据进行合并,重点演示追加模式。通过直接读取源文件内容并写入目标文件,实现快速的数据整合。文中提供了具体的代码示例及操作前后的数据对比,帮助读者掌握这一基础且实用的数据处理技巧。
本文分析Python爬虫中常见错误:在循环外定义字典并多次调用list.append(),导致列表中所有元素指向同一内存地址,最终值被最后一次循环覆盖。通过将字典初始化移至循环内部,确保每次迭代创建新对象,从而正确保存所有数据。
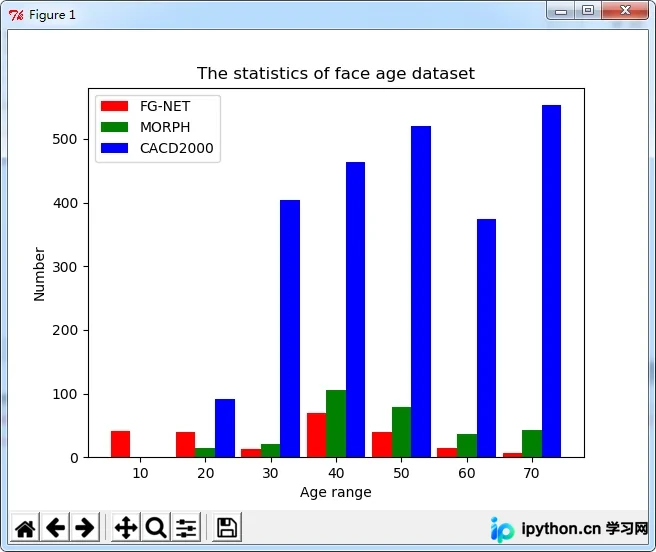
本文详细介绍如何使用Python的matplotlib库绘制柱状统计图。通过具体案例展示如何设置坐标轴标签、标题、Y轴范围,并利用bar函数绘制多组数据,配合label和legend生成图例。代码包含FG-NET、MORPH及CACD2000数据集的年龄分布统计,适合需要快速实现数据可视化的开发者参考。