

Python实现文件数据去重与正则提取实战
本文介绍利用Python进行文件读写、正则表达式提取及集合去重的完整流程。通过示例代码展示如何遍历源文件,使用re模块匹配特定字段,并借助set数据结构实现高效去重,最终将唯一结果写入目标文件。
2026-10-13
8

本文介绍利用Python进行文件读写、正则表达式提取及集合去重的完整流程。通过示例代码展示如何遍历源文件,使用re模块匹配特定字段,并借助set数据结构实现高效去重,最终将唯一结果写入目标文件。
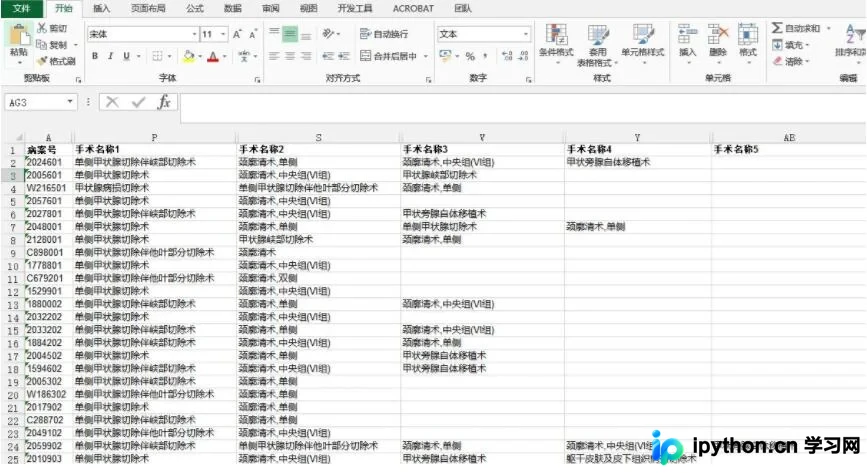
本文介绍如何使用Python从包含近2000行的数据表中提取含特定关键字的整行数据。针对Excel单列筛选导致顺序混乱的问题,通过Python脚本实现多列(P, S, V, Y, AB列)关键字‘颈廓清术,中央组(VI组)’的匹配,并完整保留原始数据顺序。最后提供利用Excel定位空值删除空白行的后续处理技巧,确保输出表格整洁且逻辑一致。
本文介绍利用Python将网页新闻转换为语音文件的完整方案。通过readability或goose3库提取网页正文,调用百度REST API进行文本转语音,并使用playsound库实现音频播放。文章详细讲解了API调用限制、文本切割合并及环境配置等关键步骤,帮助开发者快速实现网页朗读功能。
本文介绍Python处理Excel时插入和删除行的两种方案。openpyxl虽常用但中间操作性能差,需转换列表或修改源码;推荐xlwings,支持调用VBA接口,在Windows和macOS下运行高效且兼容WPS,适合需要动态调整行数的场景。
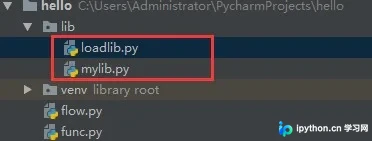
本文详细讲解Python中引入外部文件的两种核心方式。首先介绍标准的import语句,通过模块名作为命名空间调用类与方法;其次演示from...import语法,直接导入类以简化调用步骤。通过创建mylib模块并编写Hello类实例,对比两种方式的代码差异与运行结果,帮助开发者掌握Python模块引用的最佳实践。
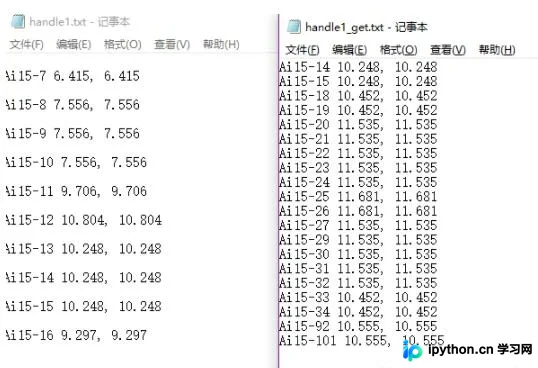
本文介绍使用Python3.5读取txt文件,通过正则表达式提取每行逗号后的数值,并过滤掉小于9.500或大于12.500的行,最终将保留的数据写入新文件的完整代码与步骤。
本文介绍如何使用Python的pandas库实现Excel文件(xlsx)与CSV文件之间的相互转换。通过read_excel和to_csv、read_csv和to_excel等核心函数,可快速完成数据格式迁移,适用于日常数据处理与批量文件转换场景。
本文深入解析Python中dir()与__dict__的区别。__dict__仅展示对象自身属性且支持增删改查,而dir()返回包含继承属性的列表,仅用于查看。通过类与实例的对比示例,阐明两者在数据访问与操作上的不同机制,帮助开发者准确使用属性管理工具。
本文介绍了使用Python openpyxl库遍历Excel文件中所有工作表并查找特定字符串的方法。通过遍历每个sheet中的单元格,检查其值是否包含目标字符串,并输出匹配结果。该方法适用于需要批量处理Excel文件内容的场景。
本文介绍如何使用Python的openpyxl库获取Excel文件中所有Sheet的名称。通过安装openpyxl并使用load_workbook方法加载文件,可直接访问sheetnames属性获取标签列表,操作简便且适用于Windows环境。
在使用pandas保存Excel文件时,直接调用to_excel会覆盖原有文件。本文介绍利用ExcelWriter结合openpyxl引擎,通过load_workbook加载已有工作簿,再写入新Sheet的方法,从而实现在不删除原有Sheet的前提下追加数据。
本文介绍使用pandas向Excel文件写入多个Sheet时的常见陷阱。直接循环调用to_excel会导致后续写入覆盖前次结果,最终文件仅保留最后一次数据。正确做法是利用ExcelWriter对象统一管理写入过程,确保所有Sheet数据完整保存至同一文件中。