

Python3使用urllib抓取贴吧邮箱与QQ号实战及代理配置详解
本文详细介绍如何利用Python3的urllib库编写爬虫程序,从百度贴吧页面中提取邮箱地址和QQ号码。内容涵盖基础抓取代码逻辑、正则表达式匹配技巧,以及重点解析如何配置HTTP代理(Proxy)以规避访问限制。通过实例代码演示全局Opener设置与局部调用的区别,帮助开发者掌握更灵活的代理控制方法,提升爬虫稳定性。
2026-10-12
6

本文详细介绍如何利用Python3的urllib库编写爬虫程序,从百度贴吧页面中提取邮箱地址和QQ号码。内容涵盖基础抓取代码逻辑、正则表达式匹配技巧,以及重点解析如何配置HTTP代理(Proxy)以规避访问限制。通过实例代码演示全局Opener设置与局部调用的区别,帮助开发者掌握更灵活的代理控制方法,提升爬虫稳定性。
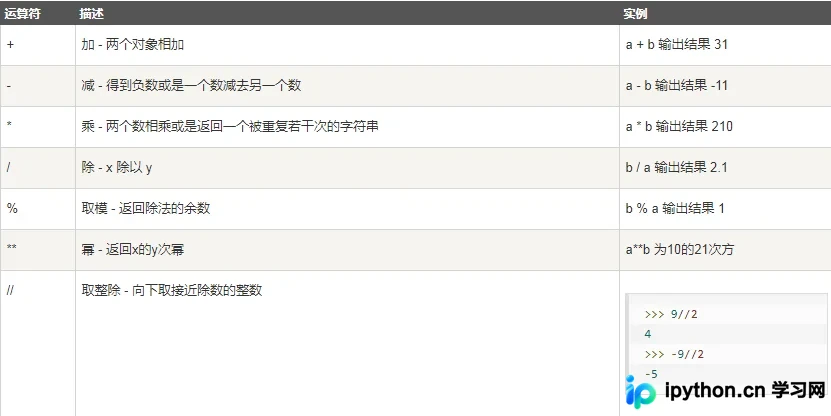
本文详细解析Python3中的各类运算符,涵盖算术、赋值、比较、逻辑、位、成员及身份运算符。通过具体代码示例展示加减乘除、取整、幂运算等用法,并说明运算符优先级规则,帮助开发者掌握Python基础语法。
本文介绍如何使用Python3将一维数组按指定的标准长度分割为二维数组。通过列表推导式和切片操作,可以高效地实现这一功能。示例代码展示了具体的实现步骤和结果,适用于数据处理和算法开发场景。
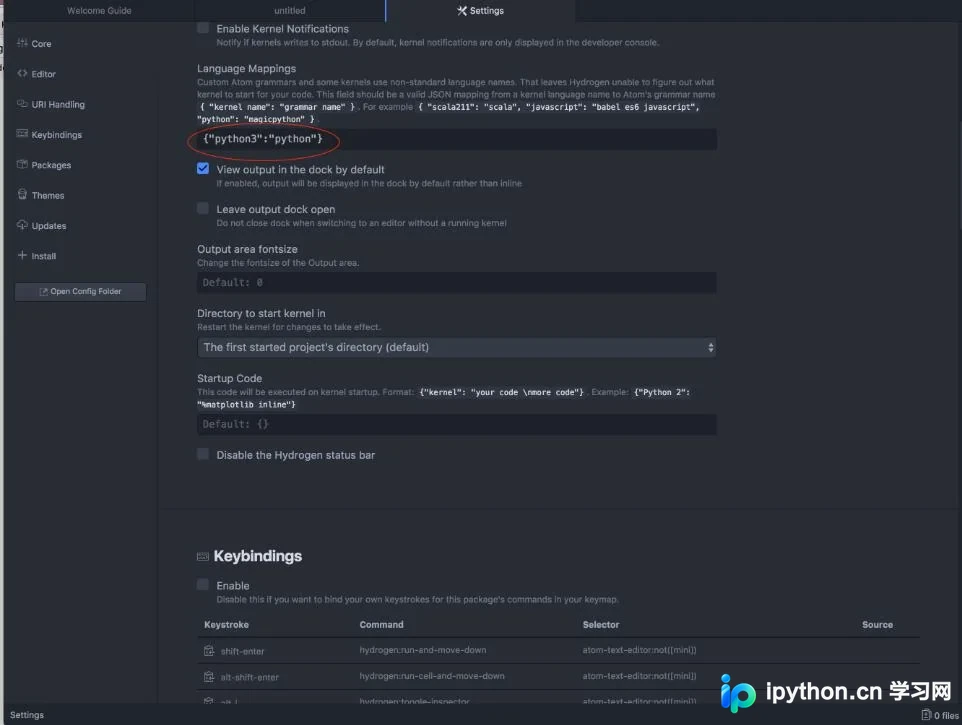
Atom编辑器通过Hydrogen插件运行Jupyter代码时,若无法调用Python3环境,可通过修改Jupyter内核配置文件及Hydrogen语言映射解决。本文详细记录了修改kernel.json、配置Language Mappings以及安装升级ipykernel的具体操作步骤,帮助开发者快速恢复代码执行功能。
本文梳理了 Python3 中提升开发效率的关键新特性,涵盖 3.0 至 3.7+ 版本。重点解析 f-strings 字符串格式化、Pathlib 路径处理、Type Hinting 类型提示、Enum 枚举类、lru_cache 缓存装饰器、扩展迭代解包及 Data Classes 数据类。通过对比 Python2 与 Python3 的代码差异,帮助开发者写出更简洁、直观且高性能的现代 Python 代码。
本文分享基于Python3制作的表白程序源码,结合turtle图形库绘制爱心轨迹与终端文本交互。代码包含姓名校验逻辑、延时动画及自定义名字列表配置,适用于Python初学者参考学习图形界面编程与基础逻辑控制。
本文详细解析了Python3中反转单链表的两种主流实现方式:迭代法与递归法。通过对比方案一的双指针迭代技巧与方案二的递归调用逻辑,帮助开发者深入理解链表操作的核心机制,并提供完整的代码示例供参考学习。
本文系统梳理Python3标准库中高频使用的核心模块,涵盖文件与目录操作(os、shutil、glob)、系统交互(sys)、文本处理(re、string)、数学与随机数(math、random)、网络通信(urllib、smtplib)、时间处理(datetime)及数据压缩(zlib等)。通过具体代码示例展示各模块的关键用法,并介绍性能测试(timeit、profile)与自动化测试(doctest、unittest)的最佳实践,帮助开发者高效利用内置资源。
本文介绍Python3中math.log10()函数的基本用法。该函数用于计算以10为底的对数,需通过导入math模块调用。参数x必须为正数,函数返回对应的对数值。文章包含代码示例及运行结果分析,帮助开发者快速掌握该函数的应用。
本文解决PHP通过exec调用Python3脚本时返回中文乱码的问题。核心在于统一编码处理:PHP端使用urlencode对参数进行转码,Python端通过urllib.parse.unquote解码,并配置sys.stdout为UTF-8编码输出。确保跨语言调用时字符编码一致,避免乱码。
本文详解如何在Python3中利用requests模块实现文件下载进度的实时显示。通过设置stream参数启用流式传输,结合Response.iter_content分块读取数据,并自定义ProgressBar类利用\r控制光标刷新,从而在控制台输出美观的下载进度条。
本文介绍在 Python3 中使用正则表达式进行万能匹配的方法。通过采用 [\s\S]*? 模式,可以突破单行匹配的限制,实现对包含换行符在内的任意字符进行非贪婪匹配。结合括号分组,可进一步提升匹配效果与提取效率。