

Python3爬虫爬取百姓网列表并保存为json功能示例【基于request、lxml和json模块】
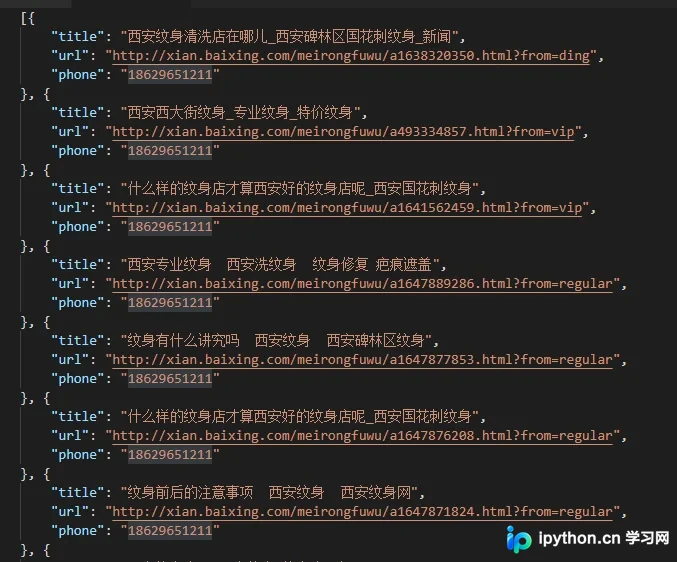
本文介绍如何使用Python3结合requests、lxml和json模块,爬取百姓网列表数据并保存为JSON格式。文章详细讲解了环境准备、代码实现及文件保存步骤,适合初学者参考学习。
2026-10-11
6

本文介绍如何使用Python3结合requests、lxml和json模块,爬取百姓网列表数据并保存为JSON格式。文章详细讲解了环境准备、代码实现及文件保存步骤,适合初学者参考学习。
本文详细介绍如何在Linux环境下搭建Python3 Jupyter Notebook服务器。内容涵盖创建独立虚拟环境、安装Jupyter、生成配置文件及密码密文、修改安全与访问参数,以及通过前台或后台nohup方式启动服务,旨在帮助用户快速部署可用的远程数据科学工作空间。
本文介绍在 Python3 中如何利用 subprocess.Popen 异步启动外部程序,并通过 os.system 调用 taskkill 命令强制关闭进程。对比了 subprocess.getoutput 和 os.system 的同步阻塞特性,提供了完整的代码示例与注意事项,帮助开发者实现非阻塞的程序调用与控制。
本文介绍在Python3中处理网页爬取数据时,如何将包含Unicode编码的列表转换为可读的中文。通过re模块提取目标文本,利用encode('latin-1')与decode('unicode_escape')的组合技巧,实现编码的正确转换,并输出为中文列表。

本文详解Python3中Cookie的创建、保存与读取方法。通过CookieJar、LWPCookieJar等类,结合urllib.request实现HTTP请求中的Cookie管理。涵盖Cookie的生成、持久化到文件(如LWPCookieJar)以及从文件读取并复用Cookie进行后续请求的完整流程,适用于需要模拟登录或保持会话状态的爬虫开发场景。
本文深入解析Python3中函数的四种核心参数用法:默认参数、关键参数、非固定参数(*args与**kwargs)及其组合使用。同时详细阐述全局变量与局部变量的作用域规则及优先级,通过具体代码示例展示参数传递机制与变量生命周期,帮助开发者编写更规范、灵活的Python代码。
本文详细介绍在Python3环境下,如何使用pymssql、cx_Oracle和pymysql库分别连接SQLServer、Oracle和MySQL数据库。涵盖环境配置、依赖安装、连接字符串格式及代码验证方法,适用于局域网多服务器部署场景。
本文详细介绍了在Python3环境下导入CSV文件的完整流程,包括打开文件、读取表头、处理剩余数据行以及异常处理机制。通过具体代码示例展示了如何使用csv模块高效读取数据,并对比了与Python2的细微差异,帮助开发者快速掌握CSV文件处理技巧。
本文详细讲解在Ubuntu 16.04和树莓派系统中通过源码编译方式配置Python3与OpenCV环境的完整步骤。内容涵盖基础依赖安装、pip环境更新、numpy配置以及cmake编译参数调整,特别针对树莓派与Ubuntu在Python库路径上的差异提供了具体解决方案,帮助用户避免pip安装导致的版本冲突问题。
本文详解 Python3 中处理中文文件读写的方法。Python3 默认使用 Unicode 字符串,读写文件时需指定编码(如 utf-8 或 gb2312)。通过 codecs.open 可简化编码处理,避免手动 decode/encode 转换。文章提供具体代码示例,展示如何读取、写入及转换不同编码的文本文件,解决中文乱码问题。
本文详细解析Python3中的文件读写操作,涵盖open函数的多种模式(r, w, a, r+, w+, b等)及其适用场景。重点介绍使用with语句进行上下文管理的最佳实践,以及read, write, seek, truncate等核心文件对象方法的用法与注意事项,帮助开发者安全高效地处理文件I/O。
本文详细介绍使用Python3编写的信用卡自助服务系统,涵盖主程序执行逻辑、核心功能函数及用户数据文件结构。通过解析登录与交易日志,展示系统对卡片认证、还款、转账及账单查询等操作的记录机制,为开发者提供完整的代码参考与运行示例。