

Python爬虫应对反爬机制的常见策略与实施要点
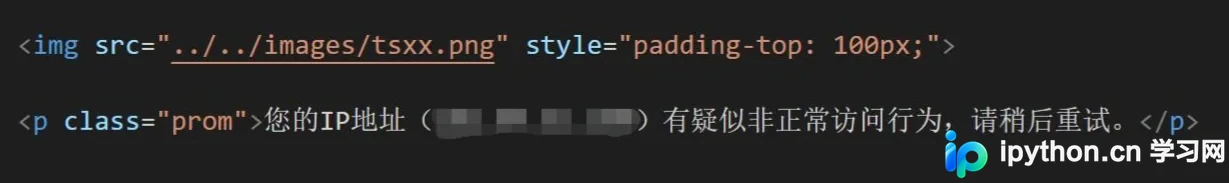
本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。
2026-10-14
6

本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。
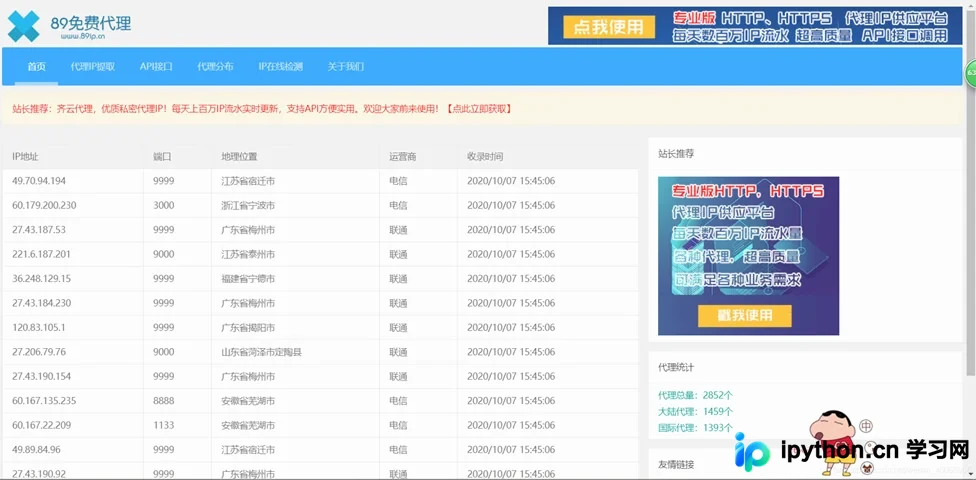
本文介绍使用Python爬取免费代理IP并验证其可用性的完整流程。通过Requests获取网页源码,利用BeautifulSoup解析提取IP与端口,再向百度发起带代理的请求测试状态码。代码支持自定义页数遍历,最终输出所有有效IP列表,解决手动测试效率低下的问题。
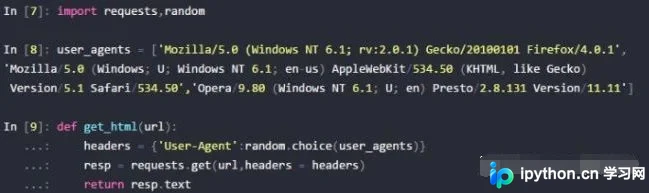
本文详解Python爬虫应对网站反爬机制的多种策略。通过随机化User-Agent、设置随机请求间隔、复用浏览器Cookie以及轮换代理IP,可有效降低被封禁风险。文中提供具体代码示例及GitHub相关项目参考,帮助开发者在大数据量爬取时保持连接稳定。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
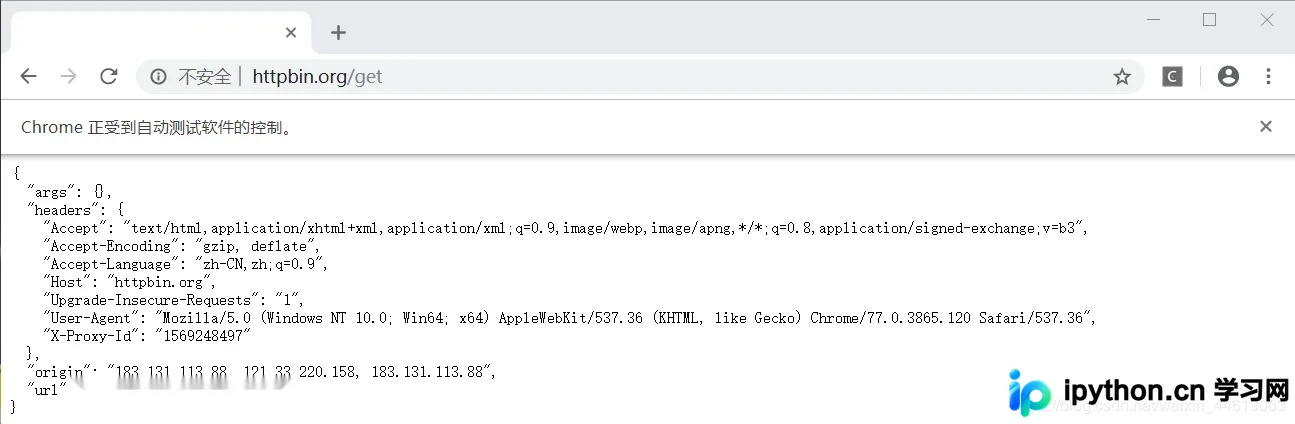
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文介绍如何使用Python构建代理IP池的第一步:获取IP。通过结合Requests和PyQuery库,利用自定义的ProxyMetaclass元类自动识别以crawl开头的方法,实现从多个免费代理网站批量抓取IP和端口。代码采用生成器模式返回数据,便于后续存储与检测,为反爬策略提供灵活的IP轮换方案。
本文详细解析Python爬虫中常见的Headers、IP限制及User-Agent反爬策略,并提供代理池与随机UA解决方案。重点讲解如何通过F12开发者工具定位XHR数据包,抓取民政部行政区划、豆瓣电影及腾讯招聘等网站的Ajax动态加载数据,结合正则与XPath实现增量抓取与完整数据提取。
本文介绍在Python中验证代理IP可用性的几种方法。通过urllib2构建代理 opener、使用requests库简化代码,以及利用telnetlib进行端口连通性测试。重点解析如何判断代理是否有效,并将可用IP存入Redis以便后续爬虫调用,帮助解决IP被封问题。
本文介绍使用Python自动从网站批量抓取免费代理IP,并通过Socket连接验证其可用性的方法。代码包含IP抓取、有效性判断及本地JSON存储逻辑,支持定时更新以维持IP池的有效性,适合需要稳定代理资源的开发场景。
本文介绍使用Python抓取西刺代理网站IP并验证其可用性的完整流程。针对反爬机制,通过设置请求头、增加延时及切换备选网站(如IP巴士)来应对封禁。代码展示了从抓取、解析到通过测试URL验证代理有效性的具体实现,旨在为开发者提供可参考的免费代理获取方案。
本文分享使用Python获取并验证免费代理IP的完整流程。通过正则表达式从西刺代理网站抓取IP及端口,利用多线程机制并行检测IP可用性,最终返回格式化的可用IP列表。代码包含getIP、check_one及mul_thread_check三个核心函数,适用于需要规避同一IP重复访问限制的数据抓取场景。
本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。