

Python字符串连接的三种方法及性能对比分析
本文详细解析Python中字符串连接的三种常用方法:加号(+)、join()及字符串格式化。通过Python 2.7在CentOS环境下的实测数据,对比了不同数量字符串连接时的性能差异。结果显示,连接少量字符串时加号效率更高,而大量字符串拼接则join方法优势明显,为开发者提供选型依据。
2026-10-13
6

本文详细解析Python中字符串连接的三种常用方法:加号(+)、join()及字符串格式化。通过Python 2.7在CentOS环境下的实测数据,对比了不同数量字符串连接时的性能差异。结果显示,连接少量字符串时加号效率更高,而大量字符串拼接则join方法优势明显,为开发者提供选型依据。
本文通过实验揭示Python中del语句并不真正释放内存,而是归还给内存池。只有通过显式调用gc.collect()才能强制回收对象。文章对比了不同环境下的内存消耗峰值与实时状态,指出在多线程或特定场景下gc的触发时机可能受系统可用内存影响,建议结合del与gc.collect()以优化脚本内存表现。
本文总结了Python中实现多字符替换的几种高效方法。当需替换字符较少时,推荐直接使用链式replace()调用以获得高执行效率;若涉及大量字符替换,则在for循环中调用replace()更为合适。文章还列举了maketrans、正则表达式等可行方案,并提供了性能对比参考,帮助开发者根据实际场景选择最优解。
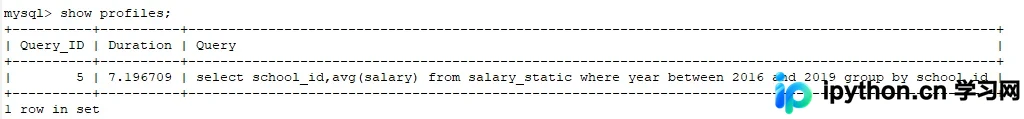
本文深入解析MySQL InnoDB引擎中因回表导致索引失效的经典案例。通过对比全表扫描与索引扫描的成本计算,揭示优化器在大数据量回表时误判的内在机制。文章提供了基于optimizer_trace的详细分析,并给出了通过创建覆盖索引解决回表开销过大的具体优化方案及临界值计算公式。
本文深入解析Python中Sync与Async的执行效率差异。通过纯CPU计算与高并发IO两种场景的对比实验,揭示async语法在纯计算中因事件循环开销略慢于sync,但在高并发IO场景下凭借协程非抢占式调度优势,显著优于多线程/进程方案。
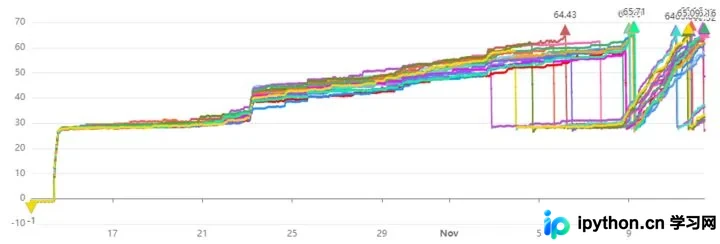
本文总结了一次Python服务内存泄漏的完整排查过程。通过对比新旧代码与依赖,锁定异常处理逻辑为根源:全局异常实例未回收导致内存持续攀升。文章详细演示了如何利用objgraph和pympler等工具定位泄漏变量,并通过traceback调用链分析确认问题,最终提供修复方案及进阶排查思路。
本文深入解析PyPy如何通过JIT编译和优化的垃圾回收机制显著提升Python代码执行速度。通过对比CPython,展示在长时间运行脚本中的性能优势,并明确指出C扩展模块和短脚本场景下的局限性,帮助开发者合理选择解释器。
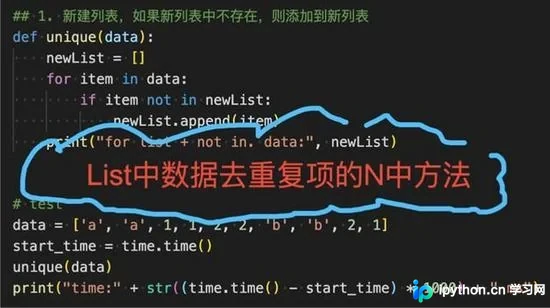
本文深入探讨Python中列表去重的多种实现方式,涵盖新建列表、原地删除、利用Set和Dict结构以及NumPy库等近20种方法。通过具体代码示例与时间复杂度分析,对比各方案在Python 2.7及更高版本中的执行效率与适用场景,帮助开发者根据实际需求选择最优的去重策略。
本文详细介绍如何在Django项目中引入SQLAlchemy构建数据库连接池,以解决高负载下频繁创建销毁连接的性能瓶颈。文章提供了两种修改Django源码的方法,重点解析了处理kwargs中字典类型导致的unhashable错误的关键代码修改,并附带了适用于Django 1.7与Python 2.7环境的配置示例。
本文介绍在Python 2.7.13环境中,通过遍历locals()字典并手动删除局部变量,配合gc.collect()强制垃圾回收,以释放函数执行后占用的内存。该方法适用于需要显式控制资源释放的场景,但需注意其适用性与潜在风险。
本文深入对比Numba与Cython两大Python加速工具。解析Numba通过JIT将Python转为LLVM IR实现自动并行与GPU支持的优势,以及Cython通过生成C代码提供底层控制的特性。分析两者在易用性、调试难度及适用场景上的差异,帮助开发者根据项目规模选择最佳性能优化方案。
本文系统讲解Python中位运算的核心概念、六种操作符语法及其在实际编码中的应用。通过底层二进制原理剖析,提供奇偶判断、异或求唯一值等经典案例,并附基准测试代码与性能对比分析,帮助开发者安全高效地掌握位级操作技巧。