Python处理4GB大文件:逐行读取与写入的高效实现方案
本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
2026-10-13
6

本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
本文深入解析Python中二维数据的两种主要实现方式:内置list与NumPy的array。通过代码实例对比两者在索引操作上的差异,重点展示numpy.array支持的多元组索引与切片功能,并分析list存储对象指针带来的内存开销。旨在帮助开发者根据场景选择合适的数据结构,提升数据处理效率。
针对Pandas处理亿行级大文件时内存溢出的问题,本文介绍了一种通过String中间格式降低内存占用的策略。虽然Pandas官方提供了to_string方法,但未直接提供反向转换。通过利用StringIO将字符串数据封装为文件对象,再配合read_csv函数,即可高效地将String还原为DataFrame,从而规避pickle保存时的额外内存开销。
本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
针对MySQL查询缓慢或生产环境表现不佳的问题,本文总结六大核心优化技巧。包括根据事务需求选择InnoDB或MyISAM引擎、避免在InnoDB中使用COUNT(*)获取近似行数、利用EXPLAIN分析查询执行计划以诊断全表扫描,以及通过添加合理索引减少扫描行数。同时强调代码级优化如仅SELECT所需字段及大量数据测试的重要性,帮助开发者提升数据库处理效率。
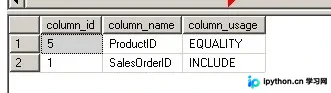
在SQL Server中,当面对复杂的查询语句且数据库性能缓慢时,可以通过系统动态管理视图(DMV)快速定位缺失的索引。本文详细介绍sys.dm_db_missing_index_details、groups、group_stats和columns这四个核心视图,结合具体SQL示例演示如何获取缺失索引字段、预估性能提升比例,并解析生成的索引创建语句,帮助DBA科学评估索引调整方案。
本文探讨在Python中处理百万级对象实例时的内存优化方案。通过解析__dict__机制对内存的占用,介绍使用__slots__声明固定属性列表的方法。该方法能禁用动态属性添加,从而显著降低单个实例的内存消耗,适用于游戏服务器等高性能场景。
针对拥有3-4年经验、擅长普通WEB系统开发但面对高并发和复杂业务时缺乏思路的PHP程序员,本文提供了突破技术瓶颈的具体方向。核心建议包括深入理解底层机制(操作系统、C语言)、掌握面向对象设计与抽象能力,并采用“以机制为中心、任务驱动、迭代优化”的学习方法论。通过IP地域查询等实际案例,演示了从基础实现到共享内存缓存再到编写PHP C扩展的性能优化全流程,帮助开发者构建高性能系统思维。
本文通过元胞自动机案例,详解如何使用Cython将Python双重循环转换为C扩展以提升执行效率。内容涵盖编写.pyx文件、配置setup.py编译脚本、处理NumPy类型定义及边界检查关闭,并展示实测结果:Cython版本较原生Python运行速度提升600倍以上,为计算密集型任务提供高效解决方案。
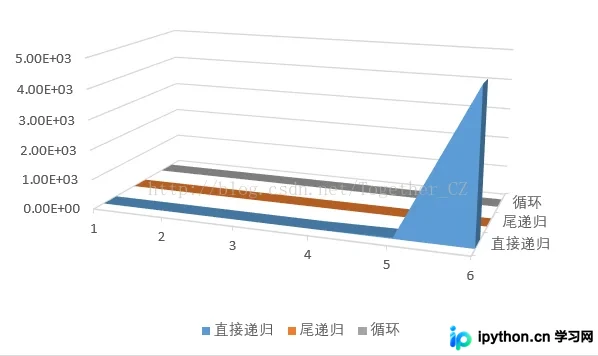
本文深入解析Python中斐波那契数列的三种实现方式:直接递归、尾递归及循环。通过代码示例与实测数据对比,揭示直接递归在数值增大时呈指数级增长的时间消耗,而尾递归与循环则保持极低的耗时。文章指出循环性能略优于尾递归,建议在实际开发中优先使用循环或尾递归以规避栈溢出风险并提升执行效率。
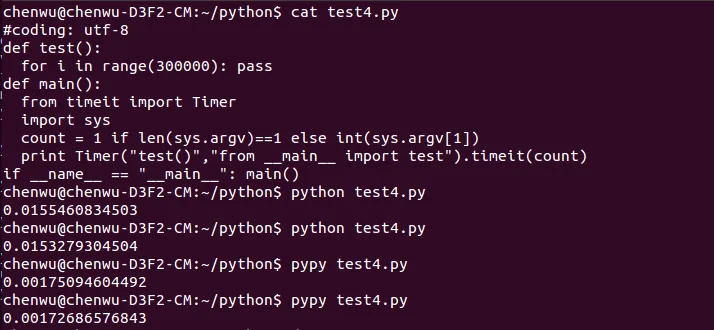
本文深入解析PyPy架构,阐述其由RPython实现的解释器与支持多后端的编译器两部分组成。通过对比CPython、Pyston与PyPy的性能测试数据,展示PyPy在纯Python代码中的显著速度优势。同时分析PyPy在C/C++混合编程场景下的局限性,介绍ctypes与cffi两种扩展方式,并指出当前PyPy在C扩展兼容性方面仍存在的挑战。
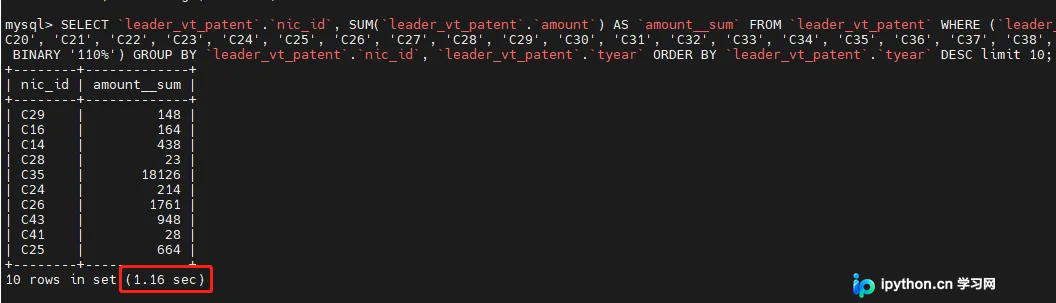
本文分析MySQL中LIKE BINARY与LIKE模糊查询的性能差异。通过Django ORM实例,展示区分大小写的LIKE BINARY导致索引失效或全表扫描引发的耗时问题,对比不区分大小写的LIKE带来的性能提升。详细讲解通配符%和_的用法、大小写敏感原理及转义技巧,为数据库查询优化提供参考。