

MySQL LIKE BINARY与LIKE性能差异:区分大小写查询优化

在MySQL查询中,LIKE 与 LIKE BINARY 的核心区别在于大小写敏感度,但这往往带来显著的性能差异。本文结合Django ORM实战案例,剖析因错误使用区分大小写的模糊匹配导致的查询变慢问题,提供从ORM到原生SQL的优化方案,并详解通配符用法及注意事项。
1. 案例:区分大小写查询导致的性能瓶颈
在实际项目接口开发中,随着数据库表数据量的增长,某些原本正常的查询可能会突然变得缓慢。一个常见的诱因是模糊匹配语句的大小写敏感性设置不当。
第1步:定位慢查询原因
现象:项目接口请求耗时增加至3-4秒。
排查:经过排查发现,底层SQL查询语句使用了 LIKE BINARY(区分大小写)。虽然业务逻辑上模糊匹配的字符并不严格区分大小写,但 LIKE BINARY 在某些字符集或排序规则下可能限制索引的有效使用,导致查询效率显著下降。
解决思路:将模糊匹配修改为不区分大小写(即移除 BINARY 关键字或使用ORM的不敏感写法)。
第2步:优化前(区分大小写)
在Django ORM中,默认的属性过滤通常对应区分大小写的匹配行为(取决于模型定义),生成原生SQL时表现为 LIKE BINARY。
# ORM 示例 (等价于 like binary)
生成的MySQL原生DQL如下:
SELECT `leader_vt_patent`.`nic_id`, SUM(`leader_vt_patent`.`amount`) AS `amount__sum`
FROM `leader_vt_patent`
WHERE (`leader_vt_patent`.`nic_id` IN ('C13', 'C14'...))
AND `leader_vt_patent`.`region_id` LIKE BINARY '110%'
GROUP BY `leader_vt_patent`.`nic_id`, `leader_vt_patent`.`tyear`
ORDER BY `leader_vt_patent`.`tyear` DESC;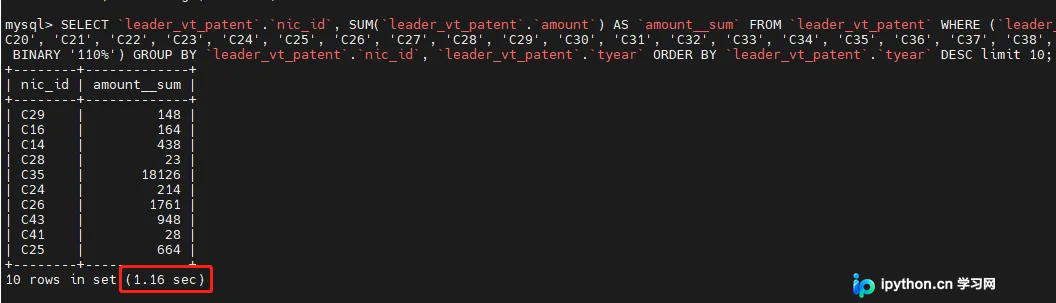
在此模式下,查询耗时约为 1.16s。
第3步:优化后(不区分大小写)
利用Django ORM提供的 istartswith 属性,可以明确指定不区分大小写的起始匹配,生成的SQL使用标准的 LIKE 而非 LIKE BINARY。
# ORM 示例 (istartswith == like)
XXXmodel.objects.filter(
        region_id__istartswith=region_id[:3],
        nic_id__in=nic_code_list
        ).values('nic_id').annotate(Sum('amount'))
对应的MySQL原生DQL:
SELECT `leader_vt_patent`.`nic_id`, SUM(`leader_vt_patent`.`amount`) AS `amount__sum`
FROM `leader_vt_patent`
WHERE (`leader_vt_patent`.`nic_id` IN ('C13', 'C14'...))
AND `leader_vt_patent`.`region_id` LIKE '110%'
GROUP BY `leader_vt_patent`.`nic_id`, `leader_vt_patent`.`tyear`
ORDER BY `leader_vt_patent`.`tyear` DESC;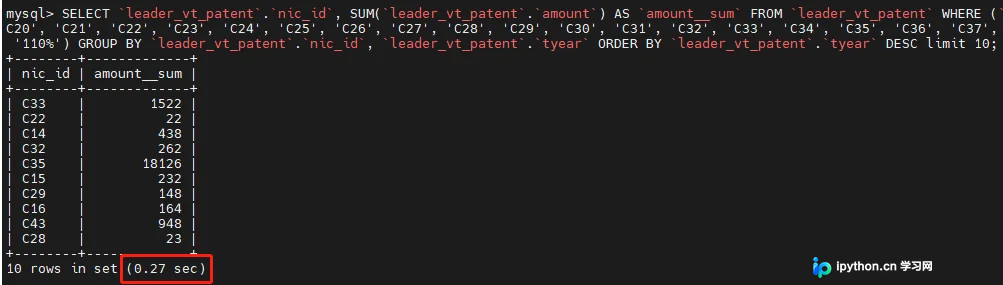
优化后,查询耗时降至约 0.27s,性能提升显著。
2. MySQL LIKE 与 LIKE BINARY 原理详解
理解两者的区别需要从MySQL的字符集和排序规则(Collation)入手。
2.1 核心区别
- LIKE BINARY:强制进行二进制比较,严格区分大小写。例如
'a'与'A'被视为不同字符。 - LIKE:是否区分大小写取决于表的字段 COLLATE 属性。
- 如果 COLLATE 以
_bin结尾(如utf8_bin),则区分大小写。 - 如果是默认的
_ci(case-insensitive,如utf8_general_ci),则不区分大小写。
- 如果 COLLATE 以
- ORM 对应关系:
- 区分大小写:filter(name__contains='sxn')或filter(name__startswith='sxn')(视具体配置而定)
- 不区分大小写:filter(name__icontains='sxn')或filter(name__istartswith='sxn')
2.2 通配符 % 的用法
% 代表任意长度的字符串(包括空字符串)。它是最常用的通配符,但将其置于搜索模式开始处(如 '%abc')会导致无法使用索引,搜索速度最慢。
例1:查找以指定字母开头的记录
SELECT name FROM tb_students_info WHERE name LIKE 'T%';
-- 结果:Thomas, Tom (假设不区分大小写或T为大写)
例2:查找不包含指定子串的记录
SELECT NAME FROM tb_students_info WHERE NAME NOT LIKE 'T%';
-- 结果:排除以T开头的所有姓名
例3:查找包含特定字符的记录
SELECT name FROM tb_students_info WHERE name LIKE '%e%';
-- 结果:Green, Henry, Jane 等包含e的名字
2.3 通配符 _ 的用法
_ 仅代表单个字符,不能为空。例如 'a_b' 匹配 'acb'、'adb',但不匹配 'ab' 或 'aebd'。
例:查找特定长度结尾的记录
SELECT name FROM tb_students_info WHERE name LIKE '____y';
-- 结果:Henry (假设只有5个字母且以y结尾)
2.4 大小写敏感测试
当需要严格匹配大小写时,必须使用 BINARY 或确保字符集排序规则为二进制。否则,'t%' 会同时匹配 'Tom' 和 'Thomas'。
-- 不区分大小写(匹配所有t或T开头的)
SELECT name FROM tb_students_info WHERE name LIKE 't%';

-- 区分大小写(仅匹配小写t开头的,若无数据则返回空)
SELECT name FROM tb_students_info WHERE name LIKE BINARY 't%';
3. 高级技巧:处理含通配符的数据
如果查询的目标数据本身包含通配符字符(如字面量的 % 或 _),直接使用 LIKE 会导致误匹配。此时需要使用转义符。
场景:将学生姓名改为 Dany%,若要查询姓名为 Dany% 的记录,需转义 %。
SELECT NAME FROM test.tb_students_info WHERE NAME LIKE '%\%';
上述语句中,第一个 % 匹配任意前缀,\% 匹配字面量的百分号。
4. 使用通配符的注意事项
- 避免尾部空格干扰:如
'T% '不会匹配'Tom',因为末尾多了空格。 - NULL值的特殊性:
%通配符无法匹配NULL值。若字段可能为NULL,需单独处理IS NULL。 - 位置影响性能:除非必要,否则不要将通配符放在字符串开头(如
'%abc'),这会迫使数据库进行全表扫描。'abc%'的形式更有可能利用索引。 - 优先使用其他操作符:如果能用
=、>等操作符完成的查询,不要使用LIKE,因为通配符处理开销较大。
以上就是关于MySQL中LIKE BINARY与LIKE模糊查询及性能优化的详细内容,更多关于MySQL查询优化与通配符使用的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









