Python字符串拼接+=与join()性能对比及优化指南
Python中频繁累积文本片段时,使用+=还是join()更高效?本文通过基准测试与底层原理分析表明:百万字符内两者差异微小,超量后+=因对象不可变性导致频繁内存复制而耗时指数级上升,join()凭借预计算总长一次性分配内存的优势显著提升性能。掌握此区别可有效避免循环拼接引发的性能瓶颈。
2026-10-11
6

Python中频繁累积文本片段时,使用+=还是join()更高效?本文通过基准测试与底层原理分析表明:百万字符内两者差异微小,超量后+=因对象不可变性导致频繁内存复制而耗时指数级上升,join()凭借预计算总长一次性分配内存的优势显著提升性能。掌握此区别可有效避免循环拼接引发的性能瓶颈。
本文深入解析Python中的复杂异常处理机制,系统讲解基础捕获结构、显式与隐式异常链、自定义异常设计、日志记录与重新抛出等进阶技巧。结合上下文管理器、装饰器及性能对比测试,提供可直接复用的工程化实践方案。
本文探讨在Python中计算列表中连续相同元素最大个数的两种方法:使用itertools.groupby和手动遍历。通过100万条数据的基准测试,对比发现手动实现方法在性能上显著优于itertools方案,适合对效率有严格要求的场景。
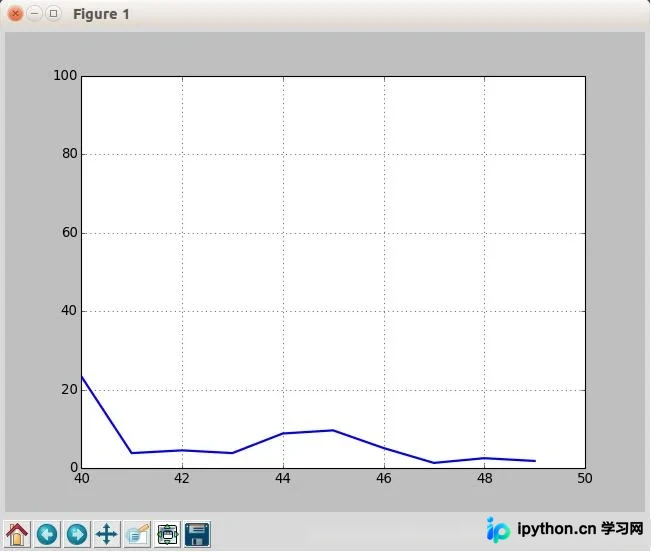
本文介绍如何使用Python的matplotlib和psutil库实现动态CPU性能监控。通过编写自定义脚本,实时获取CPU使用率并绘制动态图表,帮助开发者直观掌握系统资源使用情况。
本文深入解析Python列表去重的20种实现方式,涵盖基础循环、哈希表、集合排序及函数式编程等类别。重点对比了各方法的时间复杂度(O(n)至O(n²))与空间开销,推荐在Python 3.7+环境中优先使用`dict.fromkeys()`实现保序去重,并提供了处理不可哈希元素及带业务逻辑去重的工程方案。
本文介绍在 Python 中如何高效地对数据进行转换和聚合处理。通过生成器表达式作为函数参数,可以避免创建临时列表,从而节省内存并提升执行效率。文章涵盖平方和计算、文件筛选、元组转 CSV 及字典列表最小值查找等具体场景,展示优雅且高性能的代码实现方式。
针对Python运行时频繁的类型检查与边界验证导致的性能瓶颈,本文详解四种主流代码加速方案。涵盖基于AOT编译的Cython动态库生成、基于JIT的Numba机器码优化、替代解释器PyPy的切换策略,以及算法层面的数据类型替换与条件判断优化。附带基准测试数据,帮助开发者根据实际场景选择最优性能调优路径。
Python执行效率常受解释型特性、全局锁及动态内存管理制约。本文从代码结构、算法设计、系统工具与调试工作流四个维度提供优化方案,涵盖数据类型替换、生成器延迟计算、PyPy加速、Cython与Numba编译及向量化运算,配合标准性能分析流程,帮助开发者在保障正确性的前提下显著提升运行速度。
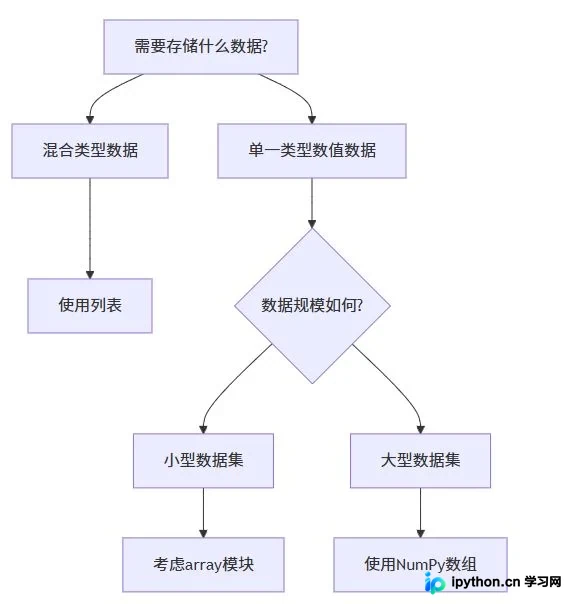
聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
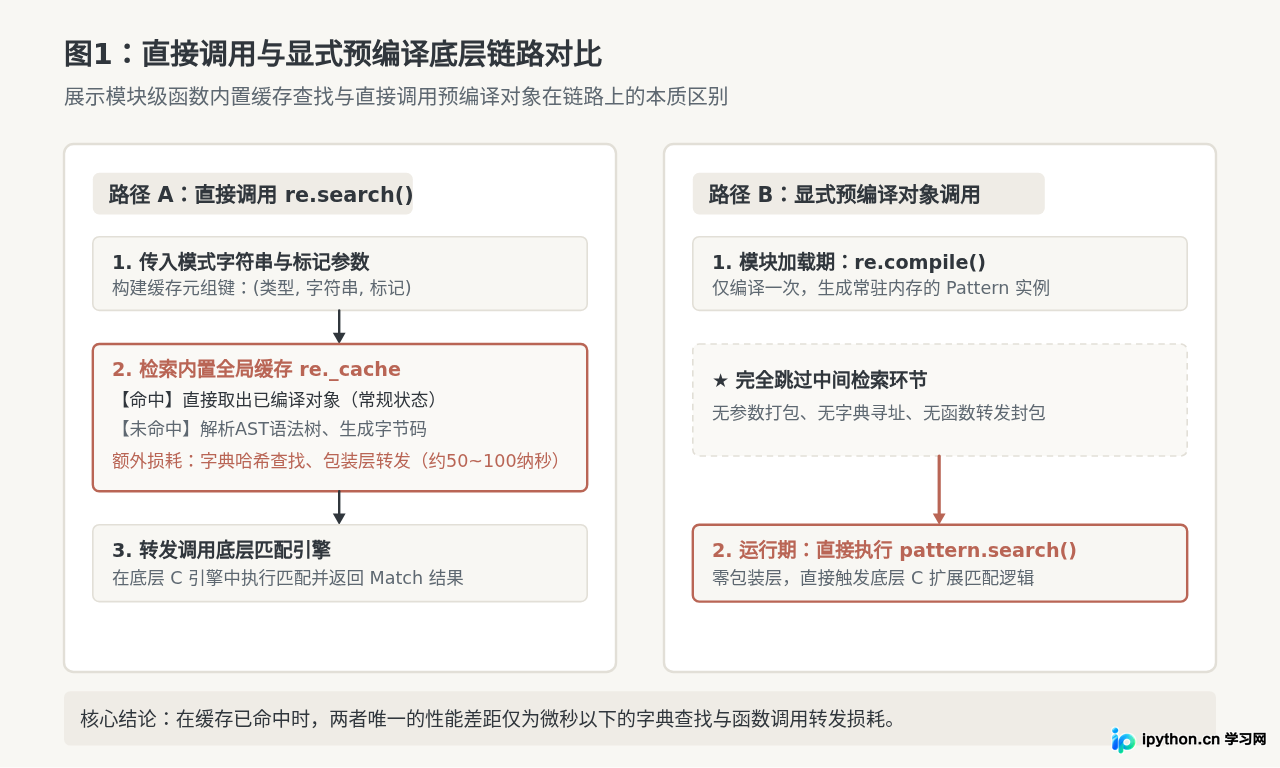
深入剖析Python中re.compile预编译对字符串匹配性能的真实影响,拆解内置缓存机制、耗时构成、缓存颠簸风险与工程决策准则。
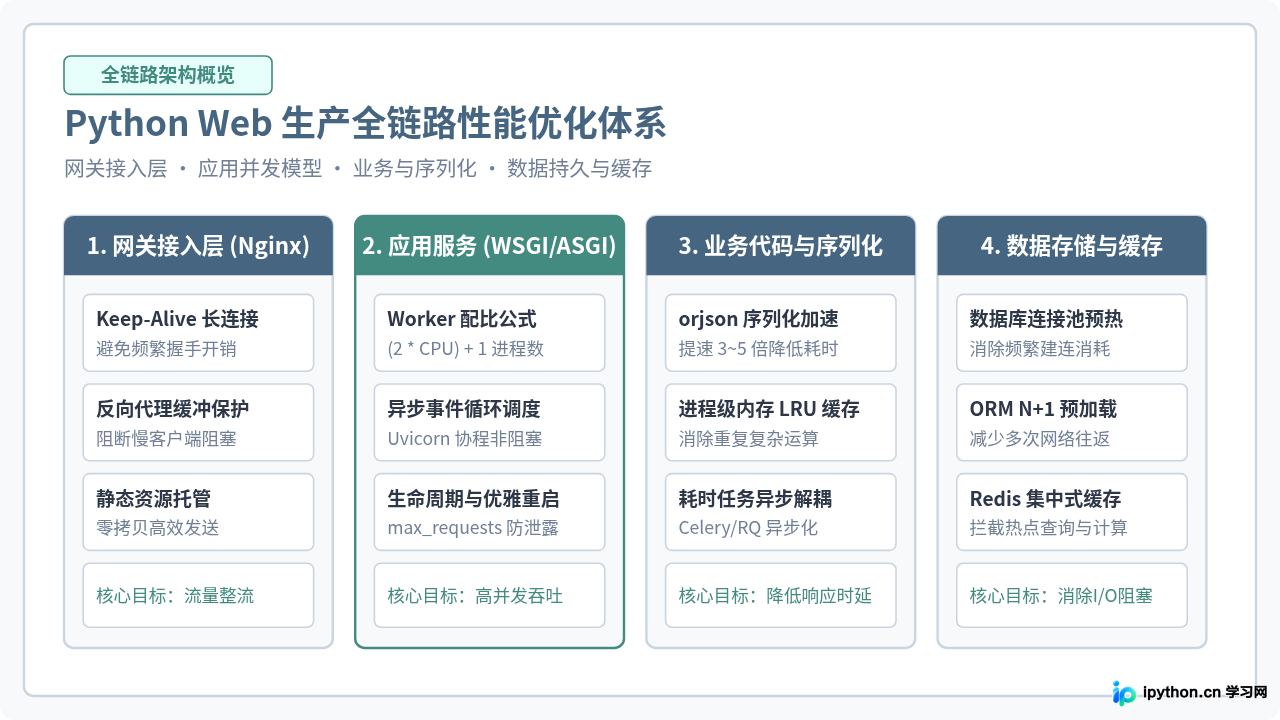
深入探讨Python Web框架性能优化,从代码层序列化与异步选型、数据库ORM治理与连接池,到Gunicorn/Uvicorn服务器及Nginx网关部署的全链路最佳实践。
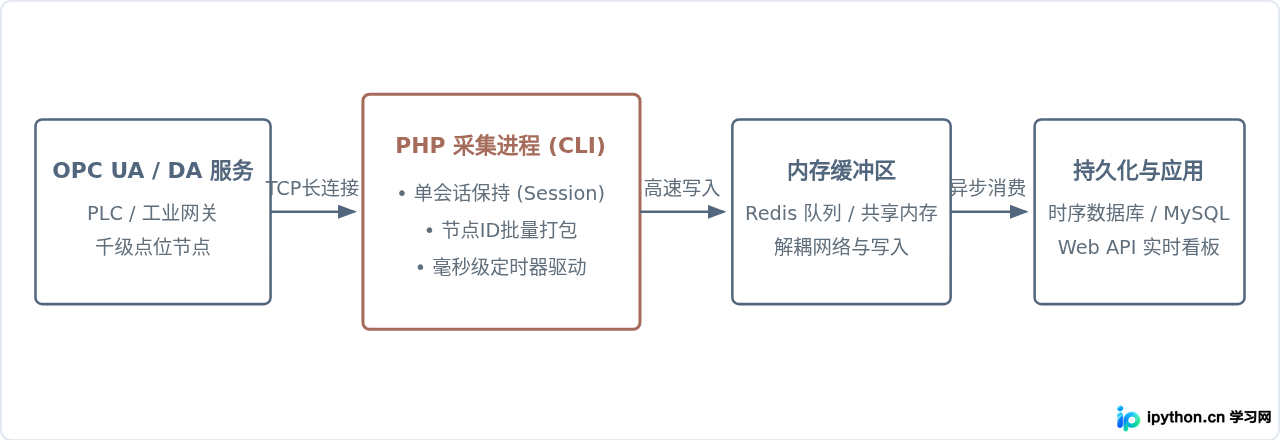
针对PHP在工业场景中轮询OPC服务器数据时常见的阻塞、高延迟及进程崩溃等问题,系统性讲解协议选型、批量读取、长连接保持、常驻内存治理与缓冲队列优化的实战技巧。