

Python中利用cached_property实现方法结果缓存与延迟加载
本文介绍在Python数据挖掘场景中,如何通过封装方法并利用[[wp:a1]]中的cached_property实现结果的缓存与延迟加载。通过示例展示,该方法确保复杂计算仅执行一次,后续调用直接返回缓存值,从而显著提升重复调用时的性能与资源利用率。
2026-10-13
6

本文介绍在Python数据挖掘场景中,如何通过封装方法并利用[[wp:a1]]中的cached_property实现结果的缓存与延迟加载。通过示例展示,该方法确保复杂计算仅执行一次,后续调用直接返回缓存值,从而显著提升重复调用时的性能与资源利用率。
本文探讨Python中处理大文件解压与读取的常见问题,重点解决因编码格式不一致导致的解压失败。通过引入'ignore'参数规避严格编码检查,并对比不同读取方式的性能,验证了逐行读取处理百万级数据行的可行性与效率,为大数据文件操作提供参考。
了解Java JVM编译器版本(Client与Server)在不同操作系统平台(Windows/Linux/macOS及32/64位)下的自动选择逻辑。通过java -version命令可验证当前环境使用的编译器类型,合理匹配平台以启用默认的分层编译策略,是进行基础性能优化的关键步骤。
本文通过代码测试对比了PHP中三种访问方式:`ClassName::method()`(类名访问静态)、`$obj->method()`(实例访问静态)和`$obj->nonStaticMethod()`(实例访问非静态)。测试结果表明,使用类名直接调用静态方法的效率低于通过实例调用同个静态方法,而通过实例调用非静态方法的耗时介于两者之间。测试基于Windows环境下的PHP CLI模式进行。
本文介绍在Python中使用re模块时,通过compile函数将正则表达式预编译为RegexObject对象的方法。相比每次调用模块级函数,预编译能复用编译结果,避免重复解析开销,从而显著提升多次匹配场景下的搜索效率。
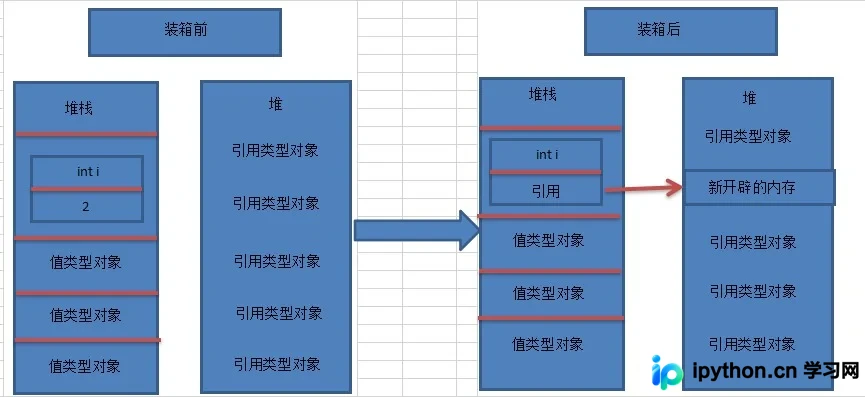
本文详细解析C#中值类型与引用类型转换时的装箱(Boxing)和拆箱(Unboxing)原理,揭示其对内存分配和GC的影响。通过代码示例演示非法拆箱的异常处理,并总结利用ToString()方法和泛型容器有效避免装箱拆箱带来的性能损耗的最佳实践。
本文通过实测分析Python标准库logging模块在机械磁盘上的写入性能,发现单进程每秒约写入2800-3000行日志,此时磁盘IO已饱和。针对多进程场景,提出按PID分离日志文件并合并的方案,指出多进程无法突破IO瓶颈,高性能场景需引入缓存或分布式日志系统。
本文针对2.9G大文件逐行读取场景,对比Python四种常见读取方式。测试环境为i7-6820HQ及32G内存。结果显示:readlines()内存飙升但速度较快;readline()内存稳定但耗时最长;直接迭代fh最快且内存低;fileinput模块最慢。推荐大文件处理使用直接迭代方式,兼顾效率与内存安全。
本文深入探讨 Python 性能优化的多种技术路径,涵盖 Cython、IPython.parallel、numexpr、multiprocessing、Numba 及 NumbaPro 等工具的应用场景。通过对比列表推导、迭代器、eval、生成器及 map 函数的执行效率,并结合 NumPy 数组的 C 与 Fortran 内存布局测试,揭示不同实现方式在时间与空间复杂度上的显著差异,为开发者提供具体的性能调优参考。
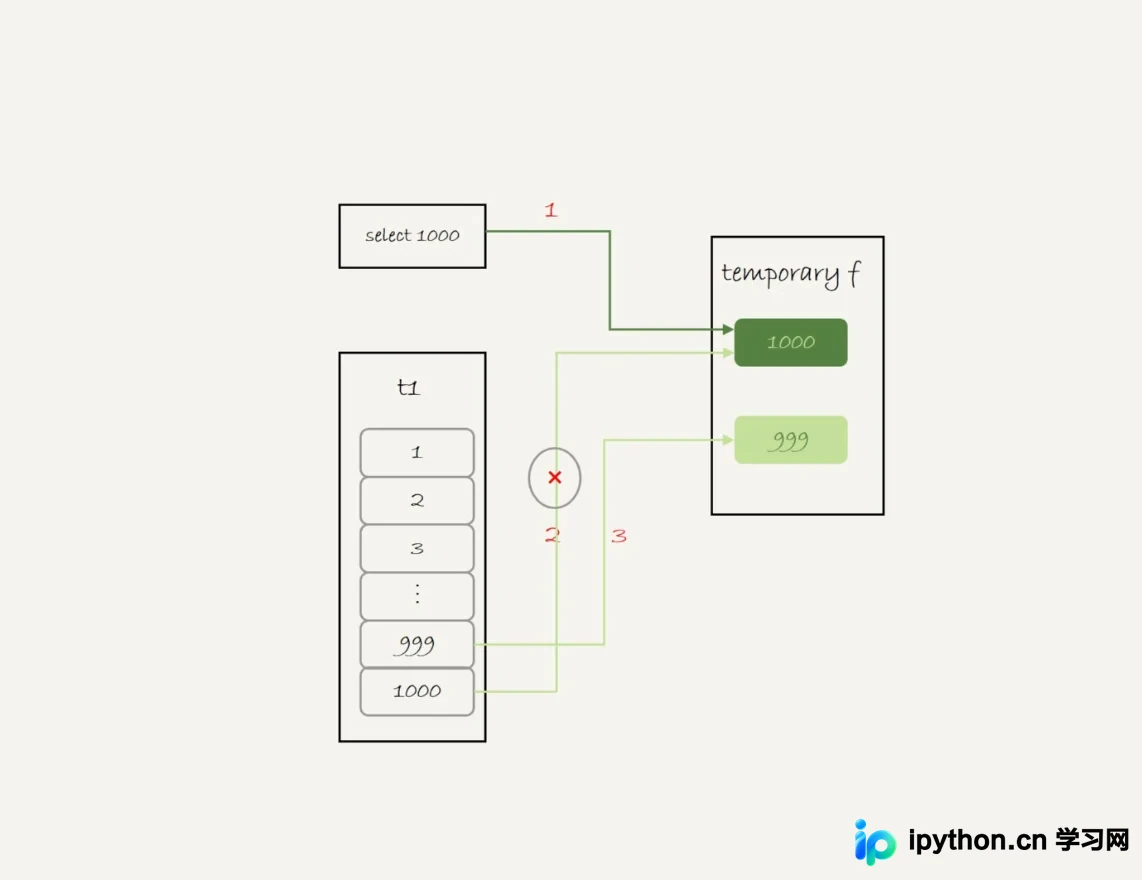
本文深入解析MySQL中内部临时表的触发场景与执行机制,涵盖UNION去重、GROUP BY分组统计及DISTINCT操作。通过EXPLAIN分析展示内存临时表与磁盘临时表的转换条件,并介绍SQL_BIG_RESULT等高级优化技巧,帮助DBA和开发者降低查询延迟,提升数据库性能。
本文详解Python中列表去重的三种实现方式。首先介绍利用内置set类型快速去重但丢失顺序的方法;其次展示不使用set的遍历判断法,分析其在大数据量下的性能瓶颈;最后推荐结合set与列表的混合方案,利用哈希查找优势在保持顺序的同时大幅提升大列表处理效率,并附带相关代码示例与性能对比数据。
本文深入解析Python中二分查找算法的原理与实现,对比递归与循环方式的性能差异。重点介绍bisect模块如何高效维护有序列表,并详细对比其与numpy.searchsorted在普通列表与大型数组场景下的执行效率,为开发者提供实用的性能优化建议。