Python字典核心操作与性能优化指南
本文系统梳理字典的创建、读写、遍历、修改与删除等基础操作,涵盖排序规则、深浅拷贝区别及自定义对象作键条件。结合哈希映射原理,演示如何利用字典将数据查询时间复杂度从O(n)降至O(1),提供符合现代语法的完整示例,助力开发者高效掌握数据结构应用。
2026-10-12
6

本文系统梳理字典的创建、读写、遍历、修改与删除等基础操作,涵盖排序规则、深浅拷贝区别及自定义对象作键条件。结合哈希映射原理,演示如何利用字典将数据查询时间复杂度从O(n)降至O(1),提供符合现代语法的完整示例,助力开发者高效掌握数据结构应用。
本文深入解析Python程序加速运行的核心方法。从基础层面探讨将代码封装为函数、利用局部变量优势、预绑定方法以及使用内置容器等技巧,有效减少属性查找开销。进阶部分介绍PyPy的JIT编译与Numba的LLVM加速技术,并强调在追求性能前确保逻辑正确性的重要性。
本文详细讲解 Python 中如何使用标准库 json 与第三方 simplejson 模块进行 JSON 数据的读写、解析与格式化输出。通过实际代码演示嵌套字典与列表的逐层提取方法,并对比两者在无 C 扩展环境下的序列化效率,帮助开发者在实际项目中合理选择数据交换方案并规避性能瓶颈。
本文详细介绍如何利用 Python 内置的 ctypes 模块无缝调用 C/C++ 编译的动态链接库。通过素数筛选、快速排序及系统标准库调用的完整代码示例,演示类型转换、函数签名声明与性能基准测试方法,帮助开发者在保留 Python 灵活性的同时,有效突破解释器执行瓶颈。
Python通过引用计数与分代算法自动拦截无效内存块。本文拆解底层回收逻辑,演示如何利用生成器惰性计算、显式清理大对象、引入弱引用以及调用性能分析工具进行实操,帮助开发者有效压低运行时内存峰值并杜绝资源泄漏。
针对重复计算导致的高耗时问题,Python 标准库提供的 functools.lru_cache 装饰器通过最近最少使用(LRU)策略自动记录函数调用结果。本文详细拆解参数配置、元数据查看及自定义键值的方法,结合递归数列示例演示如何通过内存换时间实现性能跃升,并明确适用边界。
本文深入解析Pandas中高性能函数eval和query的使用。通过对比NumPy和Pandas内置运算,展示eval在复杂表达式计算中的性能优势,并结合numexpr库说明其底层原理。文章提供具体代码示例,演示如何利用eval和query优化大规模数据集的处理效率,帮助开发者提升数据分析性能。
functools.lru_cache 是 Python 标准库提供的函数级缓存工具,通过记录参数与结果避免重复计算。本文详解 maxsize 与 typed 参数配置,解析最近最少使用(LRU)内存淘汰规则,提供 cache_info 状态监控与 cache_clear 清理操作的完整示例,并结合无副作用纯函数特性说明安全优化场景。
本文详细解析pandas中.loc、.iloc、.at和.iat四种索引方法的语法差异与适用场景。通过对比直接方括号、.loc及设置索引后的.at性能,展示在大规模数据查找中,将列设为索引并使用.at定位可显著提升查询效率。
本文介绍如何使用 Numba 库通过即时编译(JIT)技术显著提升 Python 代码的执行速度。重点讲解 @jit 装饰器的用法、nopython 模式的优势,以及针对 NumPy 数组和循环密集型计算的优化策略,帮助开发者在科学计算场景中实现接近 C 语言的运行效率。
本文介绍Python中两种常用的性能分析工具:%timeit与Line_profiler。通过示例演示如何使用%timeit进行单行或多行代码的性能测试,包括自定义运行次数与循环次数。同时,详细讲解如何安装、加载Line_profiler,并利用%lprun命令进行逐行性能分析,帮助开发者快速定位代码瓶颈。
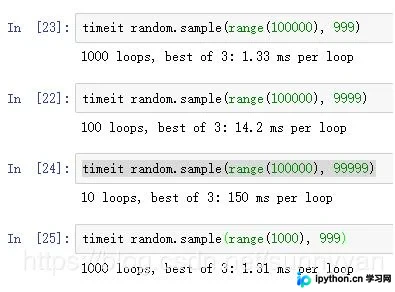
针对Python中random.sample()在大规模数据下执行缓慢的问题,本文介绍了使用numpy.random.choice作为高效替代方案。通过设置replace=False确保无放回抽样,并结合权重参数(weights/cum_weights)实现复杂场景下的随机抽取,显著提升处理效率。