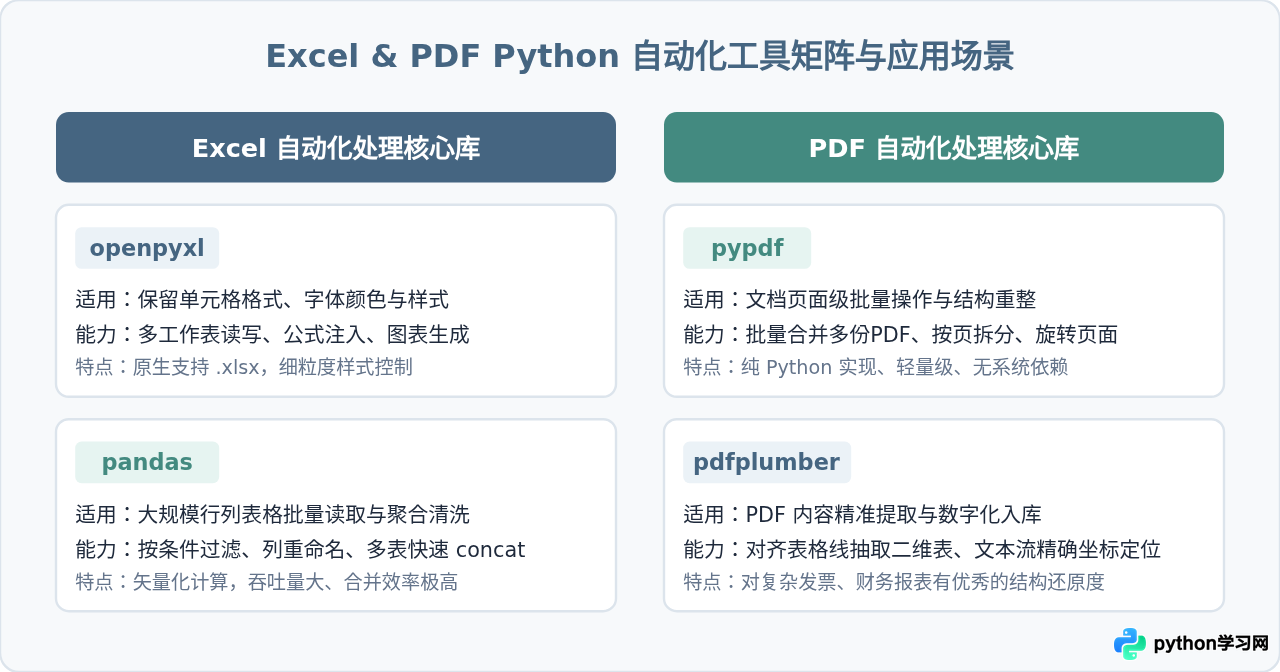
怎么用Python库实现Excel和PDF批量处理自动化
详细讲解如何使用Python主流库实现Excel表格与PDF文件的批量自动化处理,覆盖环境选型、目录遍历、数据清洗合并、页面重组、表格提取以及生产级容错架构设计。
2026-10-22
25


详细讲解如何使用Python主流库实现Excel表格与PDF文件的批量自动化处理,覆盖环境选型、目录遍历、数据清洗合并、页面重组、表格提取以及生产级容错架构设计。
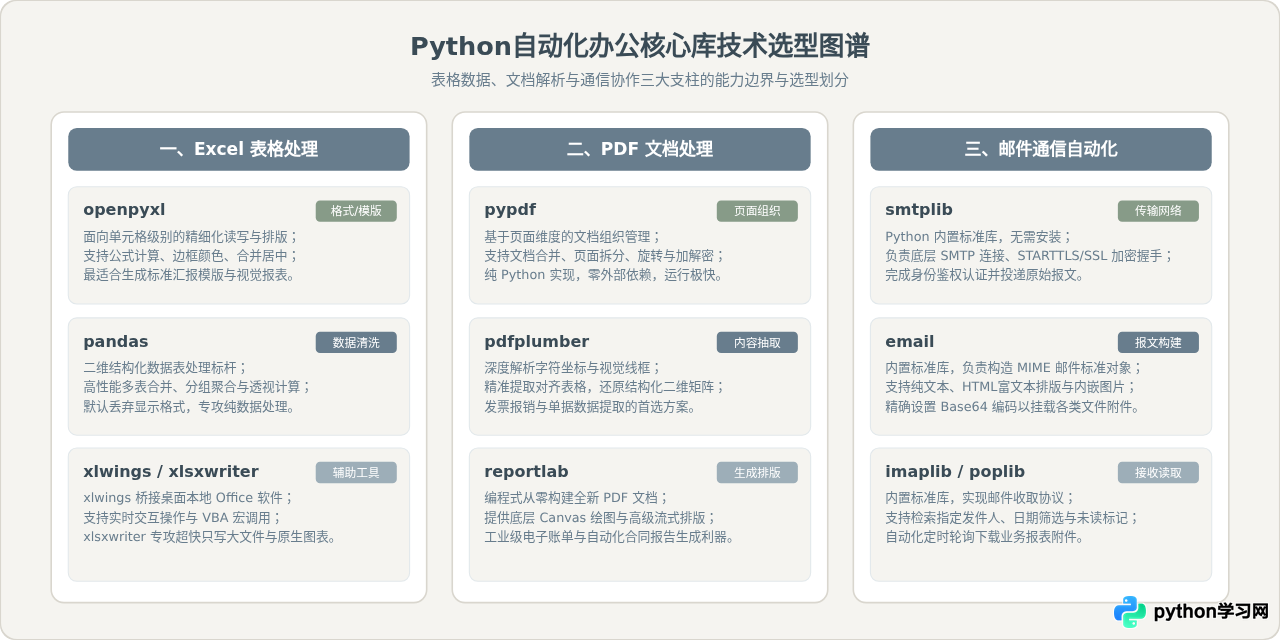
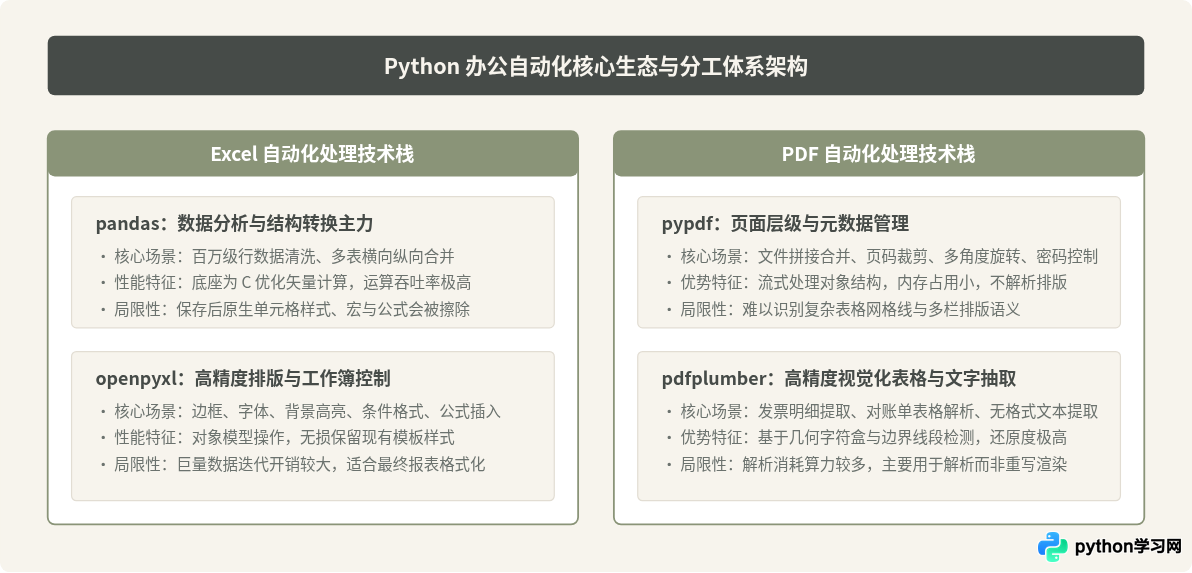
系统汇总Python在Excel表格处理、PDF文档解析与邮件收发三大核心办公场景中的主流库。深度剖析openpyxl与pandas、pypdf与pdfplumber的选型差异与适用边界,提供完整可执行代码示例。
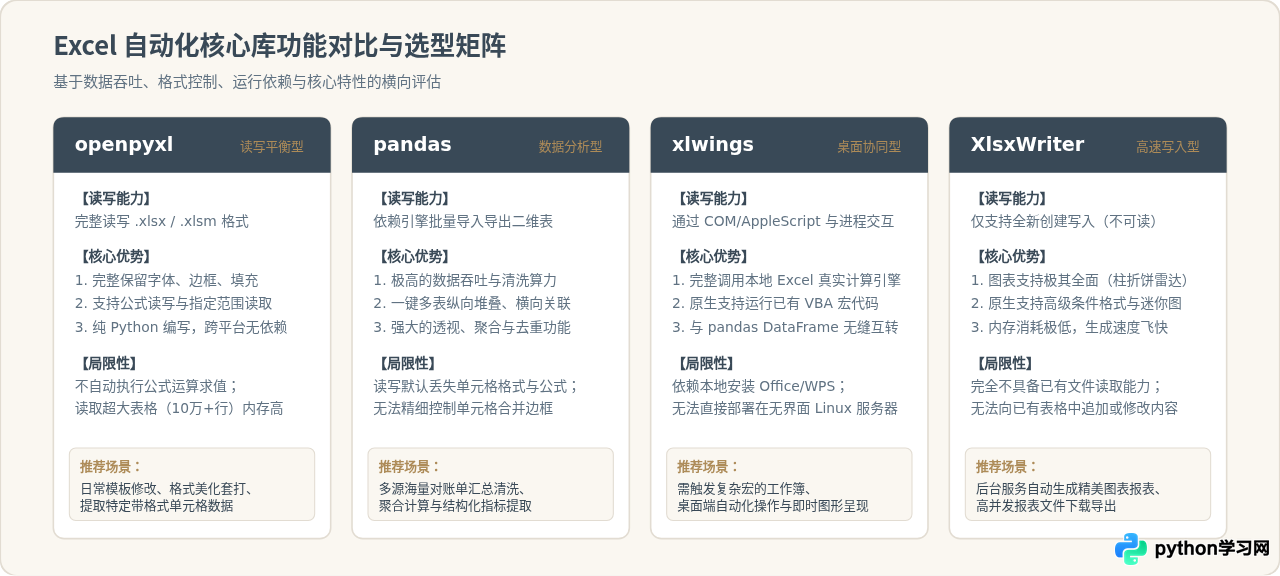
深入解析Python自动化办公核心库,系统对比openpyxl、pandas、xlwings、XlsxWriter以及pypdf、pdfplumber、ReportLab等常用工具的功能特点与适用场景,提供完整的代码示例与选型决策指南。
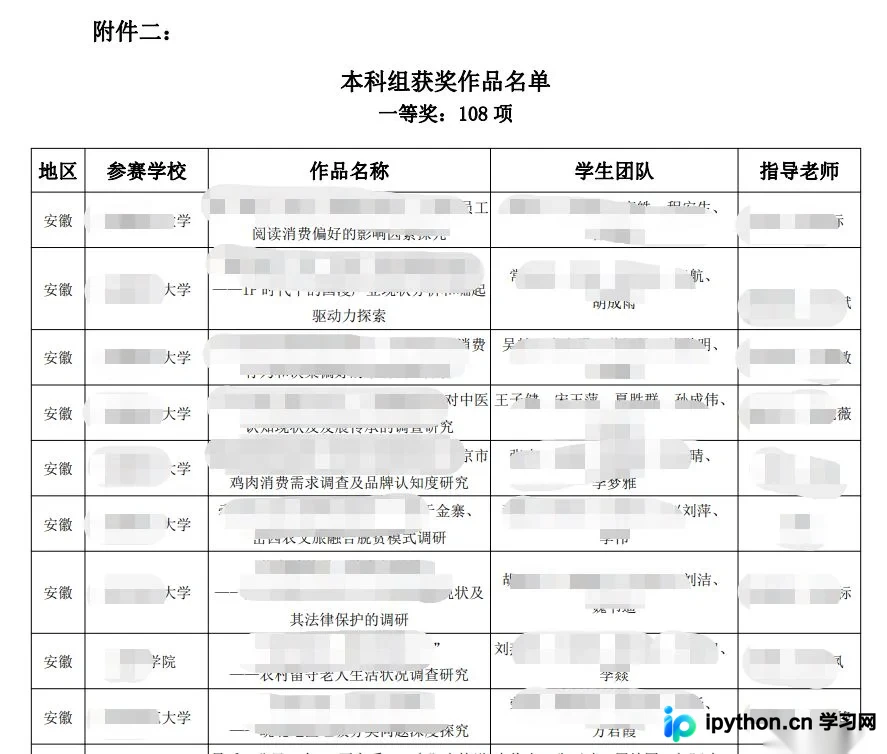
本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
精选30个面向实际业务场景的Python办公自动化脚本,覆盖Excel批量合并、拆分、清洗、排版与PDF合并、抽取、水印、加解密等高频操作,提供即拷即用的工程化代码与避坑指南。
本文通过两个真实需求,演示如何使用Python提取PDF中指定内容并生成新文件。需求一提取包含特定文字“战略”的页面并合并,需求二提取包含图片的页面并单独保存。文章详细梳理了PyPDF2、pdfplumber和fitz模块的逻辑,提供了完整的代码实现,并提示图片识别方法的局限性。
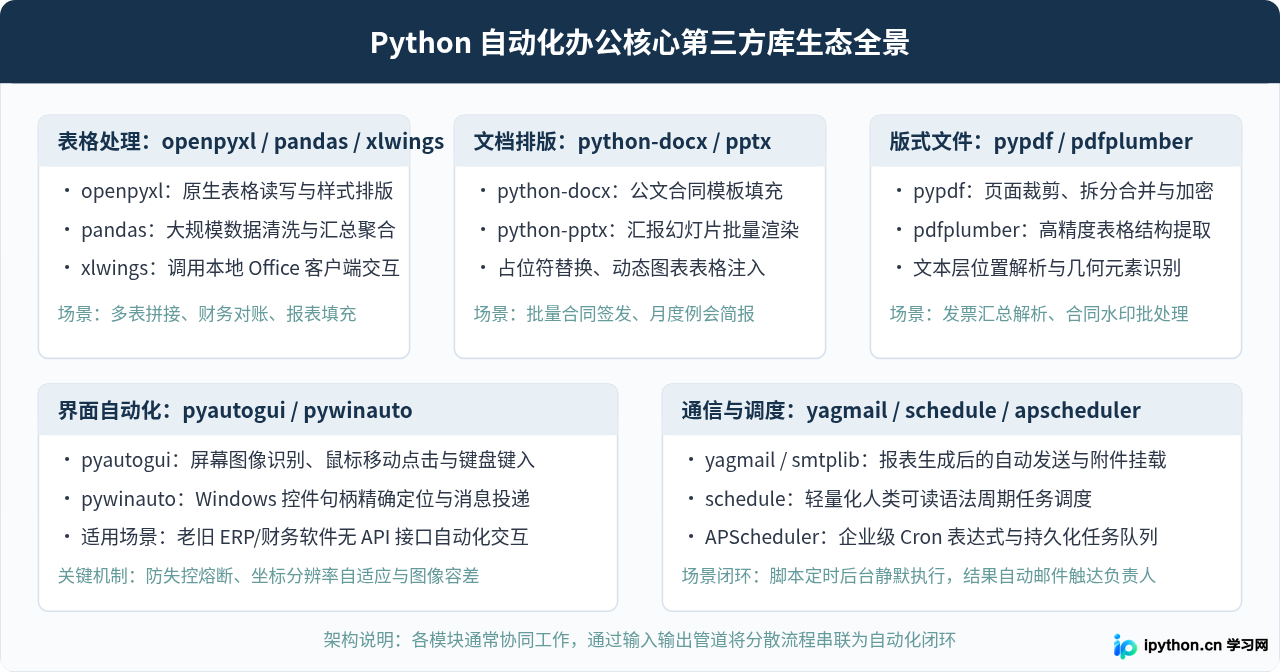
全面梳理Python自动化办公常用第三方库清单及其实际应用场景,涵盖Excel表格、Word文档、PDF处理、PPT演示文稿、自动化邮件与RPA键鼠控制,提供场景选型依据与实用代码示例。
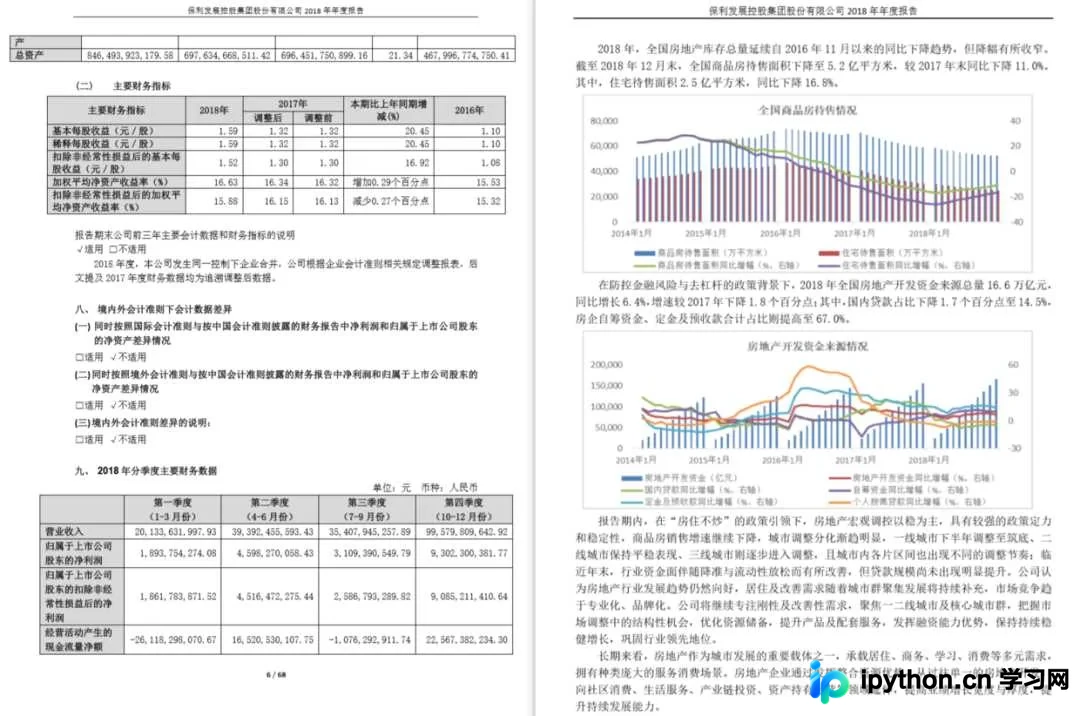
本文详解Python中利用pdfplumber库进行PDF文件处理的全流程。重点介绍如何安装配置该库,掌握open()、extract_text()及extract_tables()等核心API的使用。通过代码示例展示文本与表格的精准提取方法,并解析Page对象的属性与参数配置,帮助开发者高效解决PDF内容解析需求。
本文介绍如何使用Python的pdfplumber库提取PDF中的表格数据。通过安装模块、导入库、打开文件并调用extract_table()函数,可将表格转换为Pandas数据框。文章还涵盖了单页提取与多页批量处理的代码示例,并提醒注意表格边框及换行对识别结果的影响。