Python使用pandas和csv向文件写入或追加数据的完整指南
介绍在Python中如何利用pandas库和标准csv模块向CSV文件写入初始数据或安全追加新记录。涵盖核心参数配置、不同数据结构的转换方法、按行追加的正确姿势,以及追加列的通用逻辑,提供可直接运行的代码示例与注意事项。
2026-10-11
7

介绍在Python中如何利用pandas库和标准csv模块向CSV文件写入初始数据或安全追加新记录。涵盖核心参数配置、不同数据结构的转换方法、按行追加的正确姿势,以及追加列的通用逻辑,提供可直接运行的代码示例与注意事项。
本文详解pandas中df.dropna()函数的使用,涵盖Series和DataFrame的缺失值删除。重点解析axis、how、thresh、subset和inplace等关键参数,通过具体代码示例展示如何灵活处理不同场景下的NaN数据,帮助开发者高效清理数据。
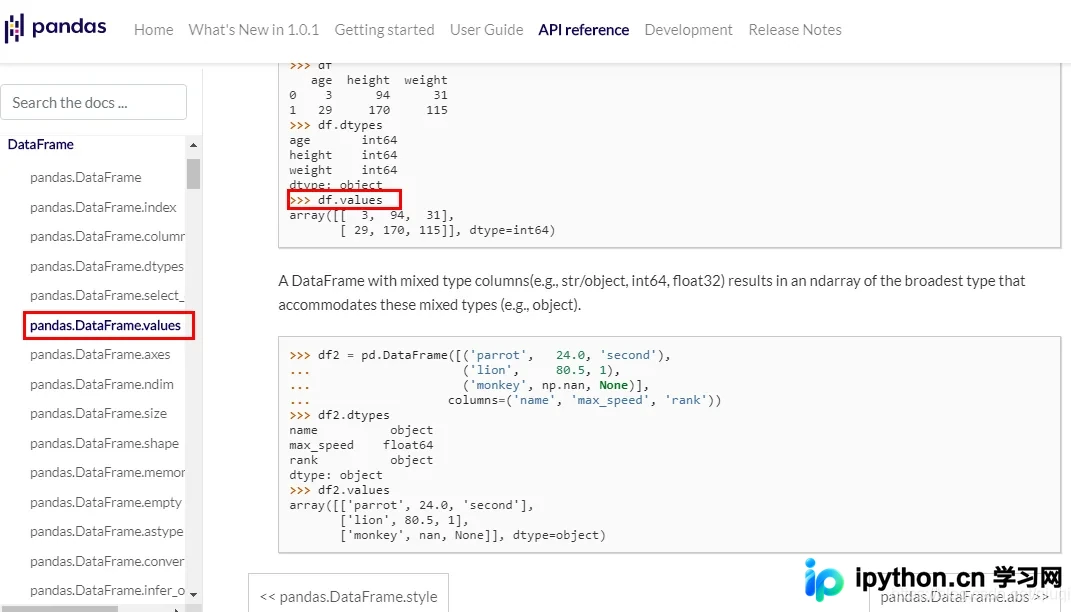
在使用 pandas 处理数据时,常见因版本迭代引发的 as_matrix 缺失报错,以及将多值数组强行存入单单元格导致的 type 类型转换错误。本文通过核查版本替换 values 属性,演示将多维数据拆分为独立列以修正数据类型的方法,配合 .info() 验证与文件读取操作,快速恢复代码正常运行。
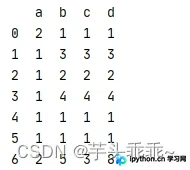
本文介绍在pandas中统计DataFrame重复值次数的两种核心方法。通过duplicated()标记重复行,结合布尔索引筛选并统计数量;或利用drop_duplicates()计算去重前后的行数差值。文章包含完整的代码示例与结果解析,帮助快速处理数据清洗中的重复项问题。
Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。
本文针对Excel数据批量处理效率低的问题,提供基于Python Pandas库的标准操作流程。通过读取指定工作表与表头、过滤筛选特定行列、填补缺失值及转换日期数值类型完成数据清洗;结合分组聚合多维透视与排序排名进行核心分析;最后输出处理后的DataFrame至新文件中。掌握这些方法可显著提升数据分析自动化水平。
本文介绍在Pandas中将单列数据按分隔符拆分为多列的多种方法。通过str.split()结合expand参数、索引提取或解包赋值,可高效完成数据清洗。同时涵盖处理列表数据及生成测试数据的技巧,帮助开发者快速实现列拆分操作。
本文介绍如何使用 Pandas 库对 DataFrame 进行按行计算百分比(比例)的操作。通过结合 `sum()` 与 `div()` 方法,并正确指定 `axis` 参数,可以快速实现数据在行维度上的归一化处理,适用于不同月份或类别数据的比例分析。
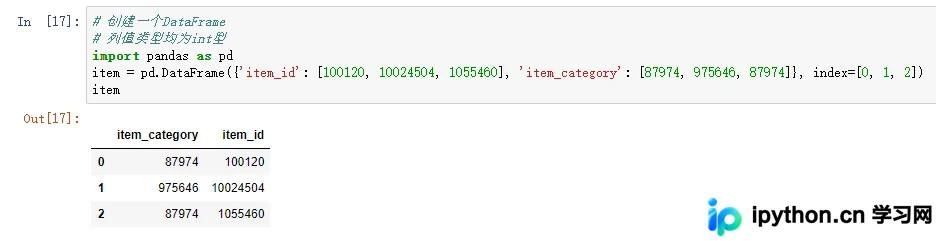
本文详细解析了如何将Python Pandas中的DataFrame转换为字典。通过处理商品ID与类别的一对多映射关系,演示了数据类型转换(int转str)以及利用set_index和to_dict方法实现高效映射的具体步骤。
掌握Pandas中DataFrame.replace()函数的核心参数与多种替换场景。本文通过单值、字典映射、列表对应及正则表达式四个实操步骤,演示如何高效清洗数据并规避原地修改的风险,助力Python数据分析流程更稳定。
Pandas 能够高效完成类 SQL 的数据处理任务。本文详细演示如何通过 Pandas DataFrame 实现 SELECT 字段选择、WHERE 条件过滤、GROUP BY 分组聚合以及 LIMIT 限制行数等操作,并提供对应的 Python 代码示例与结果对照,帮助开发人员在非关系型数据库环境中快速完成表格数据查询。
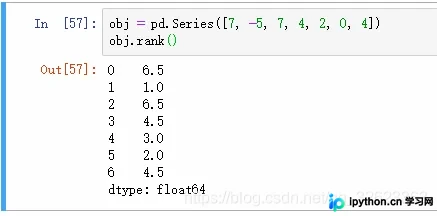
本文详解pandas中Series与DataFrame的rank排名函数。内容涵盖默认平均排名原理、利用method参数自定义并列值处理策略、设置降序排列以及指定数据框行列维度的完整操作指南,帮助开发者快速掌握数据位次计算与标准化处理方法。