

pandas DataFrame groupby分组聚合与reset_index重置索引详解
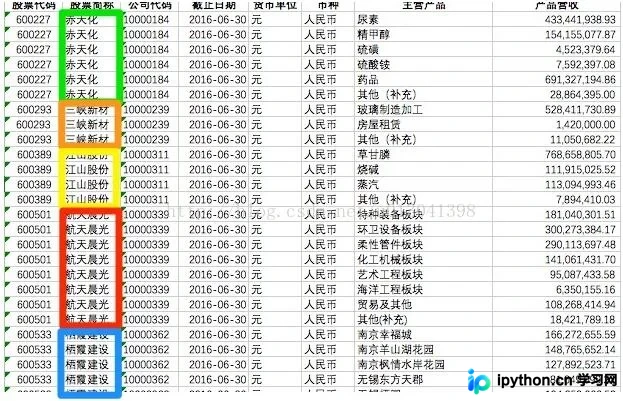
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
2026-10-13
7

本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
本文介绍在Python中使用Pandas处理数据时,将DataFrame对象转换为NumPy数组的具体方法。通过调用DataFrame的values属性,可以高效获取底层数组数据,适用于需要高性能数值计算的场景。
本文系统介绍Pandas中DataFrame的核心操作方法。涵盖loc、iloc等索引机制,详解行与列的增删改查技巧,包括条件筛选、isin、where及sample抽样。通过具体代码示例演示如何高效处理数据框,适用于Python数据分析初学者与进阶用户。
本文介绍在pandas DataFrame中查找特定值所在行列的方法。通过遍历索引和列索引,或使用列表推导式,可以定位目标值的位置。示例展示了如何遍历demo_df数据框,查找值为'fox'的元素,并输出其行索引和列索引。
本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
本文介绍Python中利用Pandas库将DataFrame转换为Matrix的方法。通过示例展示如何创建DataFrame,并使用.values和as_matrix(columns=None)属性提取底层矩阵数据,供开发者参考。
本文详解Python Pandas中DataFrame的行列选择与切片方法。对比loc、iloc、at、iat及ix函数的用法,说明基于标签与位置索引的区别。通过实例展示正确与错误的代码写法,总结各方法的适用场景及常见错误,帮助开发者高效进行数据筛选。
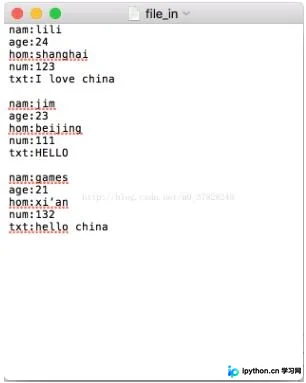
本文介绍如何使用Python和Pandas库,将包含“类别:内容”格式的纯文本文件转换为结构化的DataFrame表格。通过遍历文件行、利用冒号分割键值对并构建字典,最终生成包含指定列名的DataFrame对象,实现从非结构化数据到表格数据的便捷转换。
本文介绍在pandas中如何将DataFrame转换为Series,以及利用astype方法结合numpy模块修改列中值的数据类型。通过具体代码示例展示了创建Series时指定索引的技巧,以及使用np.int64等类型参数进行数据格式转换的实际操作,适用于需要处理数据格式的场景。
本文介绍在pandas中一次性删除DataFrame多个列的方法。通过对比使用index直接删除的错误尝试,引出利用df.drop结合df.columns索引的正确做法,演示如何指定axis=1并应用inplace=True参数,确保输出结果符合预期,帮助开发者避免常见误区。
本文介绍如何使用pandas库中的set_index方法将DataFrame的指定列转换为行索引,支持单列及多列层次化索引。同时讲解reset_index方法,用于将层次化索引级别还原为普通列,并展示索引与列名的变化细节。
本文介绍如何在 Python 的 Pandas 库中调整 DataFrame 的列顺序。通过提取目标列、删除原列并使用 insert 方法插入至指定位置,实现将特定列(如 id)移至最前的操作。该方法简洁有效,适用于需要重新排列数据表结构的场景。