

Python读取文本数据并转换为DataFrame的完整流程

发布时间:2026-10-13| 6人浏览过
本文介绍如何使用Python和Pandas库,将包含“类别:内容”格式的纯文本文件转换为结构化的DataFrame表格。通过遍历文件行、利用冒号分割键值对并构建字典,最终生成包含指定列名的DataFrame对象,实现从非结构化数据到表格数据的便捷转换。
在技术社区中,这类问题较为常见,因此单独撰写文章进行详细说明。
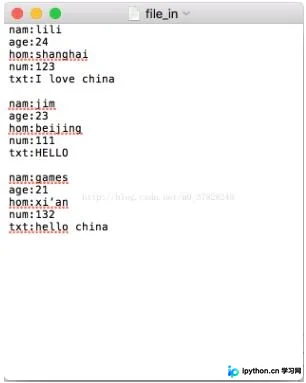
首先,从纯文本文件“file_in”中读取原始数据,其具体格式如下所示:
目标是将上述数据输出为“file_out”,其期望格式如下:
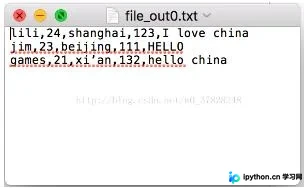
原始数据的结构为“类别:内容”,条目之间以空行(\n)分隔。转换的目标是将每个条目单独占一行,并严格按照类别顺序依次列出对应内容。
建议在读取数据后,利用pandas库将其构建为DataFrame表格格式,以便后续更高效地处理数据。由于原始格式并非标准的表格形式,因此需要进行初步的数据清洗和结构化处理。
#coding:utf8
import sys
from pandas import DataFrame  #DataFrame通常来装二维的表格
import pandas as pd      #pandas是流行的做数据分析的包
#建立字典,键和值都从文件里读出来。键是nam,age……,值是lili,jim……
dict_data={}
#打开文件
with open('file_in.txt','r')as df:
  #读每一行
  for line in df:
    #如果这行是换行符就跳过,这里用'\n'的长度来找空行
    if line.count('\n') == len(line):
      continue
    #对每行清除前后空格(如果有的话),然后用":"分割
    for kv in [line.strip().split(':')]:
      #按照键,把值写进去
      dict_data.setdefault(kv[0],[]).append(kv[1])
#print(dict_data)看看效果
#这是把键读出来成为一个列表
columnsname=list(dict_data.keys())
#建立一个DataFrame,列名即为键名,也就是nam,age……
frame = DataFrame(dict_data,columns=columnsname)
#把DataFrame输出到一个表,不要行名字和列名字
frame.to_csv('file_out0.txt',index=False,header=False)
以上即为Python读取文本数据并转化为DataFrame的完整示例,希望能为读者提供有价值的参考,同时也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









