pandas DataFrame 删除重复行的方法详解
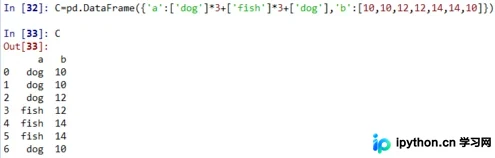
本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。
2026-10-13
6

本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。
本文介绍如何在Python Pandas中向DataFrame指定位置添加列。对比直接赋值和concat()只能在末尾添加的局限,重点讲解利用reindex()方法通过columns参数控制列顺序,并使用fill_value指定新列值,实现灵活插入单列或多列。
本文介绍如何使用Python读取通达信股票数据文件(.day)。通过struct模块解析二进制数据,处理日期、价格及成交量字段,最终将结果封装为pandas DataFrame对象,便于后续数据分析与处理。
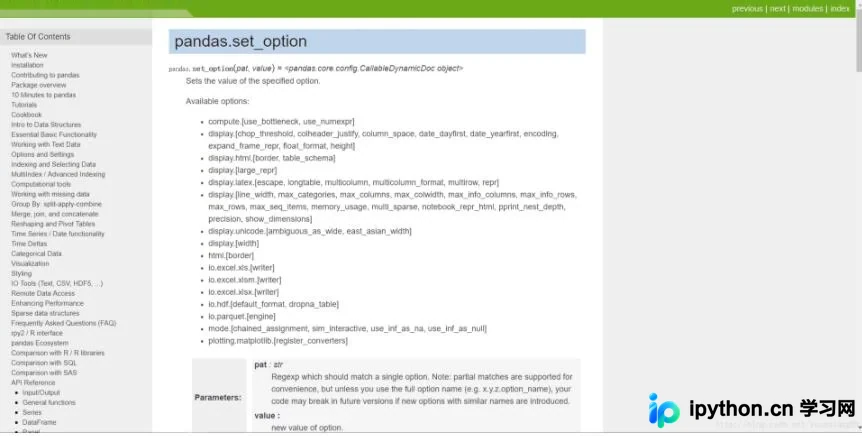
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
本文介绍如何使用Pandas库中的apply函数对DataFrame指定列进行批量条件赋值。通过定义自定义函数并结合lambda表达式,实现如数值大于等于阈值赋1、否则赋0的逻辑,帮助开发者高效处理数据清洗与特征工程中的条件转换任务。
本文介绍如何利用pandas库中的sort_index方法对DataFrame进行索引排序。通过创建示例数据框并调用该函数,展示如何按索引值升序排列数据,适用于需要依据特定索引顺序处理数据的场景。
本文介绍在Pandas中通过merge和join函数按索引合并数据集的方法。重点讲解merge函数利用left_index和right_on参数处理非索引键的合并,以及join函数默认基于索引合并及多DataFrame同时合并的操作。通过具体代码示例展示outer模式下的数据对齐结果,帮助开发者掌握不同场景下的最佳实践。
本文详解pandas中DataFrame的行列索引操作。涵盖获取index与columns、使用rename灵活修改索引(支持部分修改与inplace参数),以及数据选取技巧。重点对比直接索引、.loc(标签)与.iloc(整数下标)的区别,并介绍布尔索引与混用方法.ix的使用场景与注意事项。
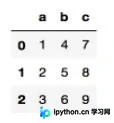
本文介绍了Python中Pandas库下Series和DataFrame的基本创建方式。通过示例代码展示了如何利用列表生成Series,以及如何结合日期索引与随机数矩阵构建DataFrame,并输出运行结果供参考。
本文介绍了如何在Python中使用Pandas库创建一个空的DataFrame,并通过循环方式逐步添加数据。主要展示了两种初始化空DataFrame的方法:无参数初始化和指定列名初始化,以及利用append方法将新数据帧合并到现有空数据帧中,实现动态赋值。
本文介绍在 pandas 中如何删除或选取包含特定数值的行和列。通过 isin 与取反操作筛选特定值行,利用 enumerate 定位特定值列并 drop 删除。针对空值,先使用 fillna 赋予特定标识值,再复用前述逻辑进行剔除,提供完整代码示例与运行结果参考。
本文介绍如何在Pandas中高效提取包含特定字符串的DataFrame数据。通过演示使用str.contains方法结合正则表达式(如处理点号需转义),生成布尔索引并直接筛选,实现精准数据过滤。