

Pandas DataFrame 缺失值检测与填充实战指南
本文详解如何在 Pandas DataFrame 中检测列是否存在空值,并通过 isnull() 与 any() 组合返回 Series 结果。介绍将检测结果转化为 DataFrame 以筛选非空列的方法,以及针对特定列如 nkill 提取含空值记录的技巧。最后演示使用 fillna() 进行原地填充,支持指定数值或统计量(如中位数),并强调 inplace=True 参数对原数据直接修改的作用。
2026-10-13
6

本文详解如何在 Pandas DataFrame 中检测列是否存在空值,并通过 isnull() 与 any() 组合返回 Series 结果。介绍将检测结果转化为 DataFrame 以筛选非空列的方法,以及针对特定列如 nkill 提取含空值记录的技巧。最后演示使用 fillna() 进行原地填充,支持指定数值或统计量(如中位数),并强调 inplace=True 参数对原数据直接修改的作用。
本文介绍如何在 pandas 中创建一个空的 DataFrame 并预先定义列名。通过构建包含基础字段、动态列表及特定标识的列名数组,并将其传递给 DataFrame 构造函数,即可实现快速初始化。该方法适用于需要预设数据结构后续填充数据的场景。
本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
本文介绍了在Python中使用Pandas读取MySQL数据库数据并转换为DataFrame的两种主要方法。第一种方式基于SQLAlchemy引擎,适用于Pandas 1.9及后续版本,通过配置连接参数建立引擎后执行SQL查询;第二种方式利用MySQLdb直接连接数据库进行数据获取。文章提供了具体的代码示例和注意事项,帮助开发者根据项目需求选择合适的技术方案。
在使用pandas读取CSV文件时,常因索引列处理不当出现“Unnamed: 0”列。本文介绍利用列索引重命名或drop方法处理此类冗余列的技巧,并汇总了DataFrame选取行与列的多种常用方法,包括切片、索引器及特定行/列获取函数,帮助提升数据处理效率。
本文介绍在Python Pandas中如何处理DataFrame的多列去重及差集运算。通过drop_duplicates方法指定subset参数实现基于多字段的去重;利用append合并数据后再次调用drop_duplicates并设置keep=False,可高效去除两个数据框中重复的行,保留唯一差异记录。
本文介绍使用 pandas 将字典转换为 DataFrame 的方法。当字典值为标量时直接转换会引发 ValueError 错误,可通过指定 index 或将字典放入列表两种方式进行修正,确保数据正确生成表格结构。
本文介绍利用Pandas库实现多列同元素去重的方法。通过合并列、排序字符并拼接,再执行唯一性筛选,可高效去除顺序不同但内容相同的重复行。适用于数据清洗场景,代码简洁且执行速度快,适合处理大规模表格数据。
本文介绍在 pandas 中选取指定列的两种常用方法。通过定义列名列表,利用 DataFrame 的 columns 参数或方括号索引,可快速提取包含名称、收盘价及日期等字段的子集,适用于数据预处理与特征工程场景。
本文介绍如何利用Python的pandas库,将一维列表按固定长度切分后转换为二维DataFrame。通过示例代码展示从列表定义、循环切片、矩阵转置到最终生成DataFrame的完整流程,适用于需要将长列表重组为表格结构的场景。
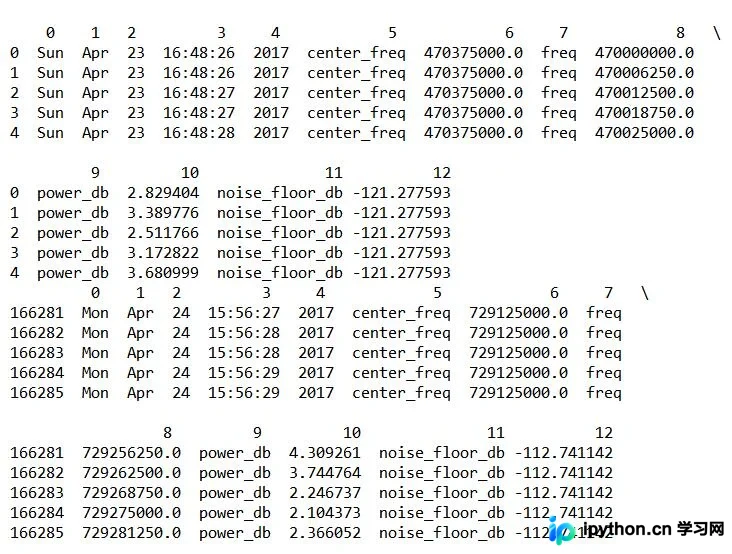
本文介绍如何利用Python的Pandas库高效处理大型CSV文件。通过实例演示从Linux终端数据重定向保存,到使用pandas.read_csv读取、查看前后行数据,以及自定义列索引的全过程。涵盖分隔符设置、header参数及names重命名技巧,帮助开发者快速掌握大数据量下的CSV处理方案。
本文详细介绍Python中pandas模块DataFrame的多种创建方式,包括通过列表、字典及Numpy数组构建数据框。解析DataFrame的双索引机制及其与Series的关系,并提供代码示例,帮助开发者快速掌握数据框的初始化技巧。