

pandas高效创建新Dataframe并批量添加多行的方法
本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
2026-10-13
6

本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
在使用Pandas处理CSV文件时,Excel中的空白单元格可能被解析为空字符串而非NaN,导致dropna()或fillna()失效。本文介绍通过正则替换空字符串为NULL,并在read_csv中指定na_values参数将其识别为缺失值,从而正确执行缺失值处理的操作流程。
本文介绍了在Python中使用Pandas库创建空DataFrame的两种常见方法。通过指定列名初始化一个无数据的DataFrame,以及直接创建完全空的DataFrame对象。文章提供了具体的代码示例和输出结果,帮助开发者快速掌握数据结构的初始化技巧,适用于需要预先定义数据结构或进行数据处理的场景。
本文介绍利用Python的glob模块批量获取文件夹下的TXT文件列表,并通过编码处理和合并操作将所有内容写入单一文件,最终使用Pandas读取为DataFrame格式进行后续计算分析。
本文详细介绍Python标准库中的日期时间数据类型,包括datetime、timedelta及calendar模块的使用。重点讲解字符串与datetime对象的相互转换方法,涵盖标准库函数、dateutil.parser及pandas.to_datetime。此外,深入解析pandas中基于时间戳索引的Series与DataFrame操作,包括算术运算对齐、索引选取、切片技巧以及处理重复索引时的聚合方法。
本文系统介绍Python pandas库的常用函数,涵盖文件读取、数据预处理、筛选、运算排序及统计聚合等核心功能。详细解析read_csv、merge、drop_duplicates等关键方法,帮助开发者高效完成数据清洗与分析任务。
本文探讨Python可视化库Bokeh在Web应用中的实际应用。针对Pandas数据需通过网页动态显示且Matplotlib保存图像不便的需求,对比了Seaborn、Plotly等工具后,选定Bokeh作为解决方案。文章详细阐述了利用Bokeh与Jinja2集成,通过Flask框架传递参数并在HTML中直接渲染交互图表的完整流程,涵盖图像生成、后端传参及前端调用三个核心步骤。
本文介绍在Python中将网络文本数据直接加载到本地内存的四种常用方法。通过对比urllib、requests结合StringIO、numpy.genfromtxt以及pandas.read_csv的实现方式,展示如何高效获取远程CSV文件并转换为矩阵或DataFrame结构,适用于机器学习数据预处理场景。
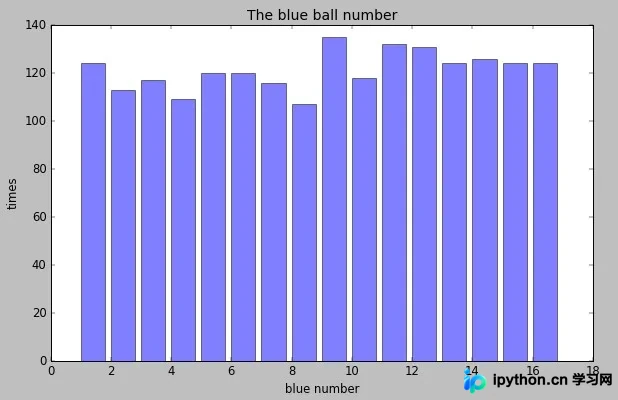
本文基于Python环境,利用Pandas和Matplotlib库对双色球历史开奖数据进行蓝球与红球的频率统计分析。通过读取CSV格式的历史数据,分别统计蓝球和红球的出现次数,并生成直方图直观展示高频号码。代码示例展示了数据清洗、分组统计及绘图的全过程,为彩民或数据分析爱好者提供实用的参考脚本。
本文介绍如何使用Python的Pandas库将数据按固定时间间隔(如5秒)分割为相等的时间块,并统计每个块内特定字段(如IP地址)的出现频数。通过解析日期格式、生成时间范围索引及切片计算,实现高效的数据处理。
本文介绍在Python中读取CSV文件并剔除指定列后写入新文件的两种实现方式:原生文件IO循环处理与Pandas DataFrame操作。通过对比27万至110万条数据的处理耗时,结果显示Pandas方案在大数据量下效率提升约30%,逻辑更清晰且性能更优。
本文详解Python中CSV文件的读取与写入方法。通过鸢尾花数据集示例,演示如何将CSV直接转换为Dict列表或DataFrame对象。针对大数据量场景,提供逐条处理并写入的建议,以及使用writerows批量写入的技巧。此外,还涵盖从Zip压缩包中直接读取CSV、DataFrame导出CSV以及TXT文件转换等实用代码片段,帮助开发者高效处理结构化数据。