

Python批量读取TXT文件并转换为DataFrame的方法

发布时间:2026-10-13| 6人浏览过
本文介绍利用Python的glob模块批量获取文件夹下的TXT文件列表,并通过编码处理和合并操作将所有内容写入单一文件,最终使用Pandas读取为DataFrame格式进行后续计算分析。
在处理数据时,我们常遇到需要批量处理同一文件夹内多个文件的情况,并希望将这些文件的内容整合到一个文件中以便进行后续的计算和操作。例如,面对一系列如截图所示的txt文件,我们需要找到一种方法将它们合并写入一个txt文件,并进一步读取为DataFrame格式。
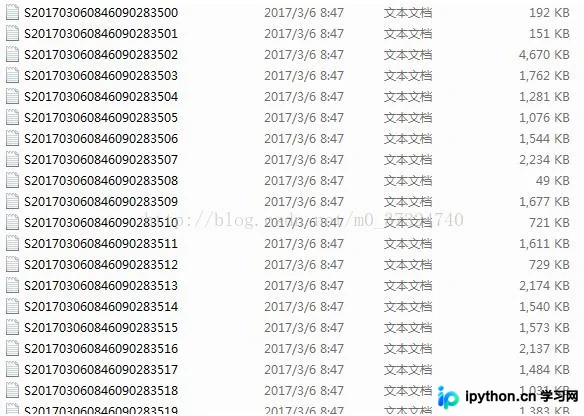
实现这一目标的第一步是使用Python内置的glob模块,该模块在处理文件路径匹配方面非常高效且实用。
glob.glob('*.txt')
执行相关操作后,我们将获得如下结果展示:
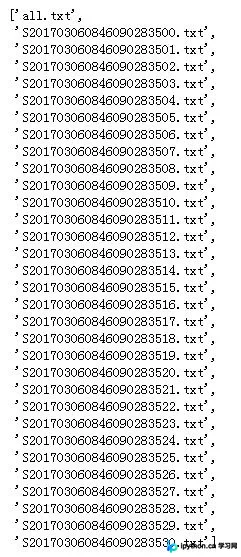
最终生成的all.txt文件包含了所有处理后的内容。从返回结果可以看出,这是一个包含txt文件名称的列表。需要注意的是,如果指定文件夹下仅包含txt文件,使用os.listdir()函数也能得到相同的结果列表。
在读取文件时,关键在于注意txt文件的编码格式(可通过Notepad++等编辑器查看)以及数据之间的间隔符形式。完整的实现代码如下:
import os
import pandas
import codecs
import glob
import pandas as pd
os.getcwd()
os.chdir('D:\AAAASXQ\python study\data preprocessing')
def txtcombine():

 files = glob.glob('*.txt')

 all = codecs.open('all.txt','a')

 for filename in flist:
 print(filename)
 fopen=codecs.open(filename,'r',encoding='utf-8')
 lines=[]
 lines=fopen.readlines()
 fopen.close()
 i=0
 for line in lines:
  for x in line:
  all.write(x)
 #读取为DataFrame格式
 all1 = pd.read_csv('all.txt',sep=' ',encoding='GB2312')
 #保存为csv格式
 all1.to_csv('all.csv',encoding='GB2312')

if __name__ == '__main__':
 txtcombine()
以上即为Python批量读取txt文件并转换为DataFrame的完整方法分享,希望能为读者提供参考,欢迎支持本站获取更多技术内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









